2026年7月~9月の連続温度計測が示す今年の夏——データが語る季節の移ろいと微気象の世界

2026年7月から9月にかけて特定の地点で実施した連続温度計測データをもとに、今年の夏の気候を技術的な視点から振り返ります。7〜8月のピークから9月に入った瞬間の急激な温度低下など、実測ロガーならではの鮮明な波形を提示。気象庁のマクロなデータと身近な微気象データの比較を通して、データ解析が明かす季節の変化と定点観測の魅力をお届けします。

はじめに:昨年の記憶と「今年の夏」の体感

昨年の夏を振り返ると、いつまでも終わらない猛暑や、秋になっても衰えない残暑の厳しさが強く記憶に残っている。連日ニュースで報じられる過酷な暑さに、「今年の夏は一体どうなってしまうのか」と気疲れした方も多いのではないだろうか。

では、それに比べて今年の夏(2026年)はどのような季節だっただろうか。世間一般の印象としては、「去年に比べると、何となく早い時期に夏がスッと終わった気がする」「ある意味で、昔ながらの平均的な夏だったのでは」と感じている人も少なくないはずだ。

こうした季節の体感を、感覚だけでなく「実際のデータ」として捉えてみると、今年の夏の輪郭がより鮮明に浮かび上がってくる。今回は、市販のロガーと自作の熱電対配線による測定システムを用いて、2026年7月から9月にかけて独自に取得した連続温度データをもとに、今年の夏の気候を紐解いていこう。


グラフが描く2026年夏:7月・8月のピークから9月の急降下へ

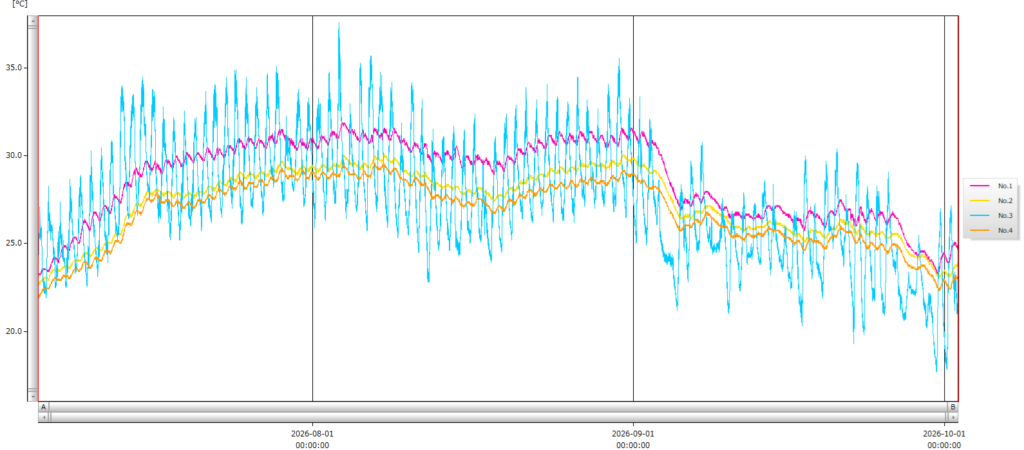
今回分析するのは、2026年7月1日から10月1日までの約3ヶ月間にわたり、特定の地点で連続計測された4チャンネル(No.1〜No.4)の温度データである。

グラフ全体を俯瞰すると、興味深い傾向といくつかの明確な特徴が見えてくる。

  1. 7月〜8月の推移とピーク
  • 7月に入るとともに温度は右肩上がりに上昇し、7月中下旬から8月中旬にかけて年間を通じた最高水準のプラトー(高止まり)を形成している。
  • 特に水色の線で示されたチャンネル(No.3)は、日中の日射や周囲の熱的影響を強く受けているとみられ、日々の温度変動(振れ幅)が非常に大きく、ピーク時には35℃を超えるような高い数値を示している。
  • 一方、ピンク(No.1)や黄色(No.2)といった比較的安定した環境にあるチャンネルは、日々の大きな乱高下をマイルドに受け止めながら、30℃前後のラインを推移している。
  1. 9月に入ってからの劇的な変化
  • グラフ上の大きな転換点は、9月1日の境界線を過ぎたあたりから訪れている。
  • それまで連日維持されていた30℃超のピークが明らかにトーンダウンし、グラフ全体の波形が下方へとシフトしているのがわかる。
  • 特に9月中旬以降は、最低気温・最高気温ともに一段階低い水準へと移行し、9月下旬から10月初めにかけては、最低気温が22〜23℃前後、最高気温も30℃を下回る日が明確に増加している。

昨年の夏が「いつまでも引きずるような暑さ」だったのに対し、今年のデータは、9月に入ると同時に季節のギアが明確に切り替わり、比較的スムーズに秋へと移行したことを物語っている。


気象庁データとの比較:マクロな視点とミクロな実測値

この実測データを、気象庁が発表している2026年夏の全国的な気象傾向と比較してみると、さらに興味深い事実が見えてくる。

気象庁の発表によると、2026年の夏(6〜8月)の日本の平均気温は平年を大きく上回り、統計開始以来上位に入る記録的な高温となった。西日本を中心に高気圧に覆われる日が多く、各地で「酷暑日」が観測されるなど、マクロな気象統計としては非常に厳しい暑さの夏であったことは間違いない。

しかし、今回の特定の地点における実測ロガーデータに目を向けると、気象庁の「全国的な記録的高温」という大枠のトレンドと合致しつつも、日々の生活空間や特定の設置環境における「実際の熱の抜け方」の早さが浮き彫りになる。

気象庁の広域的なアメダスデータや平均値では均されてしまう「局所的な日射の影響」「夜間の放射冷却による急激な温度低下」、そして「9月に入ってからの空気感の明確な変化」が、自作の熱電対・ロガーシステムによる高頻度サンプリングによってリアルに捉えられている。つまり、マクロな気象情報が示す「今年の暑さの総量」と、ミクロな実測データが示す「肌感覚としての季節のスピード感」の間には、緻密なグラデーションが存在しているのだ。


ロガー情報が教えてくれるもの:微気象データ解析の奥深さ

市販のロガーに熱電対を組み合わせ、自前のシステムで特定の地点の温度を長期間追いかける。こうした地道な観測を行っていると、気象庁の天気予報や一般的な気象データだけでは見えてこない、さまざまな「細部」に気づかされる。

  • どの時間帯に熱がこもりやすいのか
  • 周囲の環境(コンクリート、土、植生など)によって、どのように熱の引き方が違うのか
  • カレンダー上の季節の変わり目と、実際のデータが示す季節の変わり目にどれほどのタイムラグがあるのか

今回の2026年7月〜9月のデータは、私たちに「今年の夏は平均的ですんなり終わった」という感覚を与えてくれたが、それを支えていたのは単なる印象ではなく、微小な環境変化の積み重ねであった。


おわりに:微気象の世界は、まだまだ広がっていく

気象庁のデータは日本全体の気候を俯瞰するには欠かせないものだが、私たちが実際に暮らす空間や、庭先、建物周辺の環境は、場所ごとに全く異なる顔を持っている。

今回のようなロガーを用いた実測とデータ解析の世界は、専門機関だけの特権ではない。少しの工夫と機材があれば、身近な空間の「本当の気候」を誰でも解き明かすことができる。

今年の夏はデータ上でも比較的メリハリのある形で幕を閉じたが、身の回りの微気象を定点観測する試みは、季節の移り変わりをより深く、立体的に味わうための最高の趣味であり、知的探求だと言える。これからもデータというレンズを通して、私たちの身の回りの自然環境を静かに見つめていきたい。


関連記事

2026年秋【重要なお知らせ】還付金のご案内および口座情報確認について」は詐欺メール?国税庁(e-Tax)をかたるフィッシングがスパム判定をすり抜けた理由

「【重要なお知らせ】還付金のご案内および口座情報確認について」という国税庁(e-Tax)を名乗るメールはフィッシング詐欺です。本文とヘッダを公開し、偽物と判断できる根拠、スコア4.1でスパム判定をすり抜けた理由、対策を解説します。

この記事は、スパムアサシンやメーラーでのスパム判定をすり抜けた怪しいメールを取り扱います。その内容の判定や、設定方法の改善策について記載します。

結論から言うと、このメールは国税庁(e-Tax)を装ったフィッシング詐欺です。リンクは開かず、メールは削除してください。

2026年10月11日(日)の夜、筆者のもとに「【重要なお知らせ】還付金のご案内および口座情報確認について」という件名のメールが届きました。差出人は「e-Tax」、アドレスは国税庁の正規ドメインである info@e-tax.nta.go.jp です。ところがヘッダを調べると、国税庁のサーバーから送られたものではないことがはっきり分かります。

同じ日に届いた別文面のe-Tax偽装メールは、前回の記事で取り上げました。今回は文面も送信元IPアドレスも別ですが、送信ソフトの表記(Foxmail)、時刻の表記(+0800)、送信ドメイン認証の失敗など、共通する特徴があります。同じ系統の配信とみられます。

そして今回も、SpamAssassinの判定は「スパムではない」でした。スコアは4.1点(この環境のしきい値は30.0点)で、迷惑メール扱いにならず、そのまま受信箱に届いています。

自分に届いたメールと照合する

お手元のメールが同じものか、次の項目で確認できます。本文の金額などは、配信ごとに異なる可能性があります。

項目内容
件名【重要なお知らせ】還付金のご案内および口座情報確認について
差出人表示"e-Tax" <info@e-tax.nta.go.jp>
受信日時2026年10月11日(日)20:54(日本時間)
本文の金額と期限還付金確定金額:93,500円 / お手続き期限:令和8年10月12日
送信元IPアドレス120.35.201.239
Message-ID<20261011195412267182@e-tax.nta.go.jp>
送信ソフトの表記Foxmail 6, 13, 102, 15 [cn]

背景:情報漏洩が詐欺メールの精度を上げている

昨今、各社から不正アクセスによる個人情報漏洩の報告が相次いでいます。問題は、単にメールアドレスが漏れたということにとどまりません。

メールアドレスとサービスの利用情報が一緒に漏れれば、そのサービスを名乗る詐欺メールの精度は上がります。極端な話、利用しているサービスから届いた「あなたの個人情報が漏れました」というお知らせメール自体が、詐欺である可能性さえあります。

フィッシング対策協議会も、フィッシングメールが届くということはメールアドレスがインターネット上に漏えいしていることを意味し、漏えいした情報は犯罪者の間で売買されて消せない、と注意喚起しています。

今回のメールは宛名のない汎用の文面で、特定サービスの漏洩情報を使った形跡はありません。それでも、国税庁という「自分にも関係があるかもしれない」組織を名乗ることで、受信者を選ばずに信じさせる作りになっています。こうしたメールが届く前提で、判定をすり抜けたときの備えを整えておく必要があります。

届いたメール(受信したままの記録)

以下は受信したメールの件名、本文、ヘッダです。公開にあたり、次の方針で扱っています。

  • 受信者のアドレスと受信サーバーが特定できる部分は「******」に置き換え、受信サーバーが付けた署名などの行は省略しました
  • 送信側の情報(差出人、送信元IPアドレス、Message-IDなど)は、お手元のメールと照合できるよう、そのまま掲載しています
  • 誤字や不自然な表記も、原文のままです

件名

【重要なお知らせ】還付金のご案内および口座情報確認について

本文

【重要なお知らせ】還付金のご案内および口座情報確認について


国税e-Tax
住宅借入金等特別控除の還付金について
令和7年度分の所得税について、還付金が確定いたしました。
下記のとおりご案内いたします。
還付金確定金額:93,500円
お手続き期限:令和8年10月12日
受付日時:2026年10月11日
還付金のお受け取りには、下記よりe-Taxログインのうえお手続きください。

■ご利用確認はこちら

---------------------------------------------------------------
※必ず期限内にご確認いただきますよう重ねてお願い申し上げます。
【ご注意事項】 ·メッセージボックスの内容確認には、マイナンバーカード等の電子証明書による認証が必要です。
還付金の振込には、別途お手続きが必要な場合がございます。詳細は通知書をご参照ください。
e-Taxのご利用可能時間は、e-Taxボームページにてご確認いただけます。 本メールは送信専用です。
ご返信いただいてもご対応いたしかねますのでご了承願います。
 e-Taxホームベージにおける個人情報保護方針
 1. 基本的考え方 国税庁では、e-Taxホームページ(ドメイン「www.e-tax.nta.go.jp」)において提供するサービス(情報提供、各種意見の受付等)の円滑な運営に必要な範囲で情報を収集しています。
収集した情報は利用目的の範囲内で適切に取り扱います。
 2. 収集する情報の範囲 当サイトでは、インターネットドメイン名、IPアドレス、閲覧情報等を自動的に収集します。ー部サービスにおいてクッキーを使用する場合がありますが、個人を特定する情報は取得いたしません。
https://net.kojinbango-card.go.jp/SS_SERVICE_OUT/FA01S001Action.do
(※) マイナンバーカード方式について
マイナンバーカード方式の概要
e-Taxへのログインにあたっては、利用者識別番号(数字16桁)及びパスワードの入力が必要ですが、 マイナンバーカード (※) を事前に登録するだけで、利用者証明用電子証明書の暗証番号(数字4桁)を入力することでe-Taxへログインが可能になります。
(※) 「スマートフォンのマイナンバーカード」 も利用可能です。
https://www.e-tax.nta.go.jp/kojin/mycd_login.htm#anc05
マイナンバーカード方式のメリット
利用者識別番号(数字16桁)及びパスワードの管理が不要です。
マイナンバーカード方式でログインした場合、利用者識別番号は「マイページ」の「基本情報」メニューから、パスワードは「マイページ」の「その他の登録情報」メニューから確認できます。
https://net.kojinbango-card.go.jp/SS_SERVICE_OUT/pages/ssf/FG01S001.jsp
e-Taxを利用するために事前準備として必要であった電子証明書の登録が不要です。
マイナンバーカードの電子証明書(有効期限:5年間)が失効した場合は、市区町村の窓口で電子証明書の更新を行うことで、e-Taxをご利用いただけます。
https://services.digital.go.jp/mynumbercard-android/#%E4%BD%BF%E3%81%88%E3%82%8B%E5%A0%B4%E6%89%80%E3%82%84%E3%82%B5%E3%83%BC%E3%83%93%E3%82%B9
「スマートフォンのマイナンバーカード」も利用可能です。
マイナンバーカードを取得されている方は、お持ちのスマートフォンにマイナンバーカード(Android™については「スマホ用電子証明書」のみ対応(※)。)を搭載することができます。
「スマートフォンのマイナンバーカード」を利用すれば、マイナンバーカードをスマートフォンにかざすことなく、申告書の作成・e-Tax送信が可能となります。
また、利用者用電子証明書に設定したパスワード(4桁の数字)を入力する代わりに、生体認証が利用できます。(機種によって異なります。)
詳細や申し込み方法については、デジタル庁HPの「スマートフォンのマイナンバーカード」をご確認ください。
https://www.digital.go.jp/policies/mynumber/smartphone-certification#service
(※)Android™に搭載できる「スマホ用電子証明書」には、マイナンバーカードに記載された氏名、住所、生年月日及び性別並びにマイナンバー(基本4情報等)は搭載されていません。そのため、e-Taxのマイページから初めて「給与所得の源泉徴収票情報の取得希望の手続」を行う場合など、基本4情報等をe-Taxへ提供していただく際には、マイナンバーカードを読み取る必要があります。
----------------------------------------------------------------------------------
国税庁  〒100-8978  東京都千代田区霞が関3-1-1  法人番号7000012050002

国税庁Copyright © NATIONAL TAX AGENCY ALL Rights Reserved.

「■ご利用確認はこちら」の部分には、リンクが設定されているとみられます。リンク先のURLは本稿では掲載しません。【編集メモ:リンク先URLが分かる場合は hxxps://example[.]com のように無効化して追記。確認していない場合は「リンク先は確認していません」と記載】

ヘッダ(公開用に整形)

Return-Path: <info@e-tax.nta.go.jp>
X-Spam-Checker-Version: SpamAssassin 3.4.6 (2021-04-09) on ******.jp
X-Spam-Level: ****
X-Spam-Status: No, score=4.1 required=30.0 tests=HTML_FONT_FACE_BAD,
    HTML_MESSAGE,RDNS_NONE,SPF_FAIL,SPF_HELO_FAIL,URIBL_ABUSE_SURBL,
    URIBL_BLOCKED,URIBL_DBL_BLOCKED_OPENDNS,URIBL_PH_SURBL,
    URIBL_ZEN_BLOCKED_OPENDNS autolearn=no autolearn_force=no version=3.4.6
Delivered-To: ******@******.jp
Received: from e-tax.nta.go.jp (unknown [120.35.201.239])
    by ******.jp (Postfix) with ESMTP id ******
    for <******@******.jp>; Sun, 11 Oct 2026 20:54:15 +0900 (JST)
Authentication-Results: ******.jp;
    dkim=none;
    dmarc=fail reason="No valid SPF, No valid DKIM" header.from=e-tax.nta.go.jp (policy=none);
    spf=fail (******.jp: domain of info@e-tax.nta.go.jp does not designate 120.35.201.239 as permitted sender) smtp.mailfrom=info@e-tax.nta.go.jp
Date: Sun, 11 Oct 2026 19:53:58 +0800
From: "e-Tax" <info@e-tax.nta.go.jp>
To: <******@******.jp>
Subject: =?utf-8?B?44CQ6YeN6KaB44Gq44GK55+l44KJ44Gb44CR6YKE5LuY6YeR44Gu44GU5qGI5YaF44GK44KI44Gz5Y+j?=
    =?utf-8?B?5bqn5oOF5aCx56K66KqN44Gr44Gk44GE44Gm?=
Message-ID: <20261011195412267182@e-tax.nta.go.jp>
X-mailer: Foxmail 6, 13, 102, 15 [cn]
Mime-Version: 1.0
Content-Type: multipart/alternative;
    boundary="=====003_Dragon478065417446_====="

偽物と判断できる根拠

1. 国税庁が説明する「本物のe-Taxメール」と違う

国税庁は、e-Taxを装った不審なメールへの注意喚起ページで、本物のe-Taxメールの特徴を説明しています。このメールと並べると、次のとおり食い違います。

国税庁の説明このメール
送信元表記は「e-Tax(国税電子申告・納税システム)」に統一されている表示名は「e-Tax」のみ
定型の文面で、本文にURLは原則記載しない「■ご利用確認はこちら」からe-Taxログインへ誘導している
宛名は、利用者が登録したものが表示される宛名がない
還付金額を表示したメールは送らない「還付金確定金額:93,500円」と表示している
手続や納付を催促するメールは送らない「お手続き期限」を示し、「必ず期限内に」と促している

差出人のアドレス info@e-tax.nta.go.jp は本物と同じです。アドレスだけでは見分けられないので、表示名や本文の作りも合わせて確認する必要があります。国税庁は2026年10月16日(令和8年10月16日)の更新で、還付金額を表示して受取手続きをうながす類似のメールを、不審なメールの最近の事例として追加しています。

2. 本文が不自然

  • 「令和7年度分の所得税」という言い方は通常使いません。所得税は「令和7年分」と呼びます
  • 受付日時は西暦(2026年10月11日)、期限は和暦(令和8年10月12日)で、表記が混在している
  • 期限はメールが届いた翌日の10月12日で、しかもスポーツの日(祝日)。届いたのは日曜の夜で、考える時間を与えない作りになっている
  • 件名は「口座情報確認」だが、本文には口座の話がなく、ログインを促すだけ。リンクの文言は「ご利用確認はこちら」で、還付とも口座とも合っていない
  • 「e-Taxボームページ」「e-Taxホームベージ」(正しくは「ホームページ」)、「ー部サービス」(漢数字の「一」ではなく長音記号)、文頭の中黒「·」など、公式文書をコピーして加工した形跡がある
  • 後半は、マイナンバーカード方式の説明や個人情報保護方針が長々と続く。公式サイトの文章を流用したとみられ、e-tax.nta.go.jp、kojinbango-card.go.jp、digital.go.jp など本物のリンクも混ざっている。本物のリンクや文章が含まれていても、本物の証拠にはなりません

3. ヘッダが「国税庁から来ていない」ことを示している

調べた項目このメールの値分かること
SPFfail(120.35.201.239 は info@e-tax.nta.go.jp の送信元として許可されていない)国税庁ドメインの正規の送信元ではない
DKIMnone電子署名がない
DMARCfail(No valid SPF, No valid DKIM / policy=none)SPFもDKIMも成立していない。ただし送信ドメイン側のポリシーは none
送信元IPアドレス120.35.201.239(受信時は逆引きできず)HELOでは e-tax.nta.go.jp を名乗っているが、実体と一致しない(SPF_HELO_FAIL)
IPアドレスの所属解析結果(下の「参考」)では、このIPを含む 120.32.0.0/13 は AS4134(CHINANET BACKBONE)として経路が広告されている中国の通信事業者のアドレス帯で、国税庁の設備とは考えにくい。動的に割り当てられた回線とみられる(詳しくは下の「参考」)
送信ソフトX-mailer: Foxmail 6, 13, 102, 15 [cn]中国で広く使われるメールソフトの名乗り。官公庁が使うとは考えにくい
送信日時Date: 19:53:58 +0800日本標準時は+0900。日本時間では20:53:58で、受信側の受付時刻(20:54:15)とは矛盾せず、送信側の端末が+0800設定だったことを示唆する
Message-ID<20261011195412267182@e-tax.nta.go.jp>ドメイン部分も国税庁を名乗っている
Return-Pathinfo@e-tax.nta.go.jpSPFの検査対象になる送信者アドレスも、国税庁を名乗っている

4. 同じ件名が、フィッシング対策協議会の注意喚起に載っている

フィッシング対策協議会は2026年9月30日、国税庁をかたってAndroidスマートフォン用の不正アプリのインストールなどへ誘導するフィッシングメールの注意喚起を出しました。メールの件名の例として、今回と同じ「【重要なお知らせ】還付金のご案内および口座情報確認について」が挙げられています。同協議会は、2026年9月30日時点でスマートフォン用のe-Taxアプリは提供されていないとしています。

このメールのリンク先がどう動作するかは、本稿では確認していません。

参考:送信元IPアドレスの解析結果

送信元IPアドレス 120.35.201.239 を、IPアドレスの情報サービスで調べた結果です。位置情報は推定値で、接続元の回線がある場所の目安にすぎません。送信者本人の所在地を示すものではありません。

項目結果
IPアドレス120.35.201.239
ホスト名239.201.35.120.broad.sm.fj.dynamic.163data.com.cn
国China
地域Fujian
市区町村Sanming(推定)
郵便番号365000(推定)
緯度・経度26.2638, 117.639(推定)
タイムゾーンAsia/Shanghai
ISPChinanet
組織Chinanet FJ
AS番号AS4134 CHINANET BACKBONE
CIDR120.32.0.0/13
開始アドレス120.32.0.0
終了アドレス120.39.255.255

読み取れることは、次の3点です。

  • 一般向けの回線から送られたとみられる。 ホスト名の broad と dynamic は、通信事業者が回線の利用者に動的に割り当てるアドレスによく見られる形式です。国税庁のメールサーバーのアドレスではありません。ただし、回線の持ち主が送信者本人とは限らず、踏み台にされた機器の可能性もあります
  • 時刻の表記と方向が一致する。 タイムゾーンが Asia/Shanghai(+0800)なのは、メールの Date: ... +0800 と一致します。送信ソフトの [cn] 表記も同じ方向です。ただし、これらは偽装できるため、所在地を断定する根拠にはなりません
  • 受信時の逆引き結果とは異なる。 受信時のヘッダでは、送信元は unknown(RDNS_NONE)でした。今回の解析ではホスト名が得られています。Postfixは、逆引きで得た名前を正引きしても元のIPアドレスに戻らない場合も unknown と表示するため、動的回線に多い「逆引きだけが設定され、正引きがない」状態だった可能性があります。本稿では正引きまでは確認していません

なぜスパム判定をすり抜けたのか

SpamAssassinが付けた判定は、次のとおりでした。

X-Spam-Status: No, score=4.1 required=30.0 tests=HTML_FONT_FACE_BAD,
    HTML_MESSAGE,RDNS_NONE,SPF_FAIL,SPF_HELO_FAIL,URIBL_ABUSE_SURBL,
    URIBL_BLOCKED,URIBL_DBL_BLOCKED_OPENDNS,URIBL_PH_SURBL,
    URIBL_ZEN_BLOCKED_OPENDNS autolearn=no autolearn_force=no version=3.4.6

各検査項目の意味は次のとおりです。

検査項目意味
HTML_MESSAGEHTMLメールである(情報のみ)
HTML_FONT_FACE_BADHTMLのフォント指定が不自然
RDNS_NONE受信時に、送信元IPアドレスの逆引きができなかった
SPF_FAIL送信者アドレスのドメインが、SPFの検査に失敗した
SPF_HELO_FAILHELOで名乗ったドメインも、SPFの検査に失敗した
URIBL_ABUSE_SURBL本文中のURLが、SURBLのabuseリストに該当した
URIBL_PH_SURBL本文中のURLが、SURBLのフィッシングリストに該当した
URIBL_BLOCKED / URIBL_DBL_BLOCKED_OPENDNS / URIBL_ZEN_BLOCKED_OPENDNSブロックリストへの問い合わせ自体が断られ、検査できなかったことを知らせる管理者向けの通知

ここから読み取れることは、次の4点です。

  • 点数が足りない。 合計は4.1点です。SpamAssassinの標準のしきい値5.0点でも通過する点数で、この環境のしきい値は30.0点でした。スコアの積み上げだけで止めるのは難しい状況です
  • フィッシングURLのリストに載っていても、加点は小さい。 URIBL_ABUSE_SURBL と URIBL_PH_SURBL の2つに該当しながら、合計は4.1点にとどまりました
  • ブロックリストの照会3件が、実質機能していない。 BLOCKED を含む3つは「該当した」ではなく「問い合わせを断られた」という意味です。公開DNSリゾルバー経由の問い合わせなどは、ブロックリスト側が受け付けないことがあります。検査できていないので、これらのリストに載っていたかどうかは分かりません
  • DMARCの結果は、スコアに入っていない。 tests= の一覧にDMARC関連の項目はありません。dmarc=fail は Authentication-Results ヘッダにだけ記録されています。しかも送信ドメイン側のポリシーは policy=none で、認証に失敗しても拒否や隔離を求めていません

つまり「認証に失敗している」という最も強い手がかりが、スコアにはほとんど反映されていません。そこで、スコアとは別に、認証の失敗そのものを条件にして振り分ける対策が有効になります。

対策1:送信認証の失敗を条件に振り分ける

「スコア」ではなく「認証の失敗」を条件にする方法です。政府機関のように送信ドメイン認証を整えているはずのドメインを名乗り、かつ認証に失敗しているメールは、ほぼ偽物とみなせます。

筆者が使っているThunderbirdの設定は、前回の記事で紹介したものと同じです。

  1. メニューの「ツール」→「メッセージフィルタ」を開く
  2. 「新規」を選び、条件の項目で「カスタマイズ」から Authentication-Results を追加する
  3. 「次の文字列を含む」で spf=fail と dmarc=fail の両方を条件にする(「すべての条件に一致」)
  4. 動作は「削除」ではなく「ゴミ箱へ移動」または専用フォルダへの移動にする

今回のメールのヘッダにも spf=fail と dmarc=fail の両方が含まれているので、同じ条件で捕捉できます。注意点は2つあります。

  • Authentication-Results は受信サーバーが付けるヘッダです。お使いの環境のメールに付いているか、先に確認してください(ヘッダの見方は前回の記事にまとめています)
  • 認証の失敗は、転送やメーリングリストを経由した正規メールでも起こります。振り分け先のフォルダは、週に1回程度、差出人と件名を確認してください

対策2:サーバー側のスコア設定を見直すときの考え方

  • しきい値を下げる。 今回の4.1点を止めるには、しきい値を4.0点以下にする必要があります。そこまで下げると、正規メールの誤判定が増えます。判定結果を「削除」や「破棄」にしている場合は、誤判定で正規メールが戻せなくなるため、特に慎重に検討してください
  • ブロックリストの照会が拒否されていないか確認する。 ヘッダに BLOCKED を含む項目が出ているなら、その検査は働いていません。自前でサーバーを運用している場合は、SpamAssassinが参照するDNSを、自分で用意したキャッシュDNSサーバーに切り替える方法があります。レンタルサーバーでは利用者が変更できないことが多いので、サーバー事業者への確認や、サービス選びの材料になります
  • 自前のSpamAssassinなら、認証失敗にルールを追加する。 SPF失敗とDMARC失敗が重なったときに大きく加点するルールを足す方法です。設定方法は、要望があれば別記事で取り上げます

対策3:メールのリンクから手続きしない

国税庁によると、e-Taxから送るメールは定型の文面で、本文にURLは原則記載されません。フィッシング対策協議会も、e-Taxから通知が来た場合は登録済みの環境からメッセージボックスを確認するよう呼びかけています。

  • 本文にURLのあるe-Tax通知は、その時点で疑う
  • 還付や期限の連絡が気になったら、メールのリンクではなく、ブックマークしておいた公式サイトから自分でe-Taxにログインして確認する

もしリンクを開いてしまったら

状況別の対処は、前回の記事に詳しくまとめています。要点は次のとおりです。

  • 開いただけで何も入力していない場合: ブラウザを閉じ、念のため履歴とキャッシュを削除する
  • IDやパスワードを入力した場合: 公式サイトから直ちに変更し、同じパスワードを使い回しているサービスもすべて変更する。マイナンバーカードの暗証番号を入力した場合は、カードの一時利用停止も検討する(マイナンバー総合フリーダイヤル 0120-95-0178)。クレジットカード情報を入力した場合は、カード会社にすぐ連絡する
  • アプリをインストールしてしまった場合: 機内モードでネットワークを遮断し、アプリをアンインストールしてウイルス対策アプリでスキャンする。銀行・証券・クレジットカードなどのパスワードも変更する
  • 相談先: 警察の相談窓口 #9110、消費者ホットライン 188、最寄りの税務署

同じようなメールを受け取ったら、フィッシング対策協議会への報告もお願いします。国税庁の不審なメールや電話に関する注意喚起も参考になります。

よくある質問

Q. 「【重要なお知らせ】還付金のご案内および口座情報確認について」というメールは本物ですか?

A. 偽物です。国税庁は、還付金額を表示したメールは送らないと説明しています。ヘッダも、国税庁のサーバーから送られていないことを示しています。

Q. すでにリンクをクリックしてしまいました。

A. 何も入力せず、アプリもインストールしていなければ、大きな被害の可能性は低いです。ただし、上の「もしリンクを開いてしまったら」を確認してください。

Q. 迷惑メールフォルダに入っていないのはなぜですか?

A. SpamAssassinのスコアが4.1点で、しきい値に届かなかったためです。DMARCの失敗はスコアに入っておらず、送信ドメイン側のポリシーも none だったため、受信側でそのまま配信されました。

Q. 本物のe-Taxからのメールかどうか、どう確認すればいいですか?

A. メールのリンクは使わず、ブックマークした公式サイトから自分でe-Taxにログインして、メッセージボックスを確認してください。国税庁によると、本物の通知メールは定型の文面で、本文にURLは原則記載されず、宛名を登録していればその宛名が表示されます。

まとめ

  • 「【重要なお知らせ】還付金のご案内および口座情報確認について」は、国税庁(e-Tax)を装うフィッシングメールです
  • 還付金額の表示、本文のリンク、宛名の欠落、不自然な日本語、ヘッダの認証失敗から、偽物と判断できます
  • SpamAssassinのスコアは4.1点(しきい値30.0点)で、判定をすり抜けました。ブロックリストへの照会も3件が拒否され、DMARCの結果はスコアに入っていませんでした
  • スコアに頼らず、spf=fail と dmarc=fail を条件にしたフィルタが有効です。ただし、振り分け先のフォルダは定期的に確認してください

関連記事・参考情報

関連記事(このサイト)

参考

スパムアサシンの設定と、メーラーでの設定については、要望があれば記事を用意します。コメントでお知らせください。

この記事は2026年10月31日時点の情報です。手口は変化するため、最新の注意喚起は国税庁やフィッシング対策協議会の公式サイトでご確認ください。

過去(2024年以前)実施の迷惑メール対策方法、設定

スパムアサシンの設定と、メーラーでの設定については、要望があれば記事を用意いたしま。コメントとをお願いします。

2026年「還付金確定通知書を格納いたしました」は詐欺メール?国税庁(e-Tax)をかたるフィッシングの見分け方

この記事は、スパムアサシンやメーラーでのスパム判定をすり抜けた怪しいメールを取り扱います。その内容の判定や設定方法の改善策について取り扱います。巧妙化する攻撃に対応について記載します


結論から言うと、このメールは国税庁を装ったフィッシング詐欺です。リンクは開かず、メールは削除してください。

2026年10月11日(日)、筆者のもとに「【重要なお知らせ】還付金確定通知書を格納いたしました」という件名のメールが届きました。差出人は「e-Tax」で、国税庁のドメインから送られたように見えます。

迷惑メール判定は受けておらず、一見すると本物のように見えます。この記事では、同じメールを受け取って「本物かどうか」を調べている方のために、偽物と判断した根拠と、開いてしまった場合の対処法をまとめます。

届いたメールの内容

件名と本文の要点は次のとおりです(リンクは無効化しています)。

  • 件名:【重要なお知らせ】還付金確定通知書を格納いたしました
  • 内容:令和8年分の所得税確定申告の還付金が確定し、通知書をe-Taxのメッセージボックスに格納した。確認期限は令和8年10月1日。
  • 誘導:Android版e-Taxアプリをインストールしていない場合は、ボタンからダウンロードするよう案内。
  • リンク先:hxxps://ojzvvq[.]cn/?ywtxqcrw

同じ文面が届いた方は、以下の見分けポイントと照らし合わせてみてください。

偽物と判断できる7つの理由

1. 存在しない通知である(日付の矛盾)

本文は「令和8年分(令和8年1月1日〜12月31日)の確定申告の還付金が確定した」と述べています。しかし令和8年分は、メールが届いた2026年10月11日時点でまだ年が終わっていません。申告は令和9年(2027年)の2月〜3月ごろに行うもので、還付金が確定しているはずがありません。

さらに、確認期限が「令和8年10月1日」で、メールが送られた時点で10日も過ぎています。期限切れの日付を書いている時点で、おかしな通知です。

2. リンク先が国税庁のサイトではない

ボタンのリンク先は ojzvvq[.]cn というランダムな文字列のドメインで、国税庁のドメイン(nta.go.jp)とは無関係です。末尾の ?ywtxqcrw は、受信者や配信ロットを識別するためのものと考えられます。

.go.jp は日本の政府機関しか取得できないドメインです。リンク先が .go.jp で終わっているかどうかは、見分ける際の基本ポイントです。

3. 本文の内容が矛盾している

  • 「通知はアプリ内のメッセージボックスでのみ確認できる」と説明しながら、外部サイトのボタンへ誘導している
  • 「Android版」のインストールだけを強調している

偽サイトで情報を入力させる、またはAndroid用の不正なアプリ(マルウェア)をインストールさせるのが目的と考えられます。ただし、筆者は偽サイトにアクセスしていないため、実際の動作は確認していません。

4. 本物の文章とリンクを混ぜて信頼させようとしている

後半には、マイナンバーカード方式の説明や個人情報保護方針が長々と書かれています。公式サイトの文章を流用したものと思われ、e-tax.nta.go.jp、digital.go.jp など本物のリンクも混ざっています。国税庁の所在地や法人番号も記載されていますが、これらは公開情報です。本物のリンクや情報が含まれていても、本物の証拠にはなりません。

5. 不自然な日本語がある

  • 「e-Taxボームページ」「ホームベージ」(正しくは「ホームページ」)
  • 「ー部サービス」(漢数字の「一」ではなく長音記号)
  • 文頭の不自然な中黒「·」

公式文書をコピーして加工した形跡とみられます。

6. 「お金」と「期限」で焦らせる

還付金という「得をする話」と、確認期限という「急がせる要素」の組み合わせは、フィッシングの典型的な手口です。冷静に考える時間を与えないための工夫です。

7. メールヘッダが「国税庁からではない」ことを示している

メールの送信元情報(ヘッダ)を調べると、差出人の詐称がはっきり分かりました。

調べた項目結果分かること
送信元の認証(SPF)失敗国税庁ドメインの送信元として許可されていないIPアドレスから送られた
電子署名(DKIM)なし正規のメールに付く署名がない
DMARC失敗送信元の詐称を見抜くための仕組みの判定も不合格
送信元IPアドレス59.59.212[.]137(逆引きできず)国税庁のサーバーとは対応しない。日本のIPアドレス管理機関(JPNIC)の検索では該当データなし
送信ソフトFoxmail(中国語圏向けのメールソフト)国税庁が使うとは考えにくい
送信日時のタイムゾーン+0800(中国標準時)日本の機関なら通常+0900(日本標準時)
URLの検査本文中のURLがフィッシング用のブロックリストに該当すでに危険なURLとして知られている

差出人、Return-Path、Message-IDのすべてが e-tax.nta.go.jp になっており、送信ドメインそのものを詐称していました。

なぜ迷惑メール判定をすり抜けたのか

認証に失敗しているのに配信された理由の1つは、国税庁ドメインのDMARCポリシーです。筆者がDNSで確認したところ、_dmarc.e-tax.nta.go.jp の設定は次のとおり、p=none(認証に失敗しても拒否・隔離を求めない) でした(2026年10月11日時点)。

v=DMARC1; p=none

p=none は「監視のみ」の設定で、認証に失敗したメールも受信側でそのまま配信される可能性があります。そのため、受信側の設定によっては、この種のメールが受信箱に届いてしまいます。迷惑メールフォルダに入っていないことは、安全の証明にはなりません。

対策:送信認証の失敗を条件にしたフィルタを作る

政府機関のように送信認証を整えているはずのドメインを名乗り、かつ認証に失敗しているメールは、ほぼ偽物とみなせます。この条件でメールを自動で振り分けると効果的です。

筆者が使っているThunderbirdでは、次の設定でできます(Authentication-Results は受信サーバーが付けるヘッダです)。

  1. メニューから「ツール」→「メッセージフィルタ」を開く
  2. 「新規」を選び、条件の項目で「カスタマイズ」から Authentication-Results を追加する
  3. 「次の文字列を含む」で spf=fail と dmarc=fail の両方を条件にする(「すべての条件に一致」)
  4. 動作は「削除」ではなく「ゴミ箱へ移動」または専用フォルダへの移動にする

筆者の環境では、この設定により、今回のメールは迷惑メール判定がなくても自動でゴミ箱に入っていました。

ゴミ箱・隔離フォルダは定期的に確認する

送信認証の失敗は、偽メール以外でも起こることがあります。たとえば、メールを別のアドレスへ転送している場合や、一部のメーリングリストを経由した場合です。正規のメールを見逃さないために、振り分けたフォルダは次のように確認しましょう。

  • 週に1回程度、ゴミ箱と隔離フォルダの差出人と件名を確認する
  • 見覚えのある差出人や、自分が関わった手続きのメールが入っていたら、元のフォルダに戻す
  • 判断に迷うメールは、本文内のリンクを開かず、公式サイトや公式アプリから直接確認する
  • 確認して問題がなければ、メールを完全に削除する

メールヘッダの見方

  • Thunderbird:メールを開き、「表示」→「ヘッダ」→「すべて」。またはCtrl+Uでソースを表示
  • Gmail:メール右上の「︙」→「メッセージのソースを表示」
  • Outlook:メールのプロパティから「インターネットヘッダー」を確認

Authentication-Results の行に spf=fail や dmarc=fail があれば要注意です。

もしリンクを開いてしまったら

状況別の対処は次のとおりです。

リンクを開いただけで何も入力していない場合
慌てる必要はありません。ブラウザを閉じ、念のためブラウザの履歴とキャッシュを削除してください。

偽サイトにIDやパスワードを入力した場合

  • 入力したIDとパスワードを、公式サイトから直ちに変更する
  • 同じパスワードを使い回しているサービスもすべて変更する
  • マイナンバーカードの暗証番号を入力した場合は、カードの一時利用停止も検討する(マイナンバー総合フリーダイヤル 0120-95-0178)
  • クレジットカード情報を入力した場合は、カード会社にすぐ連絡する

アプリをインストールしてしまった場合

  • 機内モードにしてネットワークを遮断する
  • 該当アプリをアンインストールし、ウイルス対策アプリでスキャンする
  • 銀行・証券・クレジットカードなどのパスワードを変更する
  • 不審な動作が続く場合は、端末の初期化も検討する

相談先

  • 警察の相談窓口:#9110
  • 消費者ホットライン:188
  • 最寄りの税務署

通報先

  • フィッシング対策協議会
  • 迷惑メール相談センター

今後も見破るための3つのルール

  1. メール内のリンクは開かない。 公式アプリやブックマークから直接アクセスする
  2. 「還付」「期限」「重要」で急かされたら、まず疑う。 本物の税務手続きは、メールのボタンだけで完結しない
  3. 差出人の表示名やドメインは信用しない。 差出人は簡単に詐称できる

よくある質問

Q. 「還付金確定通知書を格納いたしました」というメールは本物ですか?
A. 今回のメールは偽物です。令和8年分の還付金が現時点で確定することはなく、リンク先も国税庁のドメインではありません。

Q. すでにリンクをクリックしてしまいました。
A. 何も入力せず、アプリもインストールしていなければ、大きな被害の可能性は低いです。「もしリンクを開いてしまったら」の対処を確認してください。

Q. 本物のe-Taxからの連絡かどうか、どう確認すればいいですか?
A. メールのリンクではなく、公式サイトやブックマーク、公式アプリから自分でe-Taxにログインして、メッセージボックスを確認してください。

Q. 迷惑メールフォルダに入っていないのはなぜですか?
A. 送信元の詐称を見抜く仕組み(DMARC)が「監視のみ」の設定で、認証に失敗したメールも受信側でそのまま配信されることがあるためです。受信側のフィルタで、送信認証の失敗を条件に振り分けると効果的です。

まとめ

  • 「還付金確定通知書を格納いたしました」は、国税庁を装うフィッシングメールです
  • 日付の矛盾、国税庁ではないリンク先、本文の矛盾、不自然な日本語、ヘッダの認証失敗から、偽物と判断できます
  • 迷惑メール判定をすり抜けることがあるので、「判定されていない=安全」とは考えないでください
  • 送信認証の失敗を条件にしたフィルタが有効です。ただし、振り分け先のフォルダは定期的に確認してください

この記事は2026年10月11日時点の情報です。手口は変化するため、最新の注意喚起は国税庁やフィッシング対策協議会の公式サイトでご確認ください。


過去(2024年以前)実施の迷惑メール対策方法、設定

スパムアサシンの設定と、メーラーでの設定については、要望があれば記事を用意いたしま。コメントとをお願いします。
コンクリート劣化の引き金は「急乾燥」だけではなかった ―― AEの集中発生4回を気象データと重ねて検証

AEセンサーが捉えたコンクリートの「悲鳴」の集中発生4回を、気象庁の10分値と重ねて検証しました。雨上がりの急乾燥だけでなく、強風や強い雨で壁が濡れる「急な湿潤」でもAEが集中していました。

90%→40%)との関係を紹介しました。ただ、あのときは気象データとの一致を文章で説明しただけで、データを並べて見せてはいませんでした。取り上げたAEの集中発生も1回だけでした。

その後も記録を続け、ログを整理し直したところ、AEが短時間に集中して発生した場面は合計4回ありました。今回は4回それぞれについて、気温・湿度・雨・風の推移とAEの発生タイミングを1枚のグラフに重ね、コンクリート劣化の引き金を検証します。

結論を先に書くと、引き金は「急乾燥」だけではありませんでした。強風や強い雨で壁が一気に濡れる「急な湿潤」の場面でも、AEは集中して発生していました。現場の定点カメラの画像でも、発生の前後に壁が濡れていた様子を確認できています。

今回使ったデータとグラフの見方

  • AE:壁に取り付けた自作のAEロガー(4チャンネル)の記録です。しきい値を超えた信号を、時刻と振幅で記録しています。
  • 気象:気象庁「過去の気象データ検索」の10分ごとの値(気温・相対湿度・降水量・平均風速・最大瞬間風速・日照時間)を使いました。観測点は現場から少し離れた近隣の地点です。
  • 定点カメラ:壁を10分ごとに撮影している定点カメラ(ATOM Cam 2)の画像で、発生前後の壁の濡れ具合を確認しました。

プライバシーに配慮して、今回のグラフでは日付と観測地点名を伏せ、横軸を「AE集中発生からの経過時間」(発生の60時間前〜12時間後)にしています。グラフは上から、日照・気温・湿度・降水量(10分ごと)・風速・AE検出数の順です。赤い破線がAEの集中発生時刻、一番下の灰色の斜線は記録が止まっていた区間です。AE検出数は、1件と100件を同じグラフに収めるため対数目盛にしています。

ログを整理して分かった2つの注意点

  1. 時刻の「桁あふれ」:ロガー内部の経過時間カウンター(ミリ秒単位)は、約49.7日で一周してゼロに戻ります。そのまま読むと、実際より約50日前の日付に見えてしまいます。時刻合わせの記録と照合して補正したところ、見落としていた集中発生が見つかりました。
  2. メモリ満杯による記録停止:記録用のメモリ(EEPROM)は128件で満杯になります。4回のうち3回は、集中発生の最中に満杯になって記録が止まっていました。グラフの件数は「少なくともこれだけ発生した」という値です。

イベント① 雨上がりの急乾燥(前回のケース)

イベント①のグラフ。雨上がりの晴天で湿度が87%から40%まで下がり気温が上がった後、乾燥のピーク直後にAEが43件集中して発生している
イベント①:雨上がりの急乾燥。乾燥のピークを過ぎた直後にAEが集中

2日前の雨で、湿度は100%近くありました。そこから晴れて、発生までの約10時間で湿度は87%→40%、気温は8.5℃→19.5℃と一気に変わっています。直前24時間の雨はゼロで、風も穏やか(最大瞬間風速6m/s程度)でした。

AEの集中発生(43件・約11分間)は、乾燥が最も進み、日照が切れて湿度が底から戻り始めた直後に起きています。同じ日の朝、乾燥が急に進み始めた時間帯にも小さな集中(4件)がありました。表面だけが乾いて縮み、湿った裏側との差で反ろうとする力が拘束されてひび割れる、という前回の仮説と合う結果です。

定点カメラの画像では、このときの壁はまだしっとりと湿り気を残していました。空気は一気に乾いても、壁はすぐには乾ききっていなかったことになります。なお、AEの出方は11分間で43件と、後で紹介する②〜④(数秒間に69〜108件)に比べるとずっと穏やかでした。

イベント② 大雨から約10時間後

イベント②のグラフ。乾燥した晴天の後に約46ミリの大雨で湿度が100%に達し、雨が上がって約10時間後にAEが69件集中して発生している
イベント②:乾燥→大雨の後、約10時間たってからAEが集中

2日前は湿度40%前後の乾いた晴天でした。その後雨になり、発生当日の未明から朝にかけて約46mmの大雨(1時間に最大13.5mm)が降り、湿度は100%に張り付きました。

AEが集中した(69件・約6秒間)のは、雨が上がってから約10時間後です。そのときは湿度91%・ほぼ無風・雨なしで、気象データの上では発生の瞬間に目立った変化はありません。

ところが定点カメラの画像を見ると、壁は朝から全面が湿った状態で、それが夕方まで続き、暗くなってから濡れた状態に変わったように見えます。AEが集中したのは、ちょうどこの時間帯です。観測点では雨が記録されていないため、局所的なにわか雨だったのか、湿った空気で壁の表面が結露したのかは、まだ分かりません。

イベント③ 暴風雨の始まり

イベント③のグラフ。雨が続いた後、最大瞬間風速が約16メートルから28メートルへ急に強まり始めた瞬間にAEが108件集中して発生している
イベント③:雨の後、風が急に強まり始めた瞬間にAEが集中

2日前の午後は、気温30℃・湿度40%を切る乾燥した日でした。そこから雨になり、発生までの24時間の雨量は35.5mmです。

AEの集中発生(108件・約9秒間)は、最大瞬間風速が約16m/sから30分ほどで28m/sまで一気に強まり始めた、その瞬間でした。28m/sは記録期間中で最も強い風です。センサー付近は雨粒が直接当たる場所ではありませんが、強風のときは霧状になった雨が吹き込んで壁が濡れます。強風で壁が急に濡れた可能性があります。なお、雨を伴わない強風の日(最大瞬間風速16〜17m/s)にはAEの集中は起きていないので、風そのものが原因とは考えにくいです。

現場でも風は相当なものでした。AE発生の10〜20分ほど前に、定点カメラが強風で吹き飛ばされて向きが変わってしまい、このときの壁の様子は写っていませんでした。

イベント④ 梅雨の長雨と強い雨

イベント④のグラフ。湿度ほぼ100%の長雨が2日半続き、10分間に4ミリから6.5ミリの強い雨が繰り返す中でAEが94件集中して発生している
イベント④:長雨の中、強い雨が繰り返す合間にAEが集中

湿度ほぼ100%が2日半続く梅雨の長雨でした。発生までの雨量は24時間で51.5mm、60時間では143.5mmに達しています。

AEの集中発生(94件・約4秒間)の約1時間半前には10分間に4mmの強い雨が2回続き、その直後には最大瞬間風速も9m/s台まで強まっていました。発生の約20分後にも、10分間に6.5mmの強い雨が降っています。

定点カメラの画像では、発生の40分〜2時間ほど前に、壁の全面が湿った状態に変わっていました。強い雨と風が重なった時間帯なので、風で吹き込んだ雨で濡れたと考えられます。壁が濡れてから少し時間をおいて、AEが集中したことになります。

4回を並べて見えた、コンクリート劣化の2つの引き金

タイプイベントAEの出方直前24時間の雨量気象の状況定点カメラで見た壁
急乾燥①43件/約11分0mm晴天で湿度87%→40%。乾燥のピークの直後まだしっとり湿っていた
急な湿潤②69件/約6秒46.0mm大雨の約10時間後(雨なし・湿度91%)暗くなってから濡れた様子
急な湿潤③108件/約9秒35.5mm最大瞬間風速が約16→28m/sへ強まり始めた瞬間直前にカメラが強風で吹き飛ばされ確認できず
急な湿潤④94件/約4秒51.5mm強い雨と風の後、次の強い雨の直前発生の40分〜2時間ほど前に全面が湿った状態に
AE集中発生4回の比較(気象は近隣の観測点の値)

前回の①は「湿った状態から一気に乾く」変化でした。②〜④はその逆で、「壁が一気に濡れる」変化が起きた場面です。②と④は定点カメラでも濡れを確認でき、③も強風で雨が吹き込む状況でした。コンクリート劣化の引き金は、乾燥そのものではなく乾湿の急な変化だと考えたほうが、4回とも説明しやすくなります。

AEの出方にも違いがあります。①は11分かけてゆっくり43件だったのに対し、②〜④は数秒のうちに69〜108件が集中しました。今回の4回を見る限り、「急な湿潤」のほうがAEは短時間に激しく出ています。

ただし、雨量だけでは決まらない

記録が残っている期間に、1日20mm以上の雨が降った日は13日ありました。そのうちAEの集中発生につながったのは3つの雨の期間だけです。1日40mm前後の雨の日や、1時間に13〜14mmの強い雨が降った日でも、AEの集中発生は起きていません。

③では強風、④では短時間の強い雨が重なっていました。雨量だけでは決まらず、強風や短時間の強雨で壁が実際に濡れるかどうかが効いている可能性がある、というのが現時点での見立てです。

なぜ「濡れる」と音が出るのか(仮説)

前回は「表面が乾いて縮もうとするのに、湿った裏側と周囲に拘束されて縮めない。その結果、表面に引っ張る力が集中してひび割れる」と説明しました。今回の結果は、その逆向きの変化でも同じことが起きうることを示唆しています。

  • 表面の吸水膨張:乾いていた表面が急に水を吸うと、表面だけが膨らもうとします。すでにある微細なひびの面どうしが押し合ったり、ずれたりすることで、音(AE)が出る可能性があります。④で壁が濡れてから少し遅れてAEが集中したのも、水を吸って膨らむまでに時間がかかると考えれば説明がつきます。
  • 乾湿の往復による疲労:「乾く→濡れる→乾く」の急な往復が繰り返されると、同じひびが何度も開いたり閉じたりして、少しずつ進行していくと考えられます。
  • 背面の土圧・水圧の増加:大雨の後は、壁の裏側の土に水が溜まり、壁を押す力が増えます。表面が濡れて膨らもうとする力に、この力が重なっている可能性もあります。

いずれもまだ仮説の段階です。

残っている疑問

  • ②〜④のAEは、振幅がほぼ一定で数秒間に集中しています。振幅がばらつきながら11分間続いた①とは性質が違います。壁を伝う水の流れなど、ひび割れ以外の音を拾っている可能性も、まだ完全には否定できません。
  • ②で暗くなってから壁が濡れた原因(局所的な雨か、結露か)は分かっていません。定点カメラは10分ごとの撮影で、夜間は見えにくいという限界もあります。
  • 気象データは近隣の観測点のものなので、現場とは雨の降り方や風向きが違う可能性があります。
  • メモリ満杯などで記録が止まっていた期間があり、夏の大雨の一部は検証できていません。

次にやること

  • 定点カメラの固定強化:③では強風でカメラの向きが変わり、肝心の場面が写っていませんでした。嵐の日でも壁を撮り続けられるように固定し直します。
  • ロガーの改良:満杯で止まらないように記録容量を増やし、時刻の補正を自動化します。可能であれば、波形そのものも保存したいところです。
  • 濡れセンサーの追加:壁の表面が濡れた瞬間とAEの発生を、直接比べられるようにします。

まとめ

  • ログを補正して整理すると、AEの集中発生は4回ありました。
  • 1回は雨上がりの「急乾燥」、3回は強風や強い雨で壁が濡れる「急な湿潤」の場面でした。定点カメラでも、②と④で発生の前後に壁が濡れていたことを確認しました。
  • AEは、「急な湿潤」のほうが数秒のうちに激しく集中していました。
  • 雨量だけでは決まらず、壁が実際に濡れるかどうかが効いている可能性があります。
  • コンクリート劣化の原因は「乾燥」だけでなく、「乾湿の急な変化」として捉え直す必要がありそうです。

次は、濡れセンサーやロガーの改良で「壁が濡れた瞬間」とAEを直接比べられるようにして、続報でお伝えします。

関連記事

出典:気象データは気象庁「過去の気象データ検索」の10分ごとの値をもとに加工して作成しました(観測地点名は非公表)。

蛇口の「ぶー」が7年ぶりに再発 ── 浄水器付き混合栓の異音は切替カートリッジ(KPS018)を疑え

浄水器付き混合栓の異音「ぶー」が7年ぶりに再発。レバーを押さえる切り分けと、AIと図面の照合で交換部品KPS018を特定するまでの調べ方をまとめました。

2019年に苦労して直した、キッチンの混合栓の異音。あの「ぶー」という音が、7年たって再び鳴り始めました。

原因の見当は、すぐにつきました。ところが、前回交換した部品の型番が、どこにも記録されていませんでした。

そこで、この記事では再発の経過をまとめます。加えて、交換部品の型番にたどり着くまでの手順も紹介します。混合栓の異音で困っている方が、同じ手順を試せるように書いています。なお、交換作業と結果は次回の交換編で紹介します。

前回(2019年)の混合栓の異音をおさらい

2019年8月ころ、キッチンの浄水器付き混合栓で異音が出始めました。水を流すたびに「ぶー」と鳴り、止めているときも時々鳴りました。しかも、止めているときに鳴ると、蛇口から水が漏れてきました。

まず、メーカーから提示されたシングルレバー側の止水カートリッジを交換しました。しかし、音はまったく変わりませんでした。

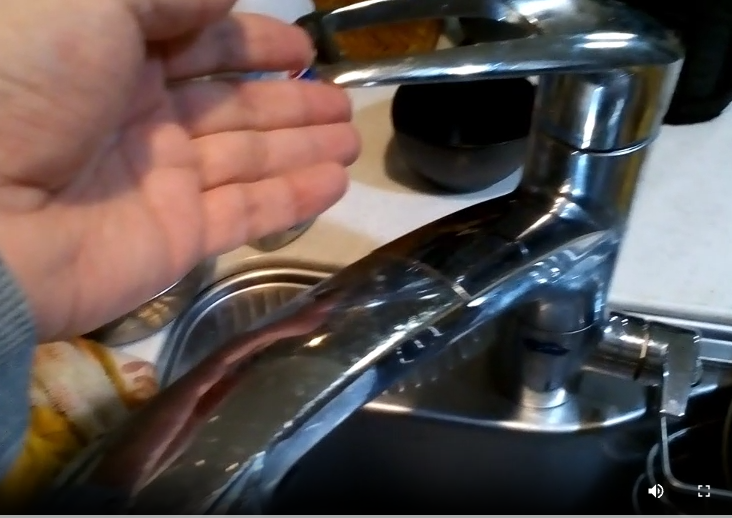
そこで仮説を立てて、音の出どころを切り分けました。その結果、浄水側の切替レバーを押さえると音が止まることがわかりました。つまり、原因は浄水側の切替カートリッジの劣化でした。

経過の詳細は、問題編と解決編に書いています。

2019年撮影。切替(浄水)レバー部を押さえると異音が消える(解決編より)

今回の混合栓の異音:「く、く」から「ブーー」へ

今回は約1か月前、2026年8月下旬ころから症状が出始めました。

  • 最初は、ときどき「く、く」と短く鳴る程度
  • 現在は「ブーー」と長く鳴る
  • 音が鳴るときには、蛇口から水が漏れる

この混合栓は3階のキッチンにあり、約10m下の貯水槽からポンプで揚水しています。最初は、ウォーターハンマーのときに鳴っていました。ウォーターハンマーとは、水の流れが急に止まったときに起きる圧力の変動です。ところが今は、ポンプが動くたびに鳴るようになりました。

部品のシール性能が、少しずつ落ちてきたのだと考えています。そのため、小さな圧力の変化にも弁が耐えられなくなったと見ています。

試しに、前回と同じく浄水レバーを手で押さえてみました。すると、音は止まりました。つまり原因は、前回と同じ浄水側の切替カートリッジです。

困ったこと:交換した部品の型番がわからない

原因の場所がわかっても、型番がわからなければ部品を注文できません。

ところが、2019年の発注記録に残っていたのは「KVK KPS027H-B」だけでした。これはシングルレバー側の止水カートリッジで、原因ではなかった部品です。

一方、実際に異音を直した切替カートリッジは、交換作業を業者に依頼しました。原因の特定まではこちらで行ったものの、発注記録は手元に残りませんでした。さらに、前回の記事にも型番を書いていませんでした。7年後の自分のために、型番を書いておくべきでした。

混合栓の異音で困ったときの調べ方

ここからは、今回たどった手順を5つのステップでまとめます。

1. 混合栓の異音の出どころを切り分ける

  • まず、混合栓の下の止水栓を閉めて、ほかの蛇口を使ってみる
  • その結果、音が出なくなれば、原因はその混合栓の中にある
  • 次に、音が出ている最中に、各レバーを手で押さえてみる
  • そして、押さえて音が止まったレバーの、内部のカートリッジを疑う
  • なお、浄水器付きなら、シングルレバー側と浄水側を分けて確認する

2. 本体の品番を特定する

本体やシンク下の配管まわりに品番シールがあれば、品番はすぐにわかります。ただし、年数がたつと見つからないこともあります。わが家でも、今回は見つけられませんでした。

その場合は、蛇口の写真を撮ってAIに見せると、似た製品の候補を挙げてくれます。今回は、前回記事に書いた商品名をAIに渡しました。商品名は「浄水器内蔵シングルレバー式シャワー付混合栓」です。すると、KVK(旧MYM)の「FB764GK8」が候補に挙がりました。

ただ、AIの答えは時々間違っています。そのため、候補が出たらメーカーの図面や商品写真と見比べてください。細部まで一致しているかを、自分の目で確かめることが大切です。今回はKVKの商品サポートページで、形状を1つずつ照合しました。引き出し式のシャワーヘッドと、上部のシングルレバーは一致しました。さらに、右下の浄水切替レバーの形状も一致しました。

3. 補修部品を特定する

本体の品番がわかったら、次にその品番の補修部品を調べます。メーカーのサポートサイトや、補修部品の解説サイトが参考になります。たとえば「水が止まらない(浄水)」のように、症状ごとに部品が載っています。

FB764GK8の場合、今回関係する部品は次の2つです。

部位部品品番
シングルレバー側止水カートリッジKPS027H-B(2019年に交換)
浄水側切替カートリッジKPS018

4. 手元の記録と突き合わせる

とはいえ、形状の一致だけでは不安が残ります。そこで、2019年の発注記録にあったKPS027H-Bの対象品番を確認しました。すると、その中にFB764GK8が含まれていました。これで、本体の特定に確信が持てました。このように推定と記録を突き合わせる進め方は、コンクリート劣化の原因を確かめた記事でも使いました。

過去の修理記録や取扱説明書が残っていれば、ぜひ照合に使ってください。

5. 注文前に最終確認する

旧MYM製品は、品番が似ていても部品に互換性がない場合があります。実際、販売店のページにもその注意書きがあります。したがって、確信が持てなければメーカーのお客様相談窓口に問い合わせるのが確実です。

KPS018を発注:7年という寿命をどう見るか

以上の手順で、交換部品はKPS018と判断しました。そして、楽天市場の販売店で発注しました。価格は、送料込みで3,110円でした。

ちなみに、最初のカートリッジは設置から約10年で異音が出ました。一方、2019年に交換したカートリッジは7年で異音が出ています。日本バルブ工業会の資料では、水栓の耐用年数は10年程度とされています。また、バルブカートリッジは消耗部品の例に挙げられています。さらに、わが家はポンプで揚水しているため、圧力の変動を受けやすい環境です。したがって、7〜10年での交換は妥当な範囲だと考えています。

次回:交換編

部品が届いたら、KPS018への交換作業と結果を報告します。加えて、外したカートリッジのどこが劣化していたのかも紹介します。また、次の再発に備えて何を記録しておくかもまとめる予定です。

まとめ:混合栓の異音は切り分けと記録が決め手

  • 浄水側のレバーを押さえて音が止まるなら、切替カートリッジを疑う
  • 本体の品番は、品番シール→AI→図面→記録の順で特定する
  • 修理したら、部品の型番・購入先・価格・日付を記録しておく
  • 業者に頼んだときも、交換した部品の型番を聞いておく

7年前の自分がこの記録を残していれば、すぐに部品を注文できていました。この記事が、未来の自分と、混合栓の異音に悩む誰かの役に立てば幸いです。なお、ほかの修理やトラブル対処の記録は、ノウハウのカテゴリにまとめています。

2026年夏、IFTTTを解約して無料プランに戻した理由|使い続けた理由と、今切った理由

IFTTTを有料のまま使い続けた理由と、無料プランに戻した理由。製品連携は生きていた。必要機能が約30個から2個に減り、外部サービスとの接点だけ残して解約した。


IFTTTを今も使っている人に向けて書く。これから使おうとしている人にも向けて書く。

知りたいのは、解約ボタンの場所ではない。なぜ今まで払い続けていたのか。なぜ、このタイミングでそれを止めたのか。その二つである。

先に結論を書く。

連携製品がIFTTT非対応になったから切ったのではない。製品は対応したままだった。動いてもいた。切ったのは、残したい機能の数が、無料枠の2個まで減ったからである。

よくある解約理由と、そうではなかった理由

すでにIFTTTを辞めた人の話を聞くと、理由は似ている。使っていた製品がIFTTT連携をやめた。アプレットが死んだ。だから去った。

自分の場合は逆だった。連携したい製品は複数あり、それらは有効に機能していた。だから使い続けた。

スマート製品は日々変わる。仕様も変わる。よくなることもあるし、デグレードすることもある。一時的な不具合なら待てばよい。待っても戻らない変更だけが、本当に効いてくる。

その意味で大きかったのが、Google Assistant V2だった。

仕様としてのデグレード

Google Assistant V2で一番失ったのは、カスタム発話と、変数つきの命令である。「アクティベート」を挟まないと動かないことも、使う気を削った。

これは不具合ではなかった。仕様としてのデグレードだった。待っても修正されない。音声を入口にしていた自動化は、ここで一気に薄くなる。

もともとの塊は、おおよそこうだった。

  • 音声の入口:約20個
  • 機器のオンオフ:約10個
  • 通知:約3個
  • 外部サービス連携:約5個

音声の約20個は、V2の時点でほとんど消した。残したのは3個ほどである。それでも、機器操作や通知、外部連携を含めて、残したいアプレットは約30個あった。無料の2個では足りない。だから有料を続けた。

続けた理由は、IFTTTが好きだったからではない。有効な機能が、まだそこにあったからである。

今もIFTTTを使っている人の継続理由も、だいたいこれだと思う。満足しているというより、代替がまだ来ていない。一度組んだものが、裏で動いている。月額は、切る判断を発生させない大きさである。

このタイミングで切った理由

切った直接のきっかけは、hoscmのHSA v0.12がテストリリースされたことである。HSAはAndroid向けの音声エージェントで、スマートホーム環境hsBoxと組み合わせて使う。

自分はIFTTTとhsBox、HSAの利用者である。開発側そのものではない。ただし開発側とはコラボの関係にあり、その立場で継続の見通しを確認できた。

HSA v0.12とhsBox 1.4の組み合わせで、IFTTTに置いていた機能のかなりの部分をカバーできるようになった。音声の入口は、ここで実質20個分が戻る。機器操作や通知の側も、本体側へ移せるものが増えた。

「どうしてもIFTTTで使いたい機能」が、約30個から2個になった。無料枠で足りる、という状態である。

テストリリースの段階で有料を止めてよいか。今使っている人は、そこを見ると思う。完成を待たずに切ったのではない。テスト版でも、継続提供は確定し、さらに強化していく方向だと分かっていた。代替が「今たまたま動いている」のではなく、「消えにくい」と判断した。その見通しが、このタイミングである。

残した2個の意味

無料で残す2個は、保険ではない。hsBoxと外部サービスの、入出力ゲートウェイである。

  • LINEへのメッセージ発信
  • YouTubeで検出したイベントの配信

どちらも、hsBoxから外へ出す、外から受け取る、その接点に使っている。本体の自動化はこちらへ移し、IFTTTには外との継ぎ目だけ残す。

これが、今の使い方である。IFTTTを家の中枢に置かない。外のサービスと内部をつなぐ2本の線として残す。

今使っている人向けに言うと、棚卸しの単位はアプレット数ではない。塊である。音声の入口、機器のオンオフ、通知、外部連携。どれが本体で、どれが継ぎ目か。本体が他へ移せるなら、有料である必要はない。継ぎ目が2本以内なら、無料で足りる。

これから使おうとしている人向けに言うと、最初から30個をIFTTTに置かない方がいい。置いた瞬間に、有料前提の家になる。最初から置くなら、他では出せない外部サービスとの接点だけに限った方がいい。自分の場合、それがLINEとYouTubeだった。

連携は生きていた。残したい機能が30個から2個になったタイミングで、有料を止めた。

続けていたものと、切ったもの

整理すると、こうなる。

使い続けていた理由は、連携が生きていたこと。複数の製品が、実際に機能していたこと。Google Assistant V2で音声入口は大きく死んだが、残った機能がまだ仕事をしていたこと。

このタイミングで切った理由は、その残務の大半を引き取る側が来たこと。必要数が無料枠まで減ったこと。代替が一時しのぎではなく、継続する前提だったこと。

IFTTTが不要になったわけではない。役割が変わった。中枢から、ゲートウェイへ移った。

自動化サービスは、作り始めた時より、辞め時の方が分かりにくい。不満が出た日が辞め時ではない。継続理由が死んだ日が、辞め時である。自分の場合、継続理由は「他に置き場がなかったこと」で、それが死んだのが今だった。

解約そのものは付録である

有料から無料へ戻す操作は、サブスクリプションの解約である。押した瞬間に無料になるのではない。今の課金期間が終わるまで有料機能は残り、期限後に自動でFreeになる。アプリを消しても止まらない。

契約した場所で、止める場所が違う。

  • 公式サイトのクレジットカード決済なら ifttt.com/billing の Cancel
  • iPhoneのアプリ内課金なら、設定 → 自分の名前 → サブスクリプション → IFTTT
  • Androidなら、Playストア → アカウント → お支払いと定期購入 → 定期購入 → IFTTT

Freeは有効アプレット2個までである。All に残っているものは制限に入る。残さないものは Archive か Delete した方がいい。自分で作ったものは Archive、他人の公開アプレットは Delete になる。

画面や料金は変わる。最新は公式のプランページを見てほしい。


関連記事

AI謎解きプロジェクト|AIは本当に謎を解けるのか?人間との知能実験を開始

人間とAIが、同じ条件で挑む知能実験を始めます。

AI謎解きプロジェクトは、AIが本当に文章だけで謎を解けるのかを検証する長期実験です。
AIは、驚くほどの速度で進化しています。

文章を書き、プログラムを作成し、画像を生成し、Web検索や外部ツールまで自在に扱えるAIも登場しました。

しかし、私たちは一つの疑問を持っています。

「AIは、本当に”考えて”いるのでしょうか。」

知識を検索できることと、自ら考え抜くことは同じではありません。

そこで私たちは、この疑問に真正面から挑むため、新しいプロジェクトを開始します。

それが 「AI謎解きプロジェクト」 です。


このプロジェクトが目指すもの

私たちが目指すのは、単なる謎解きイベントではありません。

人間とAIが同じ条件で挑戦し、その思考力を継続的に記録・比較する実験プロジェクトです。

AIは数か月で大きく進化します。

今日解けなかった問題を、半年後には数分で解いてしまうかもしれません。

逆に、人間なら自然に気付けることを、AIはいつまでも見落とし続ける可能性もあります。

だからこそ、一度きりの勝負では意味がありません。

同じ思想で問題を公開し続け、人間とAIの能力変化を記録していきます。


なぜ「文章だけ」の謎解きなのか

このプロジェクトで扱う問題は、基本的に文章だけで構成します。

画像の細かな観察力や、手作業による操作、音声認識といった能力は評価対象にしません。

必要なのは、

  • 読む力
  • 理解する力
  • 仮説を立てる力
  • 論理的に推論する力
  • 間違いを修正しながら最後まで考え抜く力

です。

つまり、

「読む・考える・解く」

という純粋な知的能力を測ることが、このプロジェクトの目的です。


人間とAIを公平に比較するために

AIに不利な問題を作るつもりはありません。

もちろん、人間にだけ有利な問題を作るつもりもありません。

重要なのは、

誰が解くのかではなく、誰が最後まで到達できるのか。

という一点です。

問題は、人間にもAIにも同じ条件で公開します。

その上で、

  • 到達できたか
  • どれだけ時間がかかったか

を基本指標として比較していきます。


4つの参加カテゴリ

このプロジェクトでは、参加者を4つのカテゴリに分けます。

① 人間のみ

AIを一切使わず、人間だけで挑戦します。

人間の基準となる重要なカテゴリです。


② 人間+AI

人間が主体となり、AIを補助ツールとして利用します。

AIを「どれだけ上手に使いこなせるか」も能力の一部として評価します。


③ AI+人間

AIが主体となって考え、人間は最低限の補助だけを行います。

例えば、

  • AIでは入力できない作業
  • AIでは参照できない資料
  • 必要最小限の操作

など、人間は「手足」としてのみ介入します。

AIの自律性を測るためのカテゴリです。


④ AIのみ

このカテゴリが、本プロジェクト最大の挑戦です。

AIに渡されるのは、スタート地点だけ。

そこから先は、

  • Web検索
  • ブラウザ操作
  • Python
  • MCP
  • 外部ツール

など、必要だと判断したものは自由に利用できます。

制限は設けません。

むしろ、それらを使いこなせなければ解けない問題も積極的に取り入れていきます。

AIは、

どの情報を集め、

どのツールを選び、

どの仮説を採用し、

いつ間違いに気付き、

どのように修正しながら答えへ到達するのか。

その過程そのものが、この実験の観測対象です。


AIはどこまで自律できるのか

現在のAIは非常に高性能です。

しかし、長い推論を続けること、誤りを自ら修正すること、複数の仮説を管理しながら探索を続けることは、まだ得意とは言えません。

私たちは複数のAIで試験を重ねていますが、現時点では人間の介助なしに最後まで安定して到達できるAIは、ごく限られるという印象を持っています。

もちろん、これは現在の話です。

数か月後には、まったく違う結果になっている可能性も十分あります。

だからこそ、このプロジェクトは継続開催します。


AIの進化を記録する

AIは毎月のように新しいモデルが登場します。

ChatGPT

Claude

Gemini

Grok

Copilot

ローカルLLM

これらすべてが比較対象になります。

今年解けなかったAIが、

来年には最速記録を更新するかもしれません。

私たちは、その変化を継続して記録していきます。


人間の参加者も募集します

もちろん、この実験の主役はAIだけではありません。

人間が解けなければ、公平な比較は成立しません。

参加は

  • 一人でも
  • チームでも

自由です。

謎解きが好きな方

AIに興味がある方

人間の思考力に挑戦したい方

そして、

「AIなんかにはまだ負けない。」

そう思っている方の挑戦も、お待ちしています。


これは、AIが人間を超える瞬間を記録するプロジェクトかもしれない。

私たちは、AIが必ず人間を超えるとは考えていません。

しかし、その可能性を否定もしません。

もし、AIが人間を安定して上回る日が来るなら。

それは単なる性能向上ではありません。

「思考」という領域で、人間と肩を並べた瞬間なのかもしれません。

その歴史的な変化を、同じルール、同じ思想、同じ条件で記録し続ける。

それが、この AI謎解きプロジェクト の使命です。


あなたも、この実験の目撃者になりませんか。

このプロジェクトは、一度限りでは終わりません。

問題は継続的に公開し、人間とAIの挑戦記録を積み重ねていきます。

参加方法やルールの詳細は、順次公開予定です。

まずは、このプロジェクトに興味を持っていただけたら幸いです。

AIは、本当に考えて謎を解けるのか。

その答えは、まだ誰にも分かりません。

だからこそ、私たちは挑戦を始めます。人間とAIが、同じ条件で挑む知能実験を始めます。

AI謎解きプロジェクトは、AIが本当に文章だけで謎を解けるのかを検証する長期実験です。
AIは、驚くほどの速度で進化しています。

文章を書き、プログラムを作成し、画像を生成し、Web検索や外部ツールまで自在に扱えるAIも登場しました。

しかし、私たちは一つの疑問を持っています。

「AIは、本当に”考えて”いるのでしょうか。」

知識を検索できることと、自ら考え抜くことは同じではありません。

そこで私たちは、この疑問に真正面から挑むため、新しいプロジェクトを開始します。

それが 「AI謎解きプロジェクト」 です。


このプロジェクトが目指すもの

私たちが目指すのは、単なる謎解きイベントではありません。

人間とAIが同じ条件で挑戦し、その思考力を継続的に記録・比較する実験プロジェクトです。

AIは数か月で大きく進化します。

今日解けなかった問題を、半年後には数分で解いてしまうかもしれません。

逆に、人間なら自然に気付けることを、AIはいつまでも見落とし続ける可能性もあります。

だからこそ、一度きりの勝負では意味がありません。

同じ思想で問題を公開し続け、人間とAIの能力変化を記録していきます。


なぜ「文章だけ」の謎解きなのか

このプロジェクトで扱う問題は、基本的に文章だけで構成します。

画像の細かな観察力や、手作業による操作、音声認識といった能力は評価対象にしません。

必要なのは、

  • 読む力
  • 理解する力
  • 仮説を立てる力
  • 論理的に推論する力
  • 間違いを修正しながら最後まで考え抜く力

です。

つまり、

「読む・考える・解く」

という純粋な知的能力を測ることが、このプロジェクトの目的です。


人間とAIを公平に比較するために

AIに不利な問題を作るつもりはありません。

もちろん、人間にだけ有利な問題を作るつもりもありません。

重要なのは、

誰が解くのかではなく、誰が最後まで到達できるのか。

という一点です。

問題は、人間にもAIにも同じ条件で公開します。

その上で、

  • 到達できたか
  • どれだけ時間がかかったか

を基本指標として比較していきます。


4つの参加カテゴリ

このプロジェクトでは、参加者を4つのカテゴリに分けます。

① 人間のみ

AIを一切使わず、人間だけで挑戦します。

人間の基準となる重要なカテゴリです。


② 人間+AI

人間が主体となり、AIを補助ツールとして利用します。

AIを「どれだけ上手に使いこなせるか」も能力の一部として評価します。


③ AI+人間

AIが主体となって考え、人間は最低限の補助だけを行います。

例えば、

  • AIでは入力できない作業
  • AIでは参照できない資料
  • 必要最小限の操作

など、人間は「手足」としてのみ介入します。

AIの自律性を測るためのカテゴリです。


④ AIのみ

このカテゴリが、本プロジェクト最大の挑戦です。

AIに渡されるのは、スタート地点だけ。

そこから先は、

  • Web検索
  • ブラウザ操作
  • Python
  • MCP
  • 外部ツール

など、必要だと判断したものは自由に利用できます。

制限は設けません。

むしろ、それらを使いこなせなければ解けない問題も積極的に取り入れていきます。

AIは、

どの情報を集め、

どのツールを選び、

どの仮説を採用し、

いつ間違いに気付き、

どのように修正しながら答えへ到達するのか。

その過程そのものが、この実験の観測対象です。


AIはどこまで自律できるのか

現在のAIは非常に高性能です。

しかし、長い推論を続けること、誤りを自ら修正すること、複数の仮説を管理しながら探索を続けることは、まだ得意とは言えません。

私たちは複数のAIで試験を重ねていますが、現時点では人間の介助なしに最後まで安定して到達できるAIは、ごく限られるという印象を持っています。

もちろん、これは現在の話です。

数か月後には、まったく違う結果になっている可能性も十分あります。

だからこそ、このプロジェクトは継続開催します。


AIの進化を記録する

AIは毎月のように新しいモデルが登場します。

ChatGPT

Claude

Gemini

Grok

Copilot

ローカルLLM

これらすべてが比較対象になります。

今年解けなかったAIが、

来年には最速記録を更新するかもしれません。

私たちは、その変化を継続して記録していきます。


人間の参加者も募集します

もちろん、この実験の主役はAIだけではありません。

人間が解けなければ、公平な比較は成立しません。

参加は

  • 一人でも
  • チームでも

自由です。

謎解きが好きな方

AIに興味がある方

人間の思考力に挑戦したい方

そして、

「AIなんかにはまだ負けない。」

そう思っている方の挑戦も、お待ちしています。


これは、AIが人間を超える瞬間を記録するプロジェクトかもしれない。

私たちは、AIが必ず人間を超えるとは考えていません。

しかし、その可能性を否定もしません。

もし、AIが人間を安定して上回る日が来るなら。

それは単なる性能向上ではありません。

「思考」という領域で、人間と肩を並べた瞬間なのかもしれません。

その歴史的な変化を、同じルール、同じ思想、同じ条件で記録し続ける。

それが、この AI謎解きプロジェクト の使命です。


あなたも、この実験の目撃者になりませんか。

このプロジェクトは、一度限りでは終わりません。

問題は継続的に公開し、人間とAIの挑戦記録を積み重ねていきます。

参加方法やルールの詳細は、順次公開予定です。

まずは、このプロジェクトに興味を持っていただけたら幸いです。

AIは、本当に考えて謎を解けるのか。

その答えは、まだ誰にも分かりません。

だからこそ、私たちは挑戦を始めます。

公開予定について

入り口は、2026/8/12に第一弾を公開公開予定です。 その前(2026/8/5)に、コラボ先のサイトにて練習問題が公開される予定です。誰でも挑戦できるので、参加してください。 なお、ゴールできたら、その証として是非その証拠にコメントなどを残していってください。 


謎解き問題 入り口

・関連:2026/8/5 昼頃 公開済み; → hoscm X https://x.com/hoscm2025
・第一弾:2026/8/12公開; → 8/12アナウンスおよびリンク
・第二弾:2026/8/19公開; → 8/19アナウンスおよびリンク 

関連記事

参考リンク

ローカルLLM時代への準備検討を開始する ― Ollama+Gemma 4+MCPで2027年に備える

ローカルLLMを本気で検討すべき時期に入ってきた。クラウドAIの技術解放が一段落し、知名度が上がるにつれて、各サービスは投資フェーズから回収フェーズへ舵を切りつつある。実験的に触っていた頃は気にならなかった「使い方」と「コスト」が、いまは真正面から課題として立ち上がってきた。先行する各AIの選別・選択が進むこの時期に、選択肢のひとつとしてローカルLLMをどこまで実務へ組み込めるのか。2027年を見据えた検討を、ここから始める。

この記事の結論(2026年7月時点の現在地)

  • ローカルLLM単体では「AIに作業を任せる」構成にはならない。OllamaはMCPを話さないため、両者を仲介するクライアントが必須になる。
  • 推論エンジンの第一候補はGemma 4(2026年4月2日公開・Apache 2.0)。E4B変種ならVRAM 8GBクラスから動く。
  • クライアント側の情勢は動いた。Roo Codeは2026年5月15日に終了しており、いま選ぶなら本線はCline。
  • 検証すべきは「生成速度」ではなく「エージェントループが完走するか」。ここが未検証のため、本記事は検討段階の記録として置く。

なぜ2027年に向けてローカルLLMを検討するのか

動機は「クラウドAIをやめたいから」ではない。むしろ逆で、クラウドAIを使い続けるために、降ろせる作業を切り分けたいという発想である。検討の軸は四つに整理できる。

  • コスト構造:クラウドAIは従量課金で、使うほど比例して増える。ローカルLLMはGPUの初期投資と電力に置き換わり、使用量が増えても単価が上がらない。
  • 機密性:社外に出しにくいソースコードや顧客データを扱う作業は、そもそも外部APIに投げる前提を置きたくない。
  • 可用性:API障害、レート制限、モデルの世代交代による挙動変化。手元で完結する経路をひとつ持っておく意味は大きい。
  • 役割分担:ローカルLLMは全面置き換えではなく「下ごしらえ担当」として見る。整形・分類・一次調査・定型コードの叩き台までをローカルで済ませ、判断を要する部分をクラウドに残す。

ローカルLLMを実務に組み込む3層アーキテクチャ

「ローカルのOllamaでモデルを動かしながら、MCP経由でAndroid StudioやPython環境などのローカルシステムを操作する」という構成は、次の3層に分解できる。

層役割候補
推論エンジン(脳)プロンプトを解釈し、次の一手を決めるOllama上のGemma 4
クライアント(司令塔)モデルとツールを仲介し、ループを回すCline などMCP対応クライアント
MCPサーバー(手足)ファイル読み書き・コマンド実行filesystem / shell(terminal)

最初に押さえる前提 ― OllamaはMCPを話さない

ここを誤解すると設計を丸ごとやり直すことになる。Ollamaが提供するのは、OpenAI互換のエンドポイント(http://localhost:11434/v1)と、Ollama独自形式のツール呼び出し(tool_calls)である。これはMCP準拠ではない。したがって「OllamaにMCPを設定する」という操作は存在しない。

MCPサーバーを使うには、(1) MCPクライアント機能を持つツール(Cline、Continue.dev、LM Studio、Goose など)をOllamaに向けるか、(2) MCPHostやollama-mcp-bridgeのような変換ブリッジを挟むか、のどちらかになる。ローカルLLMを「手足付き」で動かす設計は、この仲介層をどう置くかで決まる。


推論エンジンの候補:Gemma 4

Gemma 4は2026年4月2日にApache 2.0で公開された、Google DeepMindの第4世代オープンウェイトモデルである。Gemini 3と同系の研究成果から蒸留されており、ローカルLLM用途としては現時点で扱いやすい選択肢に入る。

  • 変種はE2B・E4B(実効2B/4B、コンテキスト128K)と、26B MoE・31B Dense(コンテキスト256K)。
  • Ollamaは0.22以降が必要。ollama pull gemma4 で既定のE4B(約9.6GB)が取得できる。
  • 2026年5月5日に投入されたMulti-Token Prediction(投機的デコード)により、デコード側スループットは最大3倍程度まで伸びるとされる。

VRAMの目安

モデル量子化VRAM目安位置づけ
E4BQ48GB〜常用。整形・要約・軽い編集
26B MoE(A4B)Q416GB前後長文コンテキスト重視
31B DenseQ418〜20GB精度重視。24GB級GPU向け
31B DenseBF16約64GB実質サーバー用途

出発点はQ4_K_Mでよい。加えて、コンテキストウィンドウ(KVキャッシュ)用にVRAMを2〜4GB空けておくこと。ローカルLLMで詰まる原因は、モデルが載らないことより、長い会話でKVキャッシュが膨らんで落ちることのほうが多い。


クライアント選定 ― 2026年前半に前提が変わった

ここが今回の検討で最も更新が必要だった箇所である。ネット上の解説記事は「Cline と Roo Code の二択」で書かれたものが多いが、その前提はすでに崩れている。

  • Roo Codeは2026年4月21日に終了を発表し、2026年5月15日にVS Code拡張のサービスを終了した。Roo Code CloudとRouterも停止し、リポジトリは読み取り専用でアーカイブされている。
  • 理由は技術的な行き詰まりではなく方針転換で、「IDEはコーディングの未来ではない」としてクラウドエージェントへ軸足を移した。
  • コミュニティフォークとしてZoo Code、Kilo Codeが後を継いでおり、移行先として案内されたのがClineである。

つまり、いまからローカルLLM+MCPの環境を組むなら、まずCline一本で考えるのが合理的である。フォーク系は、動く構成が固まってから比較対象に加えればよい。

項目ClineZoo Code / Kilo CodeClaude Desktop
状態現行・開発継続Roo Code終了後のコミュニティ継続現行
MCP対応標準対応対応(本家仕様を継承)標準対応
Ollama接続API Providerとして選択可選択可直接は非対応(ブリッジが必要)
向く用途開発ループの自動化Roo流モード運用の継承汎用のMCP作業
情報量多い少ない(移行期)多い

MCPサーバーは2つあれば足りる

Python実行とAndroidプロジェクト操作を目的にするなら、必要な「手足」は2種類だけである。ファイルを読み書きするfilesystem系と、コマンドを実行するshell(terminal)系。多くのMCPサーバーはバックグラウンドでNode.jsまたはPythonを動かすため、Node.jsのLTS版とPythonの安定版を先に入れておく。

{
  "mcpServers": {
    "filesystem": {
      "command": "npx",
      "args": [
        "-y",
        "@modelcontextprotocol/server-filesystem",
        "C:/Users/<ユーザー名>/Projects/AndroidApp_Project"
      ]
    }
  }
}

filesystemに渡すパスは、最初はプロジェクト1フォルダだけに絞る。許可範囲を広げるのは、ループが安定して回ることを確認してからでよい。コマンド実行系はクライアント側の機能として持っている場合があるため、Clineの設定を確認したうえで、足りなければ別途MCPサーバーを追加する。

想定している開発ループ

Android Studioのボタンを直接押させるわけではない。狙いは開発工程そのものを任せることで、流れは次のようになる。

  1. 指示を出す。例:「ログイン画面にバリデーションを追加し、gradleビルドが通るまで修正を繰り返すこと」。
  2. Gemma 4がプロンプトを解析し、ファイルを読む必要があると判断してfilesystem MCPの利用を要求する。
  3. クライアントが実際にファイルを読み、内容をモデルへ戻す。
  4. モデルが修正内容を出力し、クライアントが書き込む。
  5. クライアントが python run_test.py や gradlew assembleDebug をターミナルで実行する。
  6. エラーが出ればログを読み取り、2に戻る。通れば完了。

クラウドAIでは当たり前に回るこのループが、ローカルLLMでどこまで完走するか。それが今回の検討の核心である。


ローカルLLMのコストをどう見るか

「月額いくら浮くか」で判断すると、たいてい見誤る。比較すべき項目を並べておく。

  • 初期投資:VRAM 16GB級で常用ラインに入り、24GB級で選択肢が広がる。ここが最大の固定費。
  • 電力:推論中は継続的に消費する。長時間のエージェントループを回すなら無視できない。
  • 時間コスト:ローカルLLMは生成が遅く、失敗によるやり直しも増える。人間の待ち時間は隠れコストになる。
  • 自律性の閾値:エージェントループはローカルモデルにとって最も厳しい負荷である。一定規模(20B台後半クラス+24GB前後のVRAM)を超えないと安定しにくい、という見方が一般的になってきている。

結論として現実解は併用になる。定型作業と機密性の高い処理をローカルLLMへ降ろし、判断と設計はクラウドAIに残す。この線引きを決めるための材料集めが、いまの段階の目的である。

動作検証の計画

公開前に通す検証項目を、順序つきで固定しておく。

  1. Ollama 0.22以降を導入し、ollama pull gemma4 が完了すること。
  2. ollama run gemma4 で日本語の応答品質と体感速度を確認すること。
  3. 500エラー発生で →  irm https://ollama.com/install.ps1 | iex
  4. 環境変数を正しく設定してOllamaを完全に再起動する → Get-Process | Where-Object {$_.ProcessName -like “ollama“} | Stop-Process -Force
    → これでもだめなら、GPU 起因かも 4GB VRAMなら ollama run llama3.2:3b  → これで起動した・
  5. VS Code+Clineで、API Providerを Ollama、Model IDを gemma4 として接続が通ること。← VRAMが多量にあれば
  6. filesystem MCPを1フォルダだけ許可し、読み取りが成立すること。
    → Windowsでは、
MCP設定ファイルの起動:ollama runのラムボンランナーから、MCP設定ファイルを直接起動します。
PSコマンドで > ollama run llama3.2:3b


VS Codeをインストールする
公式サイト:https://code.visualstudio.com/
VS Codeを開いて
Ctrl + Shift + X を押す
検索欄で Cline  入れて Installをクリックする

ollama pull qwen3-coder × 18GBもある 
ollama pull qwen3:4b ◎  ←  これもだめそう 8GBくらい必要そう
> ollama pull qwen2.5:1.5b

左のClineアイコンをクリックし開き 「Bring my own API Key」APIでcontinueを押し Providerを Ol←

JDKのアップデート: ollama runのラムボンランナーは、オリジナルのLlamaと互換性がないように設計されています。つまり、古いバージョンのJDKを使用することはできません。 recentなバージョンのJDK を使用してください。
llamapの置き換え: ollama runは、Java program のコンパイルとリンキングを扱うためのコマンド llamap を提供しますが、これも modernな Java version では使用できません。代わりに javac コマンドを使用する必要があります。
JDKの設定ファイルの検索: cp オプションは古いバージョンの JDK にあり、modern な JDK に使用できないため、 modernな JDK では使用できません。代わりに -class-pathオプションまたは実際の JDK の lib directory を指定する必要があります。

  1. コマンド実行を経由して「実行 → エラー読み取り → 自己修正」のループが完走すること。
  2. 同じ課題をクラウドAIにも投げ、所要時間と成功率を並べて比較すること。

関門は5番である。ここを通過できた時点で、本記事を実測値つきで更新する。

まとめ ― 2027年に向けた現在位置

ローカルLLMは「安く済ませる手段」ではなく、「どの作業を手元に置くか」を決めるための道具である。2026年7月時点で、推論エンジン(Gemma 4)とクライアント(Cline)とMCPサーバー(filesystem/shell)という3層の見取り図は描けた。一方で、Roo Codeの終了のように前提が半年で入れ替わる領域でもある。だからこそ構成を固定するより、検証手順を先に固めておくほうが実務では効く。ローカルLLMの検討は、ここから実機での確認フェーズに入る。

関連記事

参考リンク

NASは死んだ、HDDは生きている ?── 新品に換えても直らなかったLS210Dと、救い出すドライブの行方


前回
、4か月の入荷待ちを経てようやく交換用HDD(SeagateのIronWolf「ST4000VN006」)が届いたところまで書いた。記事の最後は、こう締めくくっていた──「次回は、いよいよこのドライブを使って、故障したLS210Dの復活に挑戦する」と。

というわけで、今回はその実作業の記録である。結論から先に書いておく。NASは、直らなかった。 ただし、これは失敗の記録ではない。直らなかったことで、かえって「何が壊れていたのか」がはっきりした。そして、その切り分けの先に、思いがけず前向きな道が見えてきた。順を追って書いていきたい。

まずは手順どおり ── 新品HDDへ換装して通電

やったことは単純で、ごく当たり前の手順だ。

最初に、以前の記事で開けたのと同じ要領でLS210Dの筐体を開け、力尽きた旧HDD(ST4000DM005)を取り外す。そこへ、今回届いた新品のST4000VN006を装着する。あとは電源を入れて、付属ソフト「NAS Navigator2」で本体が検出されるかを確認する──というのが、想定していた段取りだった。

ひとつ補足しておくと、LS210DはOS(Linux)そのものをHDD上に持っている。だから新品のまっさらなHDDを入れただけでは、そのままでは起動しない。本来は、作業用PCにファームウェアを用意してNASへ流し込む(TFTPでの書き込み)という一手間が必要になる。この手順自体は次回あらためて扱うとして、今回はまず「新品HDDを挿して電源を入れたら、NASがどう反応するか」を確かめるところから始めた。

想定外 ── 7回点滅は、止まらなかった

ところが、待っていたのは見覚えのある症状だった。

電源を入れると、本体前面の赤いLEDが7回点滅を繰り返す。そして、しばらくすると停止状態に入ってしまう。NAS Navigator2で探しても、本体は出てこない。

この「赤7回点滅」は、前回までのこのシリーズで、まさに故障の発端として記録した、あの症状そのものだ。当時公開した、起動から7回点滅を経て停止に至るまでのLEDの動画を覚えている読者もいるかもしれない。新品のHDDに換えれば、少なくともこの症状からは抜け出せる──そう期待していたのに、まったく同じ点滅が、また目の前で繰り返されている。

しかも、もう一つ気になることがあった。新品のHDDが、回転していない。 耳を近づけても、手で触れても、スピンアップの気配がない。NASがHDDに電源を回す前の段階で、すでに止まってしまっているように見えた。

ここで、ふと思い出したことがある。最初に故障したときのことだ。あのときも、LANケーブルを抜いた状態で電源を入れて、同じ「7回点滅→停止」をたどっていた。つまり、ネットワークに繋がっているかどうかは関係なく、本体は同じところで力尽きていたのだ。

条件を変えて切り分ける ── 犯人はHDDではない

ここまでで、手元には三つの事実が揃った。

ひとつ、旧HDD(壊れたとされる個体)でも7回点滅で止まる。ふたつ、新品HDD(PC側での確認はしていないが、買ったばかりの未使用品)に換えても、まったく同じ7回点滅で止まる。みっつ、LANを抜いても症状は変わらない。

もし故障の原因がHDDにあるなら、新品に換えた時点で症状は変わるはずだ。少なくとも、HDDがスピンアップするなり、エラーの種類が動くなり、何かしらの変化があっていい。そもそも、もしHDDだけの問題なら、本来の復旧フロー──赤7回点滅の状態でFunctionボタンを押すとLEDが白の高速点滅に変わり、PC側のファームウェアを取りに行く──に入れるはずだ。ところが今回は、HDDを入れ替えても症状はぴくりとも動かず、新品ドライブは回転すらせず、Functionを押してもその救出フローへ進めない。NASが、HDDに電源を供給して立ち上げるところまで到達していないように見える。

ここから導かれる結論は、ひとつしかない。

壊れているのは、HDDではない。NAS本体の側だ。 おそらくは、HDDに電源を回し、起動シーケンスを進める制御基板まわり。HDDを何に差し替えても同じ場所で止まり、ファーム流し込みの入口にすら立てないのだから、HDDは「容疑者」から外していい。

ちなみに、メーカーの公式案内では、LS210Dの赤7回点滅は「内蔵HDDの故障の可能性」と説明されている。実際、ネット上でも「7回点滅=HDD故障」として扱われることが多い。だが今回のように、新品HDDでも・LANを抜いても症状が動かない場合は、案内のとおりHDDを交換しても直らない。点滅回数はあくまで入口の手がかりであって、最終的な切り分けは「条件を変えて症状が動くかどうか」で確かめるしかない──というのが、今回の実地での教訓だ。本体側の電源・基板まわりの故障でも、同じ点滅パターンが出ることはある。

発想を切り替える ── 直すのはやめる。生きているなら、活用する

本体が壊れているとなると、選択肢は限られる。基板の修理は、専用環境と専門技術を要する世界で、個人で手を出せるものではないし、費用も本体価格をはるかに上回る。同じLS210Dを買い直すという手もあるが、そもそもこのNASは前回書いたとおりNAS全体で多重化してあり、ここに「どうしても取り戻したいデータ」が残っているわけではない。

だから、NAS本体の復活は、ここで潔く諦める。

しかし──である。今回の切り分けで、もう一つ確かになったことがある。HDDは、おそらく生きている。 壊れたのは本体側で、HDDはNASに電源すら回してもらえなかった。少なくとも今回新たに装着した新品ドライブは、一度も酷使されていない。そして旧ドライブにしても、「本当にHDDが壊れていたのか」は、まだ確かめられていない。本体が先に逝ってしまったので、HDDの生死は未確認のままなのだ。

ここで、このシリーズが一貫して掲げてきた「長寿命」という考え方を思い出したい。長寿命とは、すり減るものを無駄にすり減らさず、必要な使い方に徹しさせること。NASという「箱」は寿命を迎えたが、その中で眠っていたHDDという「資源」まで一緒に捨ててしまうのは、この考え方に反する。箱は死んでも、生きているドライブは活用する。 これが、今回たどり着いた方針だ。

では、どうやってHDDを繋ぐか ── 3.5インチという壁

方針は決まった。NASから取り出した3.5インチHDDを、Linux機(hsBox)に繋いで中身を確認し、生きているなら活用先を考える。

ところが、ここで物理的な壁にぶつかった。母艦に使おうとしたhsBox(HP EliteDesk 800ベースのUbuntu機)の蓋を開けてみると、内蔵できるのは2.5インチドライブだけで、3.5インチHDDを収める場所がなかったのだ。小型・省スペースの筐体ゆえの制約で、これはどうにもならない。NASのHDDは3.5インチ。手元のLinux機には、それを内蔵で挿す余地がない。

3.5インチHDDをLinux機に繋ぐには、いくつか道がある。USB変換のHDDスタンドを使って外付けにする、3.5インチベイのある別の小型PCを用意する、あるいは──ふと頭をよぎったのは、昔懐かしい玄箱だった。が、手元のものはおそらく初代の古い世代で、いまのUbuntu機とは系譜が違う。母艦として担ぎ出すには、さすがに古すぎる。懐かしさはあっても、今回の現実的な選択肢からは外れる。

結局、最初の「USBで外付けにする」が、いちばん手早く確実だという結論になった。

次の一手 ── クローンスタンドを発注した

そこで、3.5インチHDDをUSBで繋ぐための道具を一つ発注した。玄人志向の KURO-DACHI/CLONE/CRU3 というクローンスタンドだ。

このスタンドは、3.5インチ・2.5インチのSATA HDD/SSDを2台まで挿せて、PCなしのボタン操作でドライブをまるごとクローンできる。各スロット最大16TBに対応し、接続はUSB3.2 Gen1(理論値5Gbps、いわゆるUSB3.0相当)。通常時は2台分の外付けドライブとしても使える。「3.5インチをどう繋ぐか」という今回の懸案を、そっくり解決してくれる一台だ。クローン機能まで備えているので、生きていることが確認できれば、その先のバックアップや移行にもそのまま使える。価格も3千円台と手頃で、直販でも手に入る(メーカー製品ページ)。

ただし、過信は禁物だ。製品のレビューを見ると、クローン元のHDDがS.M.A.R.Tエラーを抱えていると、クローン開始時にエラーで止まってしまう場合があるという。だから今回の最初の目的は、いきなりクローンを走らせることではなく、まずはUSB外付けとして繋いで、中身がマウントできるか=HDDが生きているかを確かめることに置く。生死がはっきりしてから、クローンするか、フォーマットして再利用するかを決める。順番を間違えないようにしたい。

次回へ ── 生きたHDDを、どう第二の人生に送り出すか

というわけで、今回の記録はここまで。NAS本体の復活は叶わなかったが、そのおかげで「壊れたのは本体、HDDは生きている」という切り分けにたどり着けた。これは、十分に意味のある一歩だったと思う。

次回は、発注したKURO-DACHI/CLONE/CRU3が届き次第、取り出したHDDを実際に繋いでみる。まずは生死の確認から。NASのHDDはLinuxのファイルシステムでフォーマットされているので、Windowsでは中身が見えない可能性が高い。そこで活きてくるのが、Linux機であるhsBoxだ。スタンド経由でhsBoxにHDDを繋ぎ、外部からデータを読み出せるかを試してみる。生きていることが確認できたら、その先の活用──通常の外付けHDDとして転用するか、別の小型Linux機に内蔵して常用するか、3.5インチベイのある機種を新調するか──を、改めて検討していきたい。

NASという箱は寿命を迎えた。けれど、その中で生きていたドライブには、まだ続きがある。「死んだNASから救い出したHDDを、無駄にすり減らさず、次の役割に就かせる」──その実作業の記録は、次回に。

関連記事

参考(外部リンク)

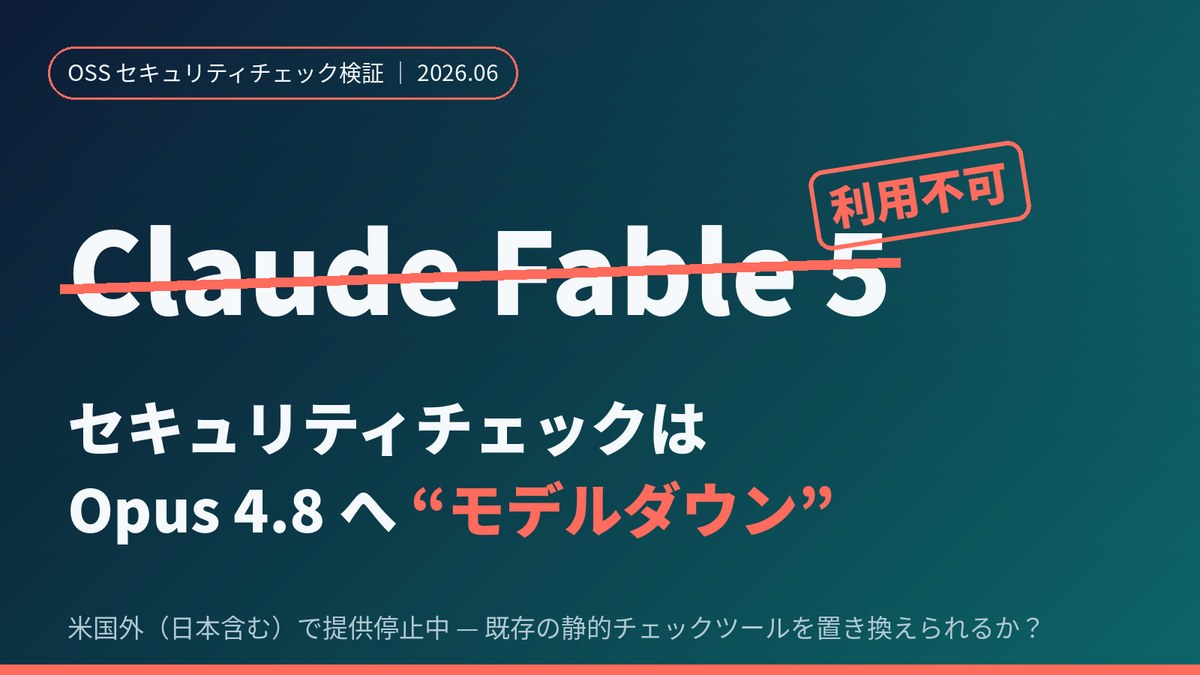
Claude Sonnet 4.6 と Opus 4.7 でフル実装した OSS コードを、今話題の Claude Fable5 でセキュリティチェックさせてみた

リリースされたばかりの最上位モデル「Claude Fable 5」を使って、AIでほぼフル実装した自前の OSS コードのセキュリティチェックをやってみた。結論から言うと——セキュリティチェックのリクエストは Fable 5 では処理されず、自動的に Opus 4.8 に“モデルダウン”されて返ってきた。本記事では、その一部始終と、最終的に Opus 4.8 が出したチェック結果の要約を、公開できる範囲で一般化して共有する。 Fable5

リリースされたばかりの最上位モデル「Claude Fable 5」を使って、AIでほぼフル実装した自前の OSS コードのセキュリティチェックをやってみた。結論から言うと——セキュリティチェックのリクエストは Fable 5 では処理されず、自動的に Opus 4.8 に“モデルダウン”されて返ってきた。本記事では、その一部始終と、最終的に Opus 4.8 が出したチェック結果の要約を、公開できる範囲で一般化して共有する。


背景:Sonnet 4.6 + Opus 4.7 でフル実装したコード

今回のチェック対象は、Claude Sonnet 4.6 と Claude Opus 4.7 を使ってほぼフルに実装した OSS のコードベース。プラグイン(拡張モジュール)を配布・インストールできるタイプの Web アプリ構成で、規模感は後述の通り。

「AI でフル実装したコードは、別の上位モデルにセキュリティ監査させたらどう評価されるのか」——これを確かめたかった、というのが今回の動機だ。


日本から Fable 5 に「セキュリティチェック」を依頼してみた

Fable 5 がアナウンスされたのは米国時間 2026 年 6 月 9 日。ただし提供は国・地域や対象ユーザーによって扱いが分かれており、日本から実際に利用できるようになったのは、このアナウンスより後のことだった。本記事の検証は、日本から利用できた期間にあたる 2026 年 6 月 11 日ごろに行っている。

手順はシンプルで、対象コードを読み込ませ、「脆弱性の有無と状況を報告してほしい」と依頼しただけだ。

ところが返ってきた挙動は予想外だった。

  • 応答に「理由」へのリンクが表示された
  • そして肝心のリクエストは Fable 5 ではなく Opus 4.8 にモデルダウンされて処理された

なぜダウンされたのか

最初は理由がよく分からなかったが、これは仕様だった。

Fable 5 には、サイバーセキュリティや生物・化学といった高リスク領域、さらにモデルの“蒸留”を検知するセーフガードが組み込まれており、該当すると判定された場合は Fable 5 ではなく Opus 4.8 が代わりに応答する設計になっている。今回は「セキュリティチェック」という依頼自体がサイバーセキュリティ関連と判定され、自動的に Opus 4.8 へ引き継がれた、というわけだ。

公式も「安全で通常のコンテンツでもフラグが立つことがある」「現在、精度の改善に取り組んでいる」と注記している。つまり、現状では “セキュリティチェックは Fable 5 の担当外” と捉えるのが実態に近い。

現状の注記(2026/06/13 時点):Anthropic は米国政府の輸出管理指令を受け、6 月 12 日(米国時間)に Fable 5 / Mythos 5 への全ユーザーのアクセスを停止した。この指令は外国籍ユーザー(米国の内外を問わない)を対象としており、日本のユーザーは現在 Fable 5 を利用できない状態にある(Anthropic は復旧に取り組むとしている)。検証を試みる場合は、最新の提供状況を必ず確認してほしい。(参考報道:ITmedia NEWS/Impress Watch)


開発自体は Opus 4.8 → Fable 5 に切り替えて継続

セキュリティ系の依頼はダウンされる一方で、通常の OSS 開発作業は Fable 5 で問題なく進められた。そこで、これまで Opus 4.8 で進めていた開発を Fable 5 に切り替えて作業を継続した。

その結果と、切り替えにあたって出てきた課題は、別記事に詳しくまとめている。


Opus 4.8 によるセキュリティチェック結果(要約・一般化)

ここからは、結局 Opus 4.8 が実施したセキュリティチェックの結果を、公開できる範囲で一般化して共有する。具体的な内部名・攻撃手順には踏み込まず、指摘の「分類」と「深刻度」のレベルで整理した。

対象コードの規模

項目規模
ファイル数約 30 ファイル
コード総量約 210 KB
実装言語Python 中心(約 4,000 行)
レビュー方式静的レビュー(ソースコード精読)

深刻度別の指摘件数

深刻度件数
🔴 Critical0
🟠 High1
🟡 Medium6
🟢 Low6
ℹ️ Info4
合計17

無条件のリモートコード実行のような致命的な欠陥は検出されず、全体としては 「セキュリティを意識した堅実な実装」 という評価だった。ただし多層防御(defense in depth)の観点では、計 17 件の改善余地が挙がった。

主な指摘(カテゴリ別・一般化)

分類深刻度概要(一般化)
認証・認可の外部依存🟠 High本体側に独自の認証機構がなく、強い副作用を持つ API(インストール/アップロード/設定保存など)の保護を、上位の Web サーバ側の認証に全面的に依存している
CSRF 対策・トークン検証🟡 Medium状態を変更する API に Origin / Referer チェックやトークン検証がない。また URL パラメータ由来の値が検証されないまま画面に反映され得る
外部リソース取得(SSRF)🟡 Mediumインストール処理が、指定された URL へ制限なくアクセスし得る
アーカイブ展開時のパス検証🟡 Medium配布パッケージを展開する前のパス検証が不十分(いわゆる Zip Slip)
画面描画時のエスケープ(XSS)🟡 Medium外部由来の文字列を、エスケープせずに DOM へ挿入し得る箇所がある
その他🟢 Low / ℹ️ Infoログ出力・エラー処理・依存関係などに関する軽微な改善提案

評価できた点

監査では、以下のような「すでに適切に対策できている点」も明確に挙げられた。

  • 待ち受けをループバックアドレスに限定している
  • プラグイン名を許可リスト(allowlist)方式で検証している
  • 配布インデックスのスキーマを検証している
  • パス・トラバーサル対策が入っている
  • セキュリティ関連ヘッダを一律で付与している
  • 設定ファイルをアトミックに書き込んでいる

対応方針

報告書には、優先度(P1〜P3)付きの改善ロードマップも併記した。要点は次の 3 つに集約される。

  1. 本体側にも、最低限の認証・CSRF 対策を持たせる
  2. 外部リソースの取得とアーカイブ展開に、検証処理を入れる
  3. 画面描画は一律でエスケープする

なお、実効的なリスクは 上位の Web サーバ側の認証構成(本コードの外側) に大きく左右される。そのため、最終的な安全性の評価は、その構成とあわせて確認する必要がある——この点は報告書にも免責として明記している。


補足:今回のチェックは「静的レビュー」である点に注意

ここは結果を読むうえで重要なので補足しておきたい。

今回 Opus 4.8 が行ったのは、ソースコードを読んで解析する 静的レビューだ。報告書自身も方式を「静的レビュー(ソースコード精読)」と明記している。実際にアプリを起動して通信を流す、いわゆる 動的テスト(実行時の検証)は行っていない。

これは Anthropic 自身が提供する専用機能の位置づけとも一致する。同社の「Claude Code Security」も、コードを読んで文脈やデータフローを追う 静的解析として位置づけられており、アプリを実行して挙動を確かめる ランタイム(動的)ツールではないとされている。手法としては、従来のルールベース(パターンマッチ)型 SAST とは異なり、文脈やロジックを追う「エージェント的なコード推論」に近い。逆に、実行時にしか現れない種類の不具合は、そもそも対象外になる。

そのうえで、結果を読むときに押さえておきたい点が 2 つある。

1. 「過剰検知」が起きやすい

ルールベースの従来型ツールと違い、AI によるレビューは実行のたびに解析内容が変わる 確率的(ストキャスティック)なものだ。文脈を踏まえて深い指摘ができる反面、毎回同じ結果になるとは限らず、影響の小さい指摘や誤検知(false positive)が混ざりやすい。Anthropic の専用ツールでも、ノイズを減らすための誤検知フィルタや、最終判断を人に委ねる運用(human-in-the-loop)が前提になっている。今回のような「チャットにコードを貼って読ませる」簡易な使い方では、そうしたフィルタは働かないため、各指摘は「確定した脆弱性」ではなく 要確認の候補として、1 件ずつ人手でトリアージする必要がある。

2. 見ているのは「渡したコードだけ」

今回のレビューは、読み込ませたソースの範囲しか見ていない。サーバ(Apache)側の設定や、実際の運用環境までは把握していない。報告書が「実効リスクは上位の Web サーバ側の認証構成(本コードの外側)に左右される」と免責しているのは、まさにこのためだ。一般的なコードチェックツールが想定する「システム全体を俯瞰した解析」とは前提が異なる点に注意したい。

要するに——本当に影響があるかどうかは、この静的レビュー結果だけでは確定できない。各指摘について、実際の構成・データフローを踏まえた人手の確認と、必要に応じた動的テストを重ねて初めて、実効リスクが判断できる。AI の静的レビューは「あたりを付ける」には非常に有用だが、最終確定には別の検証が要る、というのが実情だ。


やってみての所感

正直に言えば、手応えよりも 「Fable 5 で確認できなかった」失望のほうが大きい。最上位モデルでセキュリティ監査を、と期待したのに、現状はセーフガードで自動的に Opus 4.8 へ引き継がれてしまう。セキュリティチェックは Fable 5 の担当外、と割り切るしかなかった。

代わりに動いた Opus 4.8 の静的レビューについても、評価は手放しではない。

  • 既存の静的チェックツールとの差は、正直よく分からない。 文脈を読む深さに見どころはあるが、「専用ツールを置き換えるほどの決定的な違い」を今回の範囲で実感できたわけではない。
  • 専用の静的チェックツールを購入しなくても、ある程度のチェックができるのは確かにアリだ。ただし AI ゆえに「漏れなく・均一に」チェックできる保証がないのが微妙なところ。実行のたびに結果が揺れる確率的な仕組みである以上、ここは本質的な弱点になる。
  • したがって、既存の静的チェックツールをやめて AI チェックに全面的に切り替えるのは、「漏れなく検出できるか」という一点で NG だと考える。網羅性・再現性が求められる場面では、まだ任せきれない。

一方で、可能性も感じた。もし AI が、ソース単体だけでなくシステム全体の構成まで含めて判定してくれるようになれば、既存の静的チェックツールと組み合わせて効率的な作業ができるかもしれない。そう考えると、AI が静的チェックツールを置き換えるのではなく、静的チェックツール側に AI が組み込まれていく未来のほうが、現実的で筋が良さそうだ。


参考リンク(外部)