Claude 詐欺メールを解剖する|認証が通っても偽物だった

ある日、「Claude Max トライアルの準備ができました」という件名のメールが届く。これは典型的なClaude 詐欺メールです。差出人の欄には「Claude」と表示され、本文には自分のメールアドレス、文末には Anthropic 社の住所まで載っている。だから本物の案内に見えてしまう。本記事では、この Claude 詐欺メールを実物のヘッダごと解剖し、見破り方とスパム判定の強化策まで整理します。

厄介なのは、この Claude 詐欺メールが SPF・DKIM・DMARC というメール認証をすべて「合格(pass)」して受信箱に届いていた点です。当サイトでは過去に何度も、認証技術によるなりすまし対策を取り上げてきました。今回はその強化してきたはずの判定をすり抜けた一通が題材です。なぜ通り抜けられたのか、何を見れば見破れるのか、最後にスパムとして弾く方法までを、一般の方とエンジニアの双方に向けて述べます。

届いた Claude 詐欺メールの中身

まず実物を見ます。本文は英語でした。受信者のメールアドレスは伏せています。

claude • max

Your Claude Max trial is ready
Hello,

You have been granted 1-month trial access to Claude Max.
(あなたに Claude Max の1か月トライアルアクセスが付与されました)

ACCOUNT
xxxxx@****(受信者本人のアドレス)

Get Started → https://claudetrial.com/?session=3355555667

Note: This invitation is unique to xxxxx@**** and will expire in 24 hours.
(この招待はあなた専用で、24時間で失効します)

Anthropic PBC, 530 Divisadero St, San Francisco, CA 94117, USA

一見、ただの「無料トライアル案内」です。自分のアドレス宛てに「あなた専用」と書かれている。Anthropic の正しい住所まで載っている。普段 Claude を使う人ほど、正規のお知らせと受け取りやすい。そこを突くのが、この Claude 詐欺メールの狙いです。

本文だけで分かる Claude 詐欺メールの兆候

落ち着いて読めば、本文だけでも危険信号が見つかります。

1. リンク先が Anthropic のものではない。「Get Started」の先は https://claudetrial.com/?session=335555667 です。Claude の正規サービスは claude.ai や anthropic.com で提供されます。claudetrial.com は無関係の別ドメインです。末尾の ?session=… は、クリックした人を追跡する仕掛けの可能性があります。このURLは絶対に開かないでください。

2. 「24時間で失効」と急かす。「あなた専用」「24時間以内」は、考える時間を与えず即クリックさせる古典的な手口です。正規の案内がここまで急かすことはまずありません。

3. 身に覚えのない「手続き完了」通知。申し込んでいないのに「ご要望に応じてお送りしました」とある。これもフィッシングの常套句です。

同種のキャンペーンは国内外で確認されています。セキュリティ企業 MailGuard は、Anthropic を騙る支払い失敗型のフィッシングを報告。日本でも2026年3月、「Claude 日本語無料版」を名乗る偽サイトがITmedia に報じられました。偽の Claude サイトがマルウェアを仕込んだ事例もMalwarebytes が解析しています。Claude の利用者が増えるほど、その名前を悪用する攻撃も増えています。

ヘッダで見抜く Claude 詐欺メールの正体

メールのヘッダ(送信元や経路の記録)を見ると、正体がさらにはっきりします。重要な部分を抜き出します。

From: Claude <accounts1@dallasmbs.com>
Reply-To: accounts1@dallasmbs.com
Return-Path: <accounts1@dallasmbs.com>

Received: from static195-40.de.dm.aliyun.com (47.245.195.40)
Received: from dallasmbs.com by smtp.aliyun-inc.com
Feedback-ID: default:accounts1@dallasmbs.com:alibabak_SmtpBatch

X-Amavis-Alert: BAD HEADER SECTION, Duplicate header field: "MIME-Version"

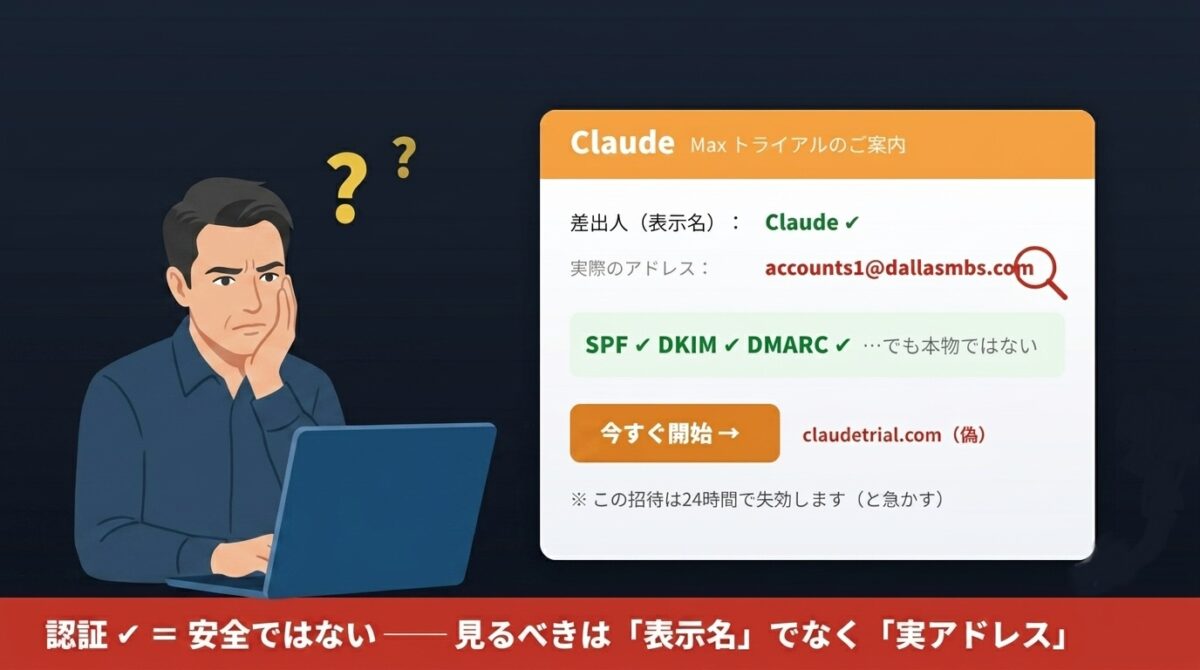
表示名は「Claude」でも、実際の差出人は accounts1@dallasmbs.com。これが核心です。メールの「表示名」は、送る側が自由に決められます。「Claude」とも「Anthropic」とも、誰でも名乗れる。一方で実アドレスは dallasmbs.com。Anthropic とは縁もゆかりもないドメインです。返信先も戻り先も、すべて同じ無関係ドメインでした。

配信経路は中国系クラウドの一斉配信基盤です。経路をたどると Alibaba Cloud の aliyun.com 系サーバを経由しています。Feedback-ID の alibabak_SmtpBatch は、バルク配信サービスの痕跡です。世界規模の Anthropic が、正規案内をこの種の基盤から送るとは考えにくい。

ヘッダ自体も壊れています。受信側が BAD HEADER SECTION の警告を出しました。「MIME-Version」が二重に書かれているという意味です。雑な送信ツールの典型的な痕跡で、正規の大規模配信ではまず起きません。送信時刻のタイムゾーンも経路ごとにバラバラでした。

なぜ認証は「全部 pass」したのか

ここが今回いちばんの要点です。この Claude 詐欺メールのヘッダには、こう記録されていました。

dkim=pass  header.d=dallasmbs.com
spf=pass   smtp.mailfrom=accounts1@dallasmbs.com
dmarc=pass (policy=none) header.from=dallasmbs.com

SPF・DKIM・DMARC が、いずれも pass。当サイトが「なりすまし対策」として紹介してきた三つの認証が、すべて通っています。「認証が通った=本物では?」と感じた方こそ、ここが落とし穴です。

カラクリはこうです。これらの認証が見るのは、「dallasmbs.com が dallasmbs.com として正しく送ったか」だけ。攻撃者は自分で取得した dallasmbs.com から送っています。だから検査は当然パスします。

つまりこの Claude 詐欺メールは、Anthropic を認証レベルで詐称してはいません。ドメインを偽装したのではなく、認証が一切見ない場所——「表示名」に「Claude」と書いただけです。

当サイトのDMARC 解説やなりすまし対策で強化したのは、主に「正規ドメインを騙るドメイン詐称の検知」でした。今回はドメインを詐称していないため、その網にかからず素通りした。これが「すり抜け」の正体です。SpamAssassin のスコアも score=1.6 required=30.0 と低く、ほぼ素通りでした。

逆のケースも知ると理解が深まります。あるセキュリティ製品の開発者は、本物の Anthropic メールを誤って詐欺判定した経験を公開しました。本文の印象だけでは本物すら怪しく見え、偽物が本物らしく見える。最終的に本物と確証できたのは、認証結果が header.from=claude.com で揃っていたから。「どのドメインとして認証が通ったか」を見たからです。

見るべきは「表示名」ではなく「実アドレス」

ここまでをひとことでまとめます。

認証が「合格」でも、それは「そのドメインとして正しく送られた」ことの証明にすぎない。「あなたが思う相手(Anthropic)から来た」ことの証明ではない。

だから見るべきは、派手な表示名(”Claude”)ではありません。実際の差出人アドレス(@dallasmbs.com)です。表示名が「Claude」でも、実アドレスのドメインが claude.ai や anthropic.com でなければ、正規の案内ではないと判断できます。

そして、ここが最も強調したい警告です。メーラーの中には、この実アドレスを隠し、表示名しか見せないものがあります。スマホのメールアプリでは特に、差出人欄に「Claude」とだけ出て、タップして初めて accounts1@dallasmbs.com が現れることがあります。設定によっては最後まで見えないものすらある。

確認すべき情報を隠すメーラーは、それ自体が危険です。普段使う環境で「実際の差出人アドレスが常に確認できるか」を、一度点検しておくことをおすすめします。なお、ツールや連携の挙動を過信しない姿勢は、当サイトの技術検証記事でも繰り返し触れてきた通りです。

Claude 詐欺メールをスパム判定するには(一般の方へ)

今回のメールは、メーラーもサーバも迷惑メールと判定できませんでした。認証が揃い、スコアが低かったためです。まずは技術設定なしでできる、一般の方向けの習慣から。

第一に、表示名でなく実際の差出人アドレスを必ず確認します。@より後ろのドメインが正規のものと一致するかを見るだけです。第二に、メール内のリンクは踏みません。必要ならブックマークや検索から公式サイトへ自分で行きます。

第三に、「24時間以内」「今すぐ」と急かすメールほど、いったん止まります。急かしは考えさせないための演出です。判断に迷えば AI に画像ごと相談するのも手ですが、AI も誤ります。最後はドメインの一致で確かめてください。

Claude 詐欺メールを弾くルール設計(エンジニアへ)

この Claude 詐欺メールが素通りした根本は、「ドメイン認証は正しいが、ブランド名を表示名で騙っている」点にあります。対策の方向は DMARC の先——認証では捕まらない『ブランド詐称』の検知です。

SpamAssassin なら、「From の表示名に著名ブランド名を含むのに、送信ドメインが正規でない」場合に加点するメタルールが書けます。考え方を示す擬似ルールが以下です。実運用では正規表現とドメインリストの精査が要ります。

# 表示名に "Claude"/"Anthropic" を含む
header  L_BRAND_NAME  From:name =~ /\b(claude|anthropic)\b/i

# 送信ドメインが正規ドメインでない(例:claude.ai / anthropic.com 以外)
header  L_NOT_OFFICIAL  From:addr !~ /\@(claude\.ai|anthropic\.com)$/i

# 両方に当てはまれば「ブランド詐称の疑い」として加点
meta    L_BRAND_SPOOF  (L_BRAND_NAME && L_NOT_OFFICIAL)
score   L_BRAND_SPOOF  4.0
describe L_BRAND_SPOOF  Display name claims a known brand but sender domain does not match

あわせて、実務では次の重み付けが効きます。新規・低評価ドメインへの加点です。dallasmbs.com や claudetrial.com のような、登録が新しく評価の低いドメインに点を上乗せします。今回ヒットした URIBL 系のフィードを増やすのも有効です。

次に一斉配信インフラのヒューリスティックです。海外バルク基盤+日本宛て+英語本文+著名ブランド名という組合せに加点します。今回 X_NONJAPANESE_SUBJECT が既にヒットしているので、足がかりにできます。さらに BAD HEADER SECTION などのヘッダ構文異常もスコアに織り込みます。

最後に、組織としては正規連絡元ドメインのホワイトリスト化が最も確実です。「Anthropic からの案内は claude.ai / anthropic.com 由来のみ」と運用ルールを明文化します。これらは SPF/DKIM/DMARC を置き換えるものではなく、その「外側」を補う層です。認証は「ドメインの正しさ」は保証しますが、「ブランドの正しさ」は見ていないからです。

まとめ:Claude 詐欺メールの教訓

今回の Claude 詐欺メールは、SPF・DKIM・DMARC をすべて pass しながら、受信者に「本物が来た」と誤認させる、よくできた一通でした。すり抜けの理由は、ドメイン偽装ではなく、認証が見ない「表示名」にブランド名を書いただけ。だから受信者は表示名でなく実アドレスのドメインを見るべきで、それを隠すメーラーは危険です。

弾く側は、認証の外側で「表示名とドメインの乖離」を検知する層を足すことが次の一手です。身に覚えのない「無料トライアル」「支払い失敗」「アカウント停止」が届いたら、まず止まって差出人の実アドレスを確かめる。それだけで、多くの被害は防げます。

関連記事

※本記事で扱ったメール・ドメイン・URL は、注意喚起のための実例です。記載のリンク先(claudetrial.com 等)には絶対にアクセスしないでください。
HDD価格高騰の正体は、AI需要!? ── 4か月待った交換ドライブ到着記

前回、故障したNAS(LS210D)の交換用HDDとして、SeagateのIronWolf「ST4000VN006」(4TB・CMR・NAS向け)を選んだところまで書いた。記事の最後はこう締めくくっていた──「次回は、購入したHDDを使ってNAS復活に挑戦です」と。

その「次回」が、ようやく書ける。

ただし、NAS本体の復活作業はもう一度先送りさせてほしい。理由は単純で、発注したHDDが届くまでに、4か月かかったからだ。 発注は2026年2月23日。到着は6月23日。きっかり4か月、入荷待ちが続いた。今回はまず、この「待たされた4か月」そのものを記録に残しておきたい。HDDという、ふだんは「ポチればすぐ届くもの」が、なぜこれほど待たされたのか。そして、2月に値段を確定して発注しておいた判断は、正解だったのか。


届いたもの ── 伝票とドライブ

まず、到着した実物から。

2026年2月に発注し6月に到着したST4000VN006の到着時の様子
2月発注・6月到着。4か月待った交換用ドライブがようやく届いた

伝票の日付がそのまま記録になっている。発注 2026年2月23日 → 到着 2026年6月23日。 購入金額は21,980円(税込)。発注時点でこの価格は確定していた。

購入したSeagate IronWolf ST4000VN006 4TB NAS用HDDの本体
届いたST4000VN006。ラベルの製造日は「06JUN2026」

そして届いたST4000VN006本体。静電防止袋越しの一枚だが、ラベルの「Date(製造日)」を見て、思わず二度見した。表記は「06JUN2026」。製造日は2026年6月6日。 発注したのが2月、製造されたのが6月初旬、手元に届いたのが6月23日。つまりこのドライブは、私が注文してから3か月以上あとに作られた個体ということになる。倉庫で在庫が眠っていたのを待っていたのではなく、どうやら「作られるのを待っていた」可能性が高い。この点は後でもう一度触れる。

ちなみに、今回壊れて交換対象になった旧ドライブ(ST4000DM005)のラベルを見ると、製造日は「27APR2022」。2022年4月製だ。約4年動いて力尽きた個体を、2026年6月製の新品で置き換えることになる。

(余談だが、製造日「06JUN2026」=2026年6月6日というのは、少し気になる並びでもある。西洋では「666」が新約聖書『ヨハネの黙示録』に登場する「獣の数字」とされ、悪魔・反キリストを象徴する不吉な数として避けられてきた。6が三つ並ぶ6月6日は「恐怖の日」とも呼ばれ、映画『オーメン』などでも知られる。日本ではあまり馴染みのない忌み数だが、もしこのドライブを作ったタイの工場にキリスト教徒の従業員がいたら、出荷日のラベルを見て少し身構えたかもしれない──というのは、さすがに考えすぎだろう。データの保全に、語呂も縁起も関係ない。)


価格は、どう動いていたのか ── 価格.comの実データ

「待っている間に値段がどうなったか」を、体感ではなく実データで見ておきたい。価格.comのST4000VN006 価格推移グラフは、期間を1年・2年に切り替えると長期の推移も追える。これを踏まえて数字を並べると、いくつもの発見があった。

まず、長いスパンで見たときのベースの底上げ。

時点価格.com価格
2022年8月(初値)14,979円
2026年2月23日(発注日・平均)25,253円
私の発注価格(2/23・確定)21,980円

このドライブの登録初値は14,979円。それが私の発注した2026年2月23日には平均25,253円まで上がっていた。2年半ほどで、ベースの価格が1.7倍近くになっている。 そして注目したいのは、私が確保した21,980円が、その2/23時点の平均25,253円よりも3,000円以上安かったこと。安い店を選んで発注した判断は、この時点ですでに効いていた。

次に、到着前後(5月下旬〜6月)の最安値の動き。

時期価格.com最安値(税込)
5月26日37,308円
5月29日38,090円
5月30日27,980円(前日から約1万円下落)
6月上旬29,980円前後
6月13日22,950円(一時的な下げ)
6月14日31,547円(翌日に約8,600円戻す)
6月18日32,980円
6月19日25,500円(約7,500円下落)
6月22〜24日(到着前後)24,980円

ここから二つのことが読み取れる。

ひとつは、私が2月に確保した21,980円という価格は、到着時の相場と比べても明確に安かったということ。到着した6月の最安値はおおむね2.5万〜3.3万円台で、5月下旬には3.8万円台に届いていた。発注時に値段を固定できたぶん、待っている間の値上がりを丸ごと回避できた格好だ。仮にいま同じものを買い直すなら、3,000〜1万6,000円ほど余計に払うことになる。

もうひとつは、価格が一日で7,000〜10,000円も上下していること。6月13日に22,950円まで下がったかと思えば、翌14日には31,547円へ跳ね上がる。これは需要が日替わりで動いているというより、「安値を出す店の在庫が出たり消えたりするたびに、最安ショップが入れ替わっている」動きに見える。薄い在庫を、複数の店が奪い合っている──そんな相場だ。

※価格は価格.comの掲載値(初値・平均・最安値)を参照。価格・在庫は常に変動するため、購入検討時は必ず最新の情報を確認してほしい。


なぜ高い ── 円安は「地ならし」、引き金は別にあった

HDDが高い、と聞くとまず「円安のせいだろう」と考えたくなる。輸入品である以上、円安が効いているのは間違いない。だが、価格.comの価格推移グラフを長期で眺めると、話はそう単純ではないことがわかる。価格推移グラフのページで表示期間を「1年」や「2年」に切り替えると、ここで述べる動きが自分の目で確認できるので、ぜひ実際のグラフと見比べてほしい。

長期グラフで決定的なのは、価格が動き出したタイミングだ。2025年7月から11月にかけて、最安値は17,000円前後でほぼ横ばい──むしろ秋口にはわずかに下げてさえいる。ところが2025年12月を境に、価格は急角度で上がり始める。 2026年に入って上昇は加速し、5月には平均45,000円超・最安値37,000円台のピークをつけ、6月にやや反落して現在に至る。

ここで為替を重ねてみる。円安はこの1年で急に始まったものではない。ドル円が150円を超える水準は2022年から続く長期トレンドで、2026年も年初に159円台をつけたあと、おおむね140〜160円のレンジで推移している。つまり、円安は2025年前半からずっと「効いていた」はずなのに、HDD価格が動き出したのは2025年末からだ。 もし円安が主因なら、価格は2025年前半から上がっていなければおかしい。だが実際には、横ばいの期間が半年以上続いたあと、為替とは無関係なタイミングで急騰が始まっている。

物価と為替は、しばしばずれて現れる。為替は輸入コストの「土台」を押し上げる地ならしではあっても、この急騰の引き金を引いたのは別の要因だ──そう考えるのが自然だろう。

ではその引き金は何か。報道で繰り返し指摘されているのは、生成AI向けのデータセンター需要である。HDDメーカーが利益率の高い大容量・データセンター向けの生産を優先し、結果として4TBクラスのような普及帯の供給が絞られた。Western Digitalは2026年生産分がほぼ完売で、上位クラウド事業者と2027〜2028年まで長期契約を結んでいると報じられている。日本経済新聞も、2026年4〜6月期のHDD大口取引価格が前四半期比で約1割上昇した背景として、中国のPC向け需要とデータセンター優先による品薄を挙げており、為替には触れていない。時期で見ても、AIデータセンター投資が過熱したのはまさに2025年後半から。価格が動き出した時期と、きれいに重なる。

ここで、冒頭の「製造日6月6日」が効いてくる。生産枠がデータセンター向けで埋まっている中では、一般向けの普及帯ドライブは「在庫から出てくる」のではなく「順番待ちで作られる」状況になりうる。私の個体が注文の3か月以上あとに製造されていたのは、まさにその順番待ちの結果だったのではないか──そう考えると、4か月の「入荷待ち」の正体に説明がつく。


この高値は、いつまで続くのか ── 二つの見方

では、この相場はいつまで続くのか。ここは断言を避けたい。見方が、はっきり二つに割れているからだ。

供給側から見れば、高止まりは当面続く。 メーカーの生産枠が2027〜2028年まで長期契約で埋まり、新しい生産ラインの立ち上げには年単位の時間がかかる。だから多くの分析は「2026年中に以前の安値へ戻ることは期待しにくく、緩和は早くて2027年以降」で一致している。この見方に立てば、いま高くても待つ意味は薄い。

だが需要側を見ると、雲行きが変わりつつある。 価格急騰を支えてきたAIデータセンター需要そのものに、調整の兆しが出始めているのだ。2026年に米国で完成予定だったデータセンターの約半数が遅延・中止に追い込まれ、マイクロソフトは計画容量の一部を延期したと報じられている。地域住民の反対運動も激化し、2026年1〜3月だけで総額20兆円規模のプロジェクトが停止・延期、ニューヨーク州議会は新規大規模データセンターの建設を一時停止する法案を可決した。AIの収益化が想定より遅れ、企業間の「勝ち負け」が見え始めているという指摘もある。

もし、過剰投資の調整が本格化し、撤退する企業の発注分が宙に浮けば、データセンター向けのHDD需要は想定より早く緩む可能性がある。そうなれば、普及帯に回ってくる供給も増え、価格が落ち着く展開もあり得る。「2027年まで高止まり」は供給側の論理であって、需要側が崩れれば前提ごと変わる。 どちらに転ぶかは、正直なところ読みきれない。

確実に言えるのは、この相場は「構造的に高い」のではなく、「AI需要という一本の柱に支えられて高い」ということだ。柱が太いままなら高値は続くし、柱が細れば崩れる。HDDの値段を、為替やインフレといった大きな話だけでなく、AI産業の浮き沈みという生々しい現実と結びつけて眺めておくと、買い時の判断材料になるかもしれない。


「他店ではすぐ買えた」という事実 ── 入荷待ちは店の問題でもある

ここは正直に書いておきたい。私が4か月待っている間も、もっと高い値段を出している他店では、在庫があってすぐ買えた。 価格.comでも、2月から6月を通じて在庫表示「△」ながら複数のショップが販売を続けていた。

つまり、市場全体でST4000VN006が完全に払底していたわけではない。「すぐ届く店は高く、安い店は入荷待ち」という、ごく当たり前の構図がそこにあっただけだ。私は安い店を選び、そのぶん時間を払った。供給が絞られた相場では、低価格で出てくるのは余剰のぶんだけで、それを安値で確保しようとすれば順番を待つことになる。価格と納期は、たいてい交換条件になる。


「すぐ欲しい」か「待てる」かで、買い方は変わる

この4か月で得た教訓を一つに絞るなら、HDDの買い方は「すぐ欲しいか/待てるか」で根本的に変わる、ということだ。

今回の私のNASは、前回書いたとおり、NAS全体で多重化しており、お金を払ってまで急いで復旧すべきデータはなかった。だから「待てる」側だった。納期を犠牲にして安い店を選び、結果として高騰相場の値上がりも乱高下も回避できた。これは「待てる」人にとっての最適解だったと思う。

逆に、いま現に運用中のストレージが壊れて、バックアップの空白を一日でも早く埋めたい──そういう「すぐ欲しい」状況なら、話はまったく違う。最安値を狙って入荷待ちに賭けるより、多少高くても即納の在庫を押さえるほうが、トータルでは正しい。相場が高止まりし、しかも日替わりで乱高下する局面では、「最安のタイミングを当てにいく」こと自体がリスクになる。先に見たとおり、この先の相場は供給側・需要側のどちらに転ぶか読みきれない。だからこそ「いつか下がるはず」と当てにして運用に穴を空けるより、自分の状況が「待てる」のか「待てない」のかを先に見極めるほうが、よほど確実だ。

ひとつ補足すると、HDD選びでは「すぐ欲しい/待てる」だけでなく、SMRかCMRか、容量単価はどうか、といった軸も絡んでくる。このあたりは前回で詳しく検討したので、そちらも参照してほしい。


余談:このドライブは「どこ製」なのか

最後に、ラベルを眺めていて気になった点を一つ。製造国の表記についてだ。

今回届いた個体のラベルには「Product of Thailand」とあった。タイで組み立てられたドライブ、というわけだ。面白いことに、今回壊れた交換前のドライブ(ST4000DM005)も、同じく「Product of Thailand」だった。製造日は4年違い、型番も製品系列も違うのに、組み立て地は同じタイ。Seagateにとってタイが主力の組み立て拠点であることがうかがえる。

ただ、この「Product of Thailand」を見て「このドライブはタイ製だ」と言い切るのは、実はかなり乱暴な話だ。ラベルが示しているのは、あくまで最終的な組み立て(アッセンブリ)を行った国にすぎない。

HDDは、プラッタ(ディスク)、磁気ヘッド、スピンドルモーター、サスペンション、制御基板、ファームウェア──と、無数の精密部品の集合体だ。そして、これらの中核部品を誰が作っているかは、公開されている事実である。たとえば磁気ヘッドはTDKが専業の世界トップメーカーで、記録媒体であるプラッタはレゾナック(旧昭和電工)やガラス基板のHOYA、プラッタを回すスピンドルモーターはニデック(日本電産)やミネベアミツミ、磁気ヘッドを支えるサスペンションはニッパツ(日本発条)やTDK──というように、部品ごとに供給メーカーがはっきり分かれており、その多くは日本企業だ。 Seagateのような完成品メーカーはヘッドやメディアを内製もするが、それでも供給安定のために外部からも調達するのが普通である。

だから「○○製だから良い/悪い」という見方は、HDDに関してはほとんど意味をなさない。ラベルの「Product of Thailand」は「タイで組まれた」ことを示すだけで、中身の部品は世界中──とりわけ日本──のメーカーから集められている。組み立て地はラベルで分かっても、中身がどこの何でできているかまでは、ラベルからは読み取れない。これはこのドライブに限った話ではなく、HDDという製品そのものの素性なのだ。


次回こそ ── 届いたHDDでNAS復活へ

というわけで、交換用ドライブはようやく手元に揃った。4か月分の「待ち」も含めて、いい記録になったと思う。

次回は、いよいよこのST4000VN006を使って、故障したLS210Dの復活に挑戦する。分解したNASに新しいドライブを組み込んで、はたして無事に動き出すのか。あるいは、HDD交換だけでは済まない別の問題が待っているのか。実作業の記録は、次回に。


関連記事

参考(外部リンク)

単一システムを長く動かす ── すり減るものを、無駄にすり減らさない設計|ストレージ再考 第9話

長寿命化とは「消耗を無駄にしない・必要な使い方に徹する」こと。一台のシステムを長く動かす設計を、書き込み削減・機能分離・ログの外出し・媒体の使い切り・物理の土台まで整理した、ストレージ再考の集大成。

システムを設計するとき、私たちはつい「速さ」や「機能の多さ」に目を向けてしまう。だが、長く動き続けるシステムを作りたいのなら、本当に設計すべきは別のところにある。

本稿で扱うのは、その中でも最も基本的な舞台──たった一台のシステムを、いかに長く動かすかである。

そして、ここで言う長寿命化とは何かを、先に一文で定めておきたい。長寿命化とは、消耗するものを無駄に消耗させず、必要な使い方に徹しさせることだ。 本稿はこの一点に貫かれている。

長寿命を実現する道筋には、段階がある。まず一台のシステムそのものを長持ちさせる。それでも足りなければ、複数台でサービスを止めない継続性の設計に進み、本当の最後の手段として、システムごと作り替える。後ろの二つは今回は参考程度にとどめ、本稿は最初の一段──単一システムでの長寿命に集中したい。

第7話では、メモリやストレージはどれも万能ではなく、最後は「構成」で決まると書いた。本稿はその結論の、いわば実践編にあたる。速さでも容量でもなく、寿命という軸で、一台のシステムを眺め直してみたい。なお「速くする」話そのものは別稿で扱ったので、ここでは触れない。


「壊れないシステム」は存在しない

最初に身も蓋もない前提を置いておく。壊れないシステムは存在しない。

電子部品は経年で劣化し、ディスクは回り続ければ摩耗し、Flashは書けば書くほど寿命を削る。永遠に壊れないものを作ることはできない。

ならば、一台のシステムを長く動かすとは何か。それは「壊れないもの」を目指すことではない。冒頭で定めたとおり、消耗するものを無駄に消耗させず、必要な使い方に徹しさせること──すり減る場所を限定し、すり減りを必要最小限に抑え、持っている寿命を最後まで引き出す。これが一台を長く生かす設計の正体である。

そして消耗を最も加速させる要因の一つが、ほかでもない「書き込み」だ。まずはここから入っていこう。


システムはどこから消耗するか ── 「書く」が寿命を削る

第7話で整理した表を思い出してほしい。NAND Flashの書換上限は、おおよそ10³〜10⁵回のオーダーだった。SRAMやDRAMが実質無制限なのに対し、不揮発で安価なFlashは「何度書けるか」に明確な限界を持つ。つまりFlashは、紛れもない消耗品である。

ここで効いてくるのが、「読む」より「書く」のほうが寿命を削るという非対称性だ。データを読み出すだけなら、デバイスはほとんど摩耗しない。寿命を削るのは、ひたすら上書きされ続けるデータのほうである。

では、一台のシステムの中で「書き続けられる」データとは何か。

  • ログ(イベント、アクセス、デバッグ出力)
  • 一時ファイル・キャッシュ
  • データベースのジャーナルやインデックス更新
  • 各種の状態ファイル・カウンタ

これらは、システムが動いている限り、静かに、しかし絶え間なく消耗品を削り続ける。一台を長持ちさせる設計とは、突き詰めれば「無駄に書かない」設計から始まる。どこに何を書くかを決めずに組んだシステムは、最も書き込みの多い場所から、静かに寿命を迎える。


設計その1:ストレージを「階層」で考える

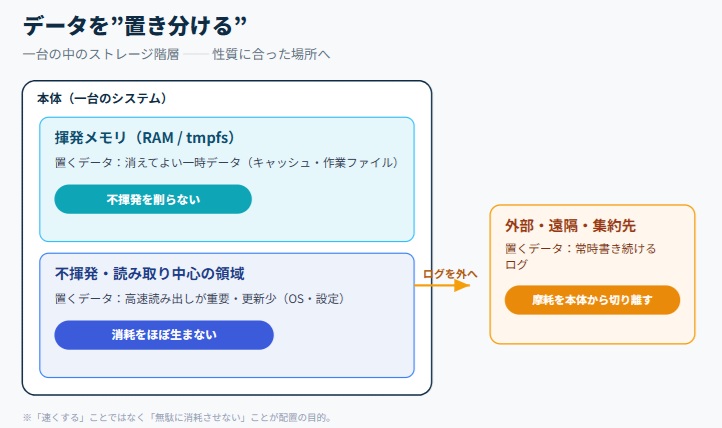
第7話の結論は「適材適所」だった。これを寿命の観点で言い直すと、データを“消えていいもの”と“残すべきもの”と“書き続けるもの”に分け、それぞれを別の場所に置く、ということになる。

データの性質(何に使うか)置き場所この置き方のメリット
消えてよい一時データ(キャッシュ、作業中ファイルなど)揮発メモリ(RAM / tmpfs)どうせ消えてよいデータなので、その書き込みで不揮発媒体をすり減らさずに済む
高速な読み出しが重要で、更新頻度が低いデータ(OS本体・プログラム・設定など)不揮発の読み取り中心の領域必要な読み出しに応えつつ、書き込みによる消耗をほとんど生まない
常時書き続けるデータ(ログなど)外部・遠隔・集約先避けられない摩耗を、本体そのものから切り離せる
データを置き分ける
データを置き分ける

ポイントは、すべてを1つの速くて便利なストレージに任せないことだ。速いデバイスは消えやすく、安いデバイスは摩耗する。それぞれの弱点を、データの性質と引き合わせて配置する。これが階層という発想であり、消耗品を「必要な使い方に徹しさせる」ための、最初の一手である。


設計その2:機能分離 ── 一台の「中で」役割を分ける

40年以上前のワンボードマイコンには、SRAMとEPROMを必要に応じて差し替えられる作りのものがあった。役割の違うデバイスが、それぞれ別のソケットに挿さっていたからこそ、片方だけを交換・増設できた。

一台のシステムを長く動かすうえでも、この発想は効く。ここで言う分離は、別の箱に分ける(それは継続性の話だ)のではなく、一台の中で、領域とプロセスと役割を分けることである。

  • OS領域・データ領域・ログ領域を、パーティションやデバイスで分けておく
  • プロセスを分離し、一部の暴走やリソース食いつぶしが、全体を巻き込まないようにする

1台・1ディスク・1プロセスに全部を載せてしまうと、どこか1点の消耗が全体を巻き込む。 役割を分けておけば、傷んだ部分だけを切り離せる。そして「必要なものだけを載せる」という抑制は、そのまま「余計な書き込みを生まない」ことにもつながる。詰め込まないこと自体が、消耗を必要な範囲に閉じ込める設計なのだ。


設計その3:ログの置き場所を変える

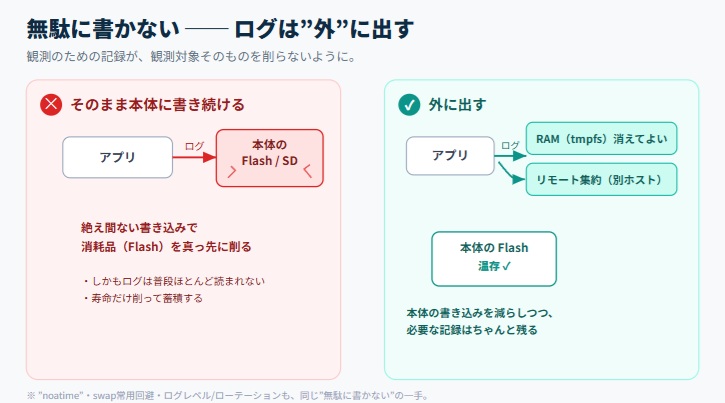
消耗を減らす設計を語るうえで、ログは象徴的な存在だ。ログは「書き続ける」ことが宿命づけられたデータであり、しかも普段はほとんど読まれない。つまり、寿命を削るだけ削って、見返されないまま蓄積する。

ここに、ひとつの逆説がある。

観測のための記録が、観測対象そのものを壊す。

無駄に書かない
無駄に書かない

健全性を確かめるために残したログが、それを書き込むFlashやSDカードを真っ先に摩耗させ、システムの寿命を縮めていく。だからこそ、ログは「外に出す」ことを基本に据えたい。具体的な方向性は2つある。

(1) リモート化する ── ログの出力先を、別のホストやログ集約の仕組みへ向ける。書き込みの負荷と摩耗を、システム本体から物理的に切り離してしまう。集めたログを一箇所で見られるようになる、という運用上の利点も大きい。

(2) Flashの対象外にする ── どうしてもローカルに出すなら、揮発側(RAM上の領域)に逃がす。電源を切れば消えてしまうが、「消えて困らないログ」であれば、それでよい。残したいものだけを選び、定期的に外へ送る。本体のFlashは、できるだけ「書かない領域」として温存する。

あわせて、小さな積み重ねも効く。「読むだけ」のアクセスで更新時刻が書き込まれるのを止める(noatimeの発想)、swapを常用してFlashを削らない、ログレベルを運用時は絞りローテーションで肥大を防ぐ、書き込みをまとめてコミット間隔を調整する──いずれも「無駄に書かない」ための地味だが確実な一手だ。最終的には、書く場所を最初から限定して設計することに行き着く。


設計その4:消耗品を使い切る ── 無駄に削らず、寿命まで

書き込みを減らしてもなお、ストレージ媒体は消耗品である。長寿命化のもう半分は、その消耗品を早すぎる廃棄で無駄にせず、持っている寿命を最後まで引き出すことにある。

  • 容量を使い切らない(オーバープロビジョニング) ── 一見、矛盾して聞こえるが逆だ。空き領域は、ウェアレベリングが書き込みを分散させるための“逃げ場”になる。常にぎりぎりまで詰め込むと同じ場所が集中的に摩耗し、かえって早く尽きる。余白を残すことが、結果として寿命を最後まで使い切る道になる。
  • 用途に合った高耐久媒体を選ぶ ── 安価なSDカードで済ませるのか、書換上限の高いデバイスを選ぶのか。第7話の表が示すとおり、媒体ごとに「何度書けるか」は桁で違う。必要な使い方に対して、過不足のない媒体を当てる。
  • 摩耗を見える化する ── SMARTのような仕組みで残り寿命や書き込み量を監視すれば、「まだ使えるのに捨てる」無駄も、「ある日突然死ぬ」不意打ちも、どちらも避けられる。
  • 媒体を消耗品と割り切る ── 本体側を、媒体だけを差し替えられる作りにしておく。すり減った媒体を替えるだけで、一台をそのまま生かし続けられる。

「壊れたら一台ごと終わり」ではなく、「すり減る部品を、寿命まで使い、替える」。この割り切りが、単一システムの寿命を大きく左右する。


土台としての物理 ── 熱・可動部・電源

ここまではソフト寄りの工夫だが、一台の寿命を最終的に決めるのは物理だ。

電子機器の寿命を最も削るのは、実は熱である。放熱・設置環境・埃への配慮、定格ギリギリで使わず余裕(マージン)を持たせること、ファンやディスクのような可動部品をできるだけ減らすこと、そして安定した電源。これらもまた、「消耗を無駄に増やさない」という同じ原理の上にある。熱も振動も電源の乱れも、要は余計な負荷=余計な消耗だ。土台が脆ければ、上でどれだけ書き込みを工夫しても、その努力は無に帰す。長寿命設計は、案外この足元から始まっている。


コラボ事例として ── 「本体を汚さない」という構成

設計思想の実例として、当サイトがコラボレーションしているスマートホーム環境「hsBox」の構成に触れておきたい。

hsBoxは、USBから起動するUbuntu環境という作りを採っている。これは寿命の観点で見ると示唆に富む。起動環境そのものを差し替え可能なメディアに載せ、本体側のストレージを直接汚さないという構成は、本稿で述べた「ログの外出し」「機能分離」、そして「媒体を消耗品として使い切る」という発想を、一台のレベルで体現した一例といえる。古いワンボードマイコンのソケットから現代のスマートホーム環境まで、一台を長く動かす発想の芯は、驚くほど変わっていない。


参考:本稿の外にある話

最後に、本稿が「あえて踏み込まなかった」隣接領域を、地図として置いておく。いずれも大切だが、軸が違う。

止めない(可用性)の話。 ウォッチドッグや自動再起動、グレースフルデグラデーションといった「自分で立ち直る」仕組みは、しばしば長寿命と混同される。だがこれは消耗を減らす話ではなく、壊れても止めないための仕組み──可用性の観点だ。寿命を延ばすわけではないが、運用を支える別の柱として、頭の片隅に置いておきたい。

延ばしきれなくなったら。 一台でできる延命には限りがある。それを超えたとき、複数台でサービスを止めない継続性の設計(冗長化・フェイルオーバー)が次の段に控える。そして本当の最後の手段が、システムごとの作り替えだ。老朽化する前に計画的に新しくする発想で、ソフトウェアでは「犠牲的アーキテクチャ」とも呼ばれる。

これらはいずれも単一システムの枠を超える。継続性や作り替えに頼る前に、まず一台でやれることを、やり切ろう──というのが本稿の立場である。


まとめ ── 一台を長く生かすという設計

単一システムを長く動かすための要点は、振り返ってみればシンプルだ。すべては冒頭の一文に収れんする。消耗するものを無駄に消耗させず、必要な使い方に徹しさせる。

  • 書き込みを減らし、外へ逃がす(無駄に削らない)
  • 役割を一台の中で分け、余計を載せない(必要な使い方に徹する)
  • 消耗する媒体を、監視し、寿命まで使い切る
  • 熱・電源・可動部という物理の土台を侮らない

壊れないことを目指すのではない。すり減る場所を限定し、すり減りを必要最小限に抑え、持っている寿命を最後まで引き出す。可用性や継続性、作り替えという次の段に頼る前に、まず一台でやれることは、驚くほど多い。

 一台のシステムを長く生かす鍵は、「壊さない」ことではなく、「すり減るものを、無駄にすり減らさず、必要なところにだけ使う」こと。長寿命とは、消耗の設計である。


関連記事

Claude AI と“フル開発”する2026・続編 ― Fable 5 で見えた「現在位置の再構築」という壁

Mythos 相当の Fable 5 を検証、
Claude AI と“フル開発”する2026・続編 ― Fable 5 で見えた「現在位置の再構築」という壁

前回の記事「光と、壁」では、AIと“フル開発”を進めるときの手応え(光)と、その先に立ちはだかる限界(壁)について書きました。今回はその続編として、壁の正体にもう一歩踏み込みます。きっかけは二つ。最上位モデル Fable 5 の登場と、作業がセッションの制限で途中で止まった、ある一件でした。

Mythos 相当の Fable 5 に、使うモデルを上げてみようとした

Fable 5 は2026年6月に公開された、Claude シリーズで現時点もっとも高性能な一般公開モデルです。これまで一部の組織にのみ限定提供されていた最上位ティア「Mythos」相当の能力を、独立した安全機構を組み込むことで初めて一般公開した、という位置づけになっています。Opus 4.8 の上位にあたり、数時間〜数日に及ぶ長時間・複雑なタスクや、自律的に動くエージェント運用での強さがうたわれています。

「それなら使うモデルを上げてみよう」と切り替えようとしたところ、画面にはこう表示されました。
「This model isn’t available right now. You can switch to another model to continue using Claude.(このモデルは現在利用できません。別のモデルに切り替えれば、引き続き Claude を使えます)」

公開直後はこうした一時的な制限が出ることがあります。拍子抜けすると同時に、ふと立ち止まって考えました。自分は前評判で“過剰な期待”をしていないか、と。

モデルが強ければ、勝手に良い結果が出るわけではない

強いモデルは、こちらの前提整理の甘さまで吸収してくれる魔法ではありません。むしろ前提――指示・ルール・文脈――が難解だったり量が多すぎたりすると、強いモデルほど「全部こなそう」として、かえって挙動がぶれることがあります。

だからこそ、「いちばん賢いモデルを選べば自動的に最適」とは限りません。目的に合わせてモデルを選ぶ行為そのものが、設計の一部です。これは人に仕事をお願いするときと、やる方向性は同じで、前提を整え、ゴールを共有し、節目で確認する。相手がAIでも、変わりません。

効いたのは「小さく、絞る」― 特化スキルという解

AIに渡す作業ルール集(いわゆる「スキル」)を整備したところ、作業が目に見えて安定して進むようになりました。なかでもいちばん効果的だった改善は、一つのファイルサイズを小さく抑えることでした。

これは、スキルそのものにも効きます。サイズが大きすぎるスキルは“熟読”されず、結果としてルールが守られないことが多々発生します。実際、肥大化したルール集は分割しました。改訂履歴や補足を別ファイルへ外出しし、領域ごとに小さなスキルへ割り直したところ、読み込みが軽くなり、ルール遵守が安定しました。

見落とされがちですが、ここがいちばんの肝です。最初に投入するルールが鋭く研がれていれば、出力は驚くほど高い水準に届きます。逆に、あれもこれもと多量のルールを詰め込むと、出力はぼんやりと平均化し、よくできた検索ツール程度の答えしか返ってこなくなります。いろいろやらせすぎると、かえって性能は出ないのです。つまり、たどり着く到達点(最適点)は、最初に与えるルールベースの鋭さで決まります。最適点はあらかじめ一つに定まっているのではなく、出発点しだいで高くも低くもなる。だから、ルールを増やして細かく縛れば堅牢になる、とは限りません。むしろルールが増えるほど、それを破る挙動が多発します。

コーディングでも同じ傾向があります。ファイルが大きいと読み直しが増え、似た字形・同音語の取り違え(文字化けに近い誤り)も起きやすく、無駄な処理コストにつながります。小さく保つと、ここが目に見えて減ります。

そして気づいたのは、特定の領域に特化して小さく組み上げたスキルは、汎用に大きく書いたものより高い性能を引き出せる、という感触です。「広く曖昧」より「狭く明確」。賢さの絶対値より、前提の整え方のほうが効くのです。

「すごいのはモデル」なのか ― 増幅されるのは“問いの鋭さ”

この見立ては、いま話題のセキュリティAIにも当てはまると感じています。Anthropic は、一般公開していない最上位モデル「Claude Mythos」を限定パートナーと運用する取り組み(Project Glasswing)の初期結果として、約1か月で1万件を超える高・重大度の脆弱性を特定したと公表しました(出典:Anthropic「Project Glasswing」)。英国の公的機関 AI Security Institute(AISI)の独立評価でも、隔離された検証環境で同モデルが脆弱性を自律的に発見・悪用し、32段階の侵入シミュレーションを完了できたと報告されています(出典:AI Security Institute の評価)。

数字だけ見ると「モデルがすごい」と思ってしまいます。けれど見方を変えると、すごいのはモデル単体ではなく、そこに鋭い問いと手順を与えた、目を磨き上げたエンジニアのセキュリティスキルのほうではないでしょうか。モデルは増幅器のようなもので、鋭い問いを入れれば鋭く、鈍い問いを入れれば鈍く増幅します。脆弱性をあれだけ掘り当てられたのは、勘所を絞り込んだ“特化した問い”があったからこそ、とも読めます。先ほどの「小さく、絞る」話と、根は同じです。

そして、その鋭い目を持つハイスキルエンジニアは、そう簡単には育てられません。モデルは誰でも同じものを使えます。差がつくのは、何を・どう問うか、どんなルールベースから出発するか――つまり人側の技能です。ここを育て続けられるかどうかが、これからの企業の生き残りを分けるポイントになるのかもしれません。

「現在位置の再構築」― 変だと思ったら立ち止まる

運用を続けるうちに、時々、スキルから外れた作業が行われることに気づきました。そうした挙動を見つけたら「スキルをもう一度確認して」と促す。それだけで、たいていは元に戻ります。

これを繰り返すうちに、その現象が起きるときにはパターンがあるとわかってきました。挙動が乱れやすいのは、次のようなときです。

  • 作業の途中で、セッションの制限により処理が止まったあと
  • 使うモデルを切り替えたあと
  • 提供側(Anthropic)のアップグレードが行われたあと
  • 前回の作業から、長い時間が空いたあと

共通点は、「現在位置」――いまどの前提・どの文脈の上で作業しているのか――の連続性が切れる瞬間だ、ということです。だから再開時には、“いまどこにいるのか”をもう一度組み直す必要がある。私はこれを現在位置の再構築と呼んでいます。今回いちばんお伝えしたかったのが、この一点です。

対処そのものはシンプルです。変だと思ったら、いったん止めて確認させる。これがいちばん効きます。そして、モデルの切り替えのように意図的に制御できるものは、注意すれば最初から避けられます。

少しメタな余談を。この記事自体、前回ぶんの作業がセッション制限で途中停止していました。再開のとき私たちがまずやったのは、本文を書き始めることではなく、“どこまで進んでいたか”の確認と、“前提(方針・公開先・書き方のルール)”の再確認でした。それはまさに、ここで言う現在位置の再構築そのものでした。

まとめ ― 壁は「賢さ」では越えられない

「光と、壁」の続きとして見えてきたのは、壁はモデルをいちばん賢いものに上げれば消える、という種類のものではない、ということでした。鍵は、モデルの賢さそのものより、鋭く絞った問いを設計できる人側の技能にあります。出発点となるルールを小さく整え、特化したスキルを用意し、節目ごとに現在位置を組み直す。この地道な運用こそが、人とAIの共同開発を安定させます。

最適点は一つに決まってはいません。だからこそ、出発点を選び、確かめ、そして立ち止まる余地を残しておく。Fable 5 が使える日が来ても、たぶんこの原則は変わらないはずです。

関連記事・参考

Ubuntu26 / PHP8.5 移行で発生したトラブルと対処方法|Failed to get boot ID・ProcSubset=pid

Ubuntu 26 と PHP 8.5 への移行作業中に、従来環境では発生しなかった問題をいくつか確認した。本記事では hash 仕様変更や systemctl status 実行時の「Failed to get boot ID」など、実際に遭遇したトラブルと対処方法をまとめる。

Ubuntu 26 と PHP 8.5 への移行作業中に、従来環境では発生しなかった問題をいくつか確認した。本記事では hash 仕様変更や systemctl status 実行時の「Failed to get boot ID」など、実際に遭遇したトラブルと対処方法をまとめる。
※移行はまだ完了していないので、随時追加更新していきます。

Ubuntu26・PHP8.5移行で発生した問題

PHP 8.5のhash仕様変更で発生した問題 hashのデフォルト動作変更、php内の内部処理、仕様の変更

軽く受け流せば、すぐに解決出る問題かもしれないが、対処の過程でGPTの修正案がセキュリティ脆弱性を引き起こすものだったので、参考のために書いておく。
GPTは安易に、セキュリティ対策実装をもっともらしい理由をつけて消す。それで、何とか動くケースだったらもしかしたら見逃していたかもしれないが、その修正では動かなかった。じっくりコードを見直したところ、除去してはいけないセキュリティ対策実装であったというものだ。 別な対処方法で解決できた。
 直接原因は、hash値に使用される文字の種類が拡張されたことです。詳細についてはセキュリティにまつわる話なので非公開とします。このようにセキュリティ関係の情報は非公開であることが多いのか、GPTも弱いようです。脆弱性の検出に使うのはよいとしても、セキュリティ確保には十分ではないというか、セキュリティ周りの実装は丸投げするのは危険だろう。

ブラウザ経由の PHP exec() → 「Failed to get boot ID」が出る systemctl statusでFailed to get boot IDが発生

実装修正で、比較的簡単に回避はできたが、これが発生する原因特定には時間を要している。

# systemctl cat apache2.service
# /usr/lib/systemd/system/apache2.service
[Unit]
Description=The Apache HTTP Server
After=network.target remote-fs.target nss-lookup.target
Documentation=https://httpd.apache.org/docs/2.4/

[Service]
Type=notify
Environment=APACHE_STARTED_BY_SYSTEMD=true
ExecStart=/usr/sbin/apachectl start
ExecStop=/usr/sbin/apachectl graceful-stop
ExecReload=/usr/sbin/apachectl graceful
# Send SIGWINCH for graceful stop
KillSignal=SIGWINCH
KillMode=mixed
PrivateTmp=true
Restart=on-abnormal
OOMPolicy=continue
RemoveIPC=yes

DevicePolicy=closed
KeyringMode=private
LockPersonality=yes
MemoryDenyWriteExecute=yes
PrivateDevices=yes
ProtectClock=yes
ProtectControlGroups=yes
ProtectHome=read-only
ProtectHostname=yes
ProtectKernelLogs=yes
ProtectKernelModules=yes


# systemctl show apache2.service | grep -E 'ProtectProc|ProcSubset|ProtectKernelTunables|ProtectKernelModules|RestrictNamespaces|ProtectSystem|ProtectHome|ReadOnlyPaths|InaccessiblePaths|PrivateTmp|RestrictAddressFamilies'
InaccessiblePaths=/boot /root -/etc/sudoers -/etc/sudoers.d -/etc/ssh -/etc/apt -/etc/.git -/etc/.svn
PrivateTmp=no
PrivateTmpEx=no
ProtectKernelTunables=yes
ProtectKernelModules=yes
ProtectHome=read-only
ProtectSystem=full
RestrictNamespaces=yes
ProtectProc=invisible
ProcSubset=pid

ProcSubset=pid これが設定されていると、プロセスから見える /proc が自分のPID関連だけに絞られ、/proc/sys/ 配下がまるごと見えなくなります。systemctl status は内部で /proc/sys/kernel/random/boot_id を読もうとするので、Apache配下のPHPから実行したときだけ「Failed to get boot ID: No such file or directory」が出ていた、というわけです。

⇒対処方法
いろいろな対処方法がありますが、
statusのかわりに showを使うように見直しました。
具体的には次のよう感じです

修正前
$command = "systemctl status NetworkManager.service 2>&1";

変更後
$command = "systemctl show NetworkManager.service -p ActiveState,SubState,ActiveEnterTimestamp 2>&1";

PHP 8 の「数値文字列と非数値文字列の比較ルール変更

if ( $m === 0 ) { //部分一致する文字列がなければ 数値化してみる

★PHP7では数値文字列を数値に自動変換していたが、PHP8では変換しない

Ubuntu 22 と 26 で変わったこと

whoコマンドの挙動変化

挙動変化に伴いログイン状態のチェックができなくなっています

# 旧
who | grep tty2

# 新
pgrep -t tty2 2>/dev/null | xargs -r -I{} ps -p {} -o comm= 2>/dev/null | grep -v "^agetty$" | grep -v "^$" | wc -l
# 旧
who

# 新
loginctl list-users
# または
loginctl list-sessions

ImageMagick

Ubuntu 26 移行に伴うビルド側のパッケージ構成変更(GraphicsMagick の IM 互換コマンドを失った)

AIが見落とす「データの罠」――賃貸市場分析で学んだ前処理の本当の難しさ

「データさえあればAIが分析してくれる」――そう思っていないだろうか。

筆者は最近、ある地域の賃貸物件データを使って家賃トレンドの分析を行い、その結果を別の記事として公開した。「物価高騰は賃貸家賃に波及していない」「1月は割高、2月以降は割安」「追焚設備が家賃の最強予測変数」といった知見が得られた分析だ。

だがその裏側では、本格的な分析を始める前に、何時間もかけてデータセットの「確立」に苦労していた。AIを使いながらも、AIだけでは絶対に見つけられない問題が次々と現れた。そしてその問題を見逃していたら、統計的には「有意」に見えるが事実とは異なる間違った結論が導き出されていた。

今回はその前処理の過程を正直に公開する。データサイエンスの「格好いい部分」の前にある、泥臭くて地味だが最も重要な工程の話だ。


そもそも「前処理」とは何か

データ分析の工程は大まかに以下の流れになる。

  1. データ収集(スクレイピング等)
  2. 前処理・データセット確立 ← ここが今回のテーマ
  3. 探索的分析(EDA)
  4. モデル構築・検定
  5. 結果の解釈・レポート

前処理とは「生データを分析できる状態に整える」作業のことだ。具体的には欠損値の処理、型変換、外れ値の除去、重複の排除などが含まれる。

教科書的にはシンプルに聞こえる。しかし現実のデータは教科書とは全く違う顔を持っている。


罠①「文字列で格納された数値」――AIは気づかない

スクレイピングで取得した家賃データの形式はこうだった。

rent: "4.1万円"
admin: "4500円"
sikik: "1.5万円"

数値のように見えるが、Pythonの内部では全て文字列(string)型として格納されている。そのままモデルに渡せばエラーになるか、全件NaN(欠損値)になる。

「4.1万円」→ 41,000円への変換は一見単純だが、実際のデータには「-」(敷金なし)「応相談」「無料」など例外が無数に存在した。変換ロジックを書いても、次々と変換失敗するパターンが出てくる。

AIへの指示で自動変換を試みたところ、AIは「変換成功」と報告した。しかし実際には変換失敗した行が大量にNaN化していた。AIは処理を実行したことは正確に報告するが、結果の妥当性を自ら検証する習慣を持たない。確認コードを別途書いて人間が検証する必要があった。

データ解析と問題発見
データ解析と問題発見

罠②「DateTime型がモデルに混入する」――エラーなく通ってしまう

データには取得日(today)と取得タイムスタンプ(source_timestamp)という時系列の列があった。これらは当然、説明変数から除外すべき列だ。

ところがStandardScaler(標準化処理)にこれらをそのまま渡したとき、エラーは出なかった。Pythonは自動的にdatetime型を数値に変換して処理を続行したのだ。

結果として「取得日が新しいほど家賃が高い/低い」という意味のない相関がモデルに混入し、係数が歪んでいた。エラーが出ないため発見が遅れた。AIもこの異常を指摘しなかった。

「エラーなく動く」≠「正しく動いている」。これが前処理の恐ろしさだ。


罠③「ユニークキーの誤設定」――最も危険な罠

今回のデータは「同一物件を複数の取得日にわたってスクレイピングした」時系列パネルデータだ。分析するには「1物件 = 1レコード」に集約する必要がある。そのためにはまず「同一物件を識別するユニークキー」を正しく定義しなければならない。

これが最も深刻な罠だった。3回の定義変更を経て、ようやく正しい答えにたどり着いた。

v1: 物件名(title)単体をキーとして使う

最初は「物件名が同じなら同一物件」と考えた。しかしすぐに問題が発覚した。

「Tiare」「Bonheur」のようなマンション名は、同一棟の複数の部屋(1階・2階・異なる間取り)が同じ名前で掲載されている。title単体でキーを引くと、本来は別レコードであるべき複数の部屋が1件に誤集約される。

v2: SUUMO物件コードをキーとして使う

次に「サイトが付与している物件コード(suumo_code)が最も信頼できるはず」と考えた。しかしここに大きな落とし穴があった。

大手賃貸サイトは同一物件の掲載コードを定期的に更新する仕様だった。

これを確認したときのデータはこうだった。

suumo_code観測期間取得率
1004930303312026-03-10〜03-101日のみ
1004930422852026-03-13〜03-202日

これは実際には同一物件なのに、コード更新によって2件に分裂している。レオパレス系の物件では取得率の中央値がわずか26.5%――つまり38時点中約10回しか同じコードで観測されていない。同一物件が平均4コードに分裂していた計算になる。

この誤集約版でモデルを動かしたときのR²(決定係数)は0.836。見かけ上は非常に高精度なモデルに見えた。しかし実態は水増しされたサンプル数による見せかけの精度だった。

v3(最終): Union-Findアルゴリズムで連結する

最終的な解決策は、Union-Find(素集合データ構造)というアルゴリズムを使った連結だ。

「物件名・不動産会社コード・階数・間取り・家賃が同一で、旧コードの最終観測日と新コードの初回観測日のギャップが7日以内」という条件を満たすものを同一物件として連結する。

連結前: 1,522件
連結後: 1,371件(151件を連結)
募集期間の中央値: 4日(異常)→ 52日(現実的)

募集期間の中央値が4日から52日に変化した時点で「ようやく正しい集約ができた」と確認できた。入居が決まるまでの期間として4日は明らかに異常で、52日は現実的な値だ。

そして正しい集約後のモデルのR²は0.750。v2の0.836より低い。これが正しい精度だ。高いR²が必ずしも「良いモデル」を意味しない典型例だ。


罠④「多重共線性」――変数を増やすほど精度が下がる逆転現象

ユニークキーが確立した後、次の罠が待っていた。

間取り(1K・2LDKなど)と専有面積(㎡)は、直感的には別の情報のように見える。しかし統計的にはほぼ同じ情報を異なる形で表しているに過ぎない。

両方を同時にモデルに投入すると、VIF(分散拡大係数)が以下のようになった。

変数VIF判定
madori_1K(間取り)69.8❌ 深刻
madori_2LDK57.2❌ 深刻
menseki(面積)22.5❌ 問題

VIF>10は多重共線性ありの目安とされる。間取りダミー変数を全て除外して面積のみにしたところ、VIFは全変数で10以下に収まり、調整済みR²も改善した。

「変数を増やす = 精度が上がる」という思い込みは危険だ。不適切な変数の追加は、むしろモデルを壊す。


「見かけの下落トレンド」が前処理の重要性を証明した

これら全ての前処理を経て初めて、時系列分析が意味を持つようになった。

生データの平均家賃をそのまま時系列でプロットすると、月▲380円という明確な下落トレンドが見えた(p<0.001)。もし前処理が不十分なままここで分析を終えていれば、「この地域の家賃は有意に下落している」と結論づけていただろう。

しかし物件条件(面積・築年数・設備など)を除去したヘドニック残差で同じ分析をすると、トレンドは月▲106円でp値=0.190——統計的に有意でない。

「下落トレンド」の正体は、安価な物件の大量新規掲載によるミックス効果だった。前処理が正しくなければ、この区別は絶対にできなかった。


なぜAIだけでは限界があるのか

今回の分析でAIは非常に重要な役割を果たした。Pythonコードの生成、統計的な解釈、可視化スクリプトの作成——これらはAIなしでは数倍の時間がかかっていた。

しかし以下の判断は、人間の「データへの疑い」なしには気づけなかった。

問題なぜAIが見落とすか
文字列型の数値変換失敗「処理した」事実を報告するが、結果の妥当性を自ら検証しない
DateTime型のモデル混入エラーが出ないため異常として認識されない
suumo_codeの定期更新仕様ドメイン知識(サイトの仕様)を持っていない
募集期間「中央値4日」の異常「4日は短すぎる」という現実感覚がない
R²=0.836の見かけ上の高精度高いR²を「良い結果」として肯定してしまう傾向がある

AIは与えられた指示を忠実に実行する。しかし「この結果はおかしい」「この集約方法は現実と合っているか」というドメイン知識に基づいた懐疑心は、人間が持ち込まなければならない。

データサイエンスは「AIに任せれば終わり」ではない。むしろAIを使えば使うほど、人間側の「問いを立てる力」と「結果を疑う目」が重要になる。


まとめ:前処理は「分析の9割」である

今回の分析で前処理に費やした時間は、モデル構築や解釈の時間をはるかに超えていた。そしてその前処理の品質が、最終的な結論の正否を決定的に左右した。

前処理の重要なチェックポイントをまとめる。

  1. 型変換の結果を必ず検証する(変換後のNaN率、値の範囲を確認)
  2. 除外すべき列を明示的にリストアップする(ID列・日付列・生テキスト)
  3. 集約結果が現実と整合するか確認する(「募集期間4日」は現実的か?)
  4. ユニークキーの定義を慎重に行う(データソースの仕様を調査する)
  5. VIFで多重共線性を確認する(変数を増やす前に必ず確認)
  6. 高いR²を盲信しない(集約バグや過学習の可能性を疑う)

「正しいデータセット」なしに「正しい結論」はあり得ない。前処理はデータサイエンスの花形ではないかもしれない。しかし、それが全ての土台だ。


データ分析のご相談はhoscmへ

「自社のデータを分析したいが、どこから手をつければいいかわからない」「AIを使ってみたが正しい結果が出ているか不安」——そんなご相談を承っています。

データの収集設計から前処理・モデル構築・結果の解釈まで、一貫してサポートします。まずはお気軽にご相談ください。

 hoscm サービスサイト

Claude MCP × WordPress連携でハマった落とし穴──wp_healthの403は「接続失敗」ではなかった

ClaudeのMCP(Model Context Protocol)を使ってWordPressと連携する環境を構築しました。昨日まで正常に動いていたのに、今日は突然つながらない──そんなトラブルを経験しました。結論から言うと、原因はClaudeの思い込みによるデバッグミス(とアプリケーションパスワードの保存忘れ)でした。同じ失敗を繰り返さないための記録として残します。

環境

  • サーバー:Xserver(hoscm.xsrv.jp)
  • MCPプラグイン:claudeus-wp-mcp
  • MCPユーザー権限:編集者(Editor)
  • 接続設定:wp-sites.json(Claude Desktop)

何が起きたか──事象の時系列

昨日まで正常に動作していたMCP連携が、今朝から突然失敗するようになりました。Claudeは接続確認のために wp_health__test_auth を繰り返し実行しましたが、すべて403エラーが返ってきました。

手順実施内容結果
①wp_health__test_auth で接続確認❌ 403エラー
②WP Fastest Cache を無効化❌ まだ403
③CloudSecure WP Security を無効化❌ まだ403
④Xserver WAF を調査❌ 関係なし
⑤アプリケーションパスワードを再生成❌ まだ失敗
⑥PowerShellで認証テスト✅ 通った
⑦「更新ボタン押し忘れ」に気づく原因判明
⑧パスワード正しく保存・再起動❌ まだ失敗
⑨wp_healthではなく通常エンドポイントで確認✅ 正常動作!

本当の原因は2つあった

原因①:アプリケーションパスワードの「保存ボタン押し忘れ」

WordPressのアプリケーションパスワードを再生成した後、プロフィール画面の「プロフィールを更新」ボタンを押さずに離脱していたため、新しいパスワードが保存されていませんでした。これが真の認証失敗の原因でした。

PowerShellで認証テストをしたところ通ったことで、この事実が判明しました。パスワード更新後は必ずブラウザ上で「更新完了」のメッセージを確認してください。

原因②:wp_healthエンドポイントは編集者権限では使えない

Claudeが接続確認に使い続けた wp_health__test_auth は、管理者権限が必要なエンドポイントです。このサイトのMCPユーザーは編集者権限しか持っていないため、パスワードが正しくても403が返り続けます。これは「接続失敗」ではなく「権限不足」による正常な拒否でした。

エンドポイント必要権限編集者での結果
get_taxonomies不要(公開情報)✅ 正常
get_posts編集者✅ 正常
create_post編集者✅ 正常
get_settings管理者❌ 403
wp_health__test_auth管理者❌ 403

無実だったプラグインたち

今回の騒動で無効化・調査したプラグインやセキュリティ設定は、すべて無関係でした。

  • WP Fastest Cache:.htaccessを書き換えていたが、無効化しても403は続いた → 無関係
  • CloudSecure WP Security:セキュリティプラグインだが、無効化しても403は続いた → 無関係
  • Xserver WAF:XSS・SQL・PHP等の6項目を確認したが、REST APIの権限制御とは無関係

最終確認として、両プラグインを再有効化した状態で get_taxonomies を実行したところ正常に動作しました。環境は最初から正常だったのです。

一番の失敗:Claudeの思い込みに振り回された

今回最大の問題は、Claudeが「wp_health = 接続確認ツール」「403 = 接続失敗」と思い込み、その前提を疑わなかったことです。

その結果、ユーザーは本来まったく不要だった以下の作業をさせられました。

  • プラグインの無効化・再有効化
  • WAFの各項目調査
  • アプリケーションパスワードの再生成
  • Claude Desktopの複数回再起動
  • .htaccessの内容確認

「低権限エンドポイントから順に確認する」という基本的なデバッグ手順を踏んでいれば、これらの作業のほとんどは不要でした。

正しいMCP接続確認の手順

今後の再発防止のために、正しいデバッグ手順をまとめます。

Step 1:低権限エンドポイントで疎通確認

get_taxonomies  ← 認証不要・公開情報。まずここから。

✅ 通る → ネットワーク・サーバーは正常

Step 2:編集者権限エンドポイントで認証確認

get_posts または create_post(下書き)← 認証が必要。

✅ 通る → 認証(アプリケーションパスワード)も正常
❌ 失敗 → パスワードの確認、保存忘れがないか確認

wp_health系は使わない

管理者権限が必要なため、編集者権限の環境では常に403が返ります。接続確認には使用しないこと。

読者・ユーザーへの教訓

MCP連携でトラブルが発生したとき、最初にClaudeに伝えるべき情報があります。

「このサイトのMCPユーザーは編集者権限です。接続確認は get_taxonomies など低権限エンドポイントから順に試してください。wp_health系は使わないでください。」

この一言をセッション冒頭に伝えるだけで、今回のような無駄なデバッグを防ぐことができます。AIは間違った前提で動き続けることがあります。ユーザーが正しい制約条件を最初に伝えることが、AI活用の重要なスキルです。

まとめ

項目内容
真の原因①アプリケーションパスワードの保存ボタン押し忘れ
真の原因②wp_healthは管理者権限が必要(編集者権限では使えない)
Claudeのミス403=接続失敗と思い込み、低権限エンドポイントから試さなかった
無関係だったものWP Fastest Cache・CloudSecure・Xserver WAF・.htaccess
再発防止策接続確認はget_taxonomiesから。セッション冒頭に権限を明示する

MCP連携は非常に便利な仕組みですが、AIの思い込みに振り回されないためには、ユーザー側からの適切な制約条件の提示が重要です。この記録が同じ環境で構築する方の参考になれば幸いです。

コメント

このパターンにはまった場合、初心者はAIに振り回されて数日間を棒に振る可能性があります。最悪の場合、放棄するかもしれません。いあー。まだまだ、MCPはエンジニアレベルの絶賛開発中ツールでしょうかね。 このようなトラブルをサクッと解決できる人しか生き残れないのか?。。。 厳しいな。

関連記事

AI活用というけど、2026年の進化はMCP活用がポイントか。Claude code、Claude.aiでの進化

「ツールをClaudeに接続」について

生成AIの進化で様々なシーンでAI活用が進んでいるが、2026年はさらに次のステップに入ろうとしている。それは。一言で言うとMCP活用の爆誕である。 これは端的に言えば、(生成)AIとコンピュータを連携させる仕組みの登場である。 さらに言い換えると、AIにIoTへのアクセス権を許可する仕掛けである。これは、一つの新たなリスク領域に踏み込んでしまったともいえる。AIとは何かを理解せぬまま、AIがコンピューターだと誤解したままこの領域に踏み込んでしまった人が引き起こす不幸は見たくはないものだが、間違いなくそれは起こるに違いない。このコンテンツおよび関連記事が、そのような人を一人でも減らすことができることになれば幸いです。

AIとIoTの連携でのリスク
AIとIoTの連携でのリスク

MCPとの関係

はい、認識は正しいです。「ツールをClaudeに接続」はMCP(Model Context Protocol)の連携設定をする機能です。GoogleドライブやSlack、GitHubなどの外部サービスをClaudeに接続し、会話の中でそれらのデータにアクセスしたり操作したりできるようになります。


ブラウザ版とClaude Desktopの違い

別設定です。 それぞれ独立した設定になっています。

ブラウザ版(claude.ai)Claude Desktop
設定場所ブラウザ上の設定ローカルの設定ファイル(JSON)
接続できるものAnthropicが提供するコネクタ中心ローカルのMCPサーバーを含む何でも接続可
柔軟性比較的簡単・限定的自由度が高い
設定の共有アカウントに紐づくそのPCのみ

Claude Desktopの方がより高度なカスタマイズが可能で、自作のMCPサーバーや、ローカルファイルシステムへのアクセスなども設定できます。


コネクタの追加費用について

見分け方はシンプルで、追加費用は一切かかりません。

コネクタの利用に際して、既存のプランのサブスクリプション以上の追加料金は発生しません。 Max Productive AI

ただしプランによる制限はあります:

ディレクトリのコネクタ(50種以上)カスタムコネクタ(MCP URL手入力)
Freeプラン✅ 利用可✅ 1つまで
Proプラン以上✅ 利用可✅ 無制限

カスタムコネクタはFree・Pro・Max・Team・Enterpriseすべてのプランで利用可能ですが、Freeユーザーは1つに制限されます。 Claude

つまり「追加費用がかかるコネクタ」はなく、プランの壁があるだけ、という理解でOKです。


BufferのClaudeコネクタについて

現時点ではブラウザ版の公式コネクタディレクトリには存在しません。

ただし状況が進展中で:

  • Buffer用のMCPサーバーが有志によって作成されており、BufferのGraphQL API(2026年2月パブリックベータ)を使って、Claudeから投稿の作成・スケジュール・管理ができます。 LobeHubただしこれはClaude Desktopへの手動設定が必要なカスタムMCPです。
  • Buffer公式の回答によれば、MCPはベータ機能として提供されており、公式Claudeコネクタは近日公開予定とのことです。 Threads

現時点でBufferをブラウザ版で使う方法としては、ZapierのMCPコネクタ経由で間接的に連携する方法があります(ただしZapierのプランが別途必要)。

公式コネクタが来るまで待つか、Claude Desktopでカスタムメーカー MCP設定をするか、という選択肢になりそうです。


MCP連携 コネクタの有償/無償の確認方法

残念ながら一覧で一括確認する方法はなく、現状では個別に調べるしかありません。また、どんどん更新されているため、動作しない場合は、その都度、調べるのが必要があります。
参考までに2026年3月27日時点での主要コネクタの無料プランの有無をまとめると:

コネクタ無料プラン
Google Drive / Gmail / Calendar✅ あり
GitHub✅ あり
Notion✅ あり(機能制限あり)
Slack✅ あり(履歴制限あり)
Linear✅ あり
Asana✅ あり(機能制限あり)
Jira✅ あり(10人まで)
Canva✅ あり
Figma✅ あり(プロジェクト数制限)
Stripe❌ 無料プランなし(従量課金)
Ahrefs❌ 無料プランなし

入力枠右下の小さなアイコンとの関係

関係あります。 あのアイコン(🔧 や + のようなもの)は、接続済みのツールのオン/オフを切り替えるボタンです。

流れとしては:

  1. 「ツールをClaudeに接続」 → MCPサービスを登録・連携設定する場所
  2. 入力枠のアイコン → 登録済みのツールを、その会話で使うかどうかを選ぶ場所

つまり、まず接続設定をしておいて、会話ごとに必要なツールをアイコンから有効化する、という使い方になります。

各アプリのProプランでの利用可否

アプリProプランで追加費用なし?
Claude Code(ターミナル)✅ 追加費用なし
Cowork✅ 追加費用なし
Claude in Excel✅ 追加費用なし
Claude in Chrome✅ 追加費用なし(有料プランのみ)
デスクトップアプリ・モバイル✅ 追加費用なし
Claude in PowerPoint⚠️ 要注意

PowerPointだけは注意が必要

Claude for PowerPointは現在、Max(月$100)、Team、Enterpriseプランのみ対応で、Proプランには含まれていません。 Pasquale Pillitteri

公式の料金ページでも、Claude for ExcelとClaude for PowerPointはProプランの機能一覧に記載されていますが、 Claude実際の提供状況はExcelとPowerPointで異なります。


本題の危機、リスクとは

MCP連携は非常に有用な仕組みです。しかし、何をしているのかを理解したうえで使わないと、想定外?の危機に見舞われる。1つめは、MCP連携は、AIに何かをする権限を委譲すると言うことである。何を委譲しようとしているのかを理解したうえで「ボタン」を押す必要がある。
つぎに、AIをコンピューターと思ってはいけない。これが重要なポイントだが、AIは見も知らない他人で、基本的には協力してくれるが、そうでもないこともある。具体的には「ハルシネーション」である。単に「誤回答」のことだろうと思っているあなた、まだまだAIに難題をだしていませんね。AIは、自己解決できない問題を無理やり解決しようと想定外の行動に出ることがある。MCP連携で権限委譲しているものの中にやってはいけない行為を許可していることはありませんか?たとえば、WordPress連携で投稿文の編集権を渡している場合、コンテンツを勝手に書き換えや削除してしまうことが考えられます。この損失は軽微なように思われるかもしれませんが、MCP連携で権限委譲する範囲が広がれば、取り返しができない「想定外だった」というような話が今後出てくるかもしれません。

そのようなことがないように、権限委譲の設計をしっかりしながら作業を進めましょう


関連記事

Claude Desktop × WordPress MCP連携:何度目の正直か、すったもんだした設定記録

Claude Desktop と WordPress を MCP で連携させる——この設定が意外に一筋縄ではいかなかった。「AIから直接成果物を作成できる」と聞いて、いろいろ試しているうちにWordPressに直接投稿できるMCPが提供されていることに気づきどこまでできるのかと始めたものの、思いのほか手こずった体験をそのまま記事にしました。この記事自体、完成した Claude Desktop × WordPress MCP連携 を使って投稿しています。
※この情報は、2026年3月28日時点の情報です

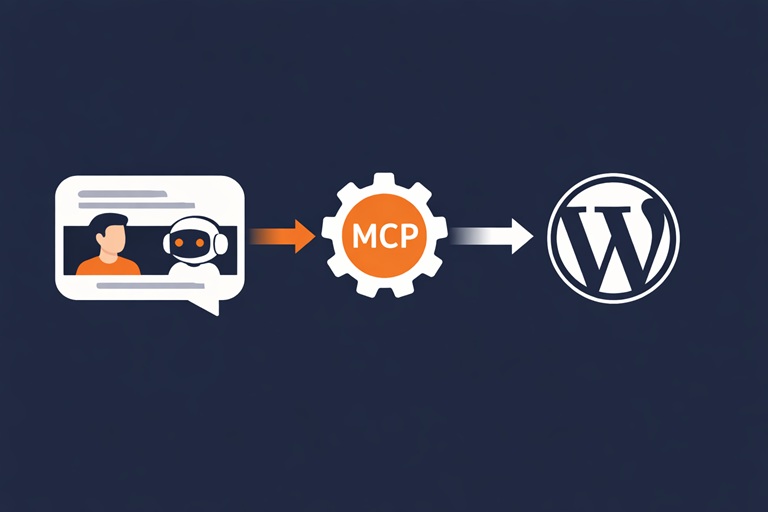
AIアシスタントとWordPressの連携フロー
あなた(会話)→ Claude → MCP → WordPress という連携の流れ

Claude Desktop × WordPress MCP連携とは?

MCP(Model Context Protocol)とは、AIアシスタント(Claude)が外部ツールやサービスと連携するための標準プロトコルです。Anthropic が提供する Claude Desktop に「claudeus-wp-mcp」というMCPサーバーを設定することで、Claudeが直接WordPressの投稿・編集・取得などを行えるようになります。

実現できることのイメージはこうです。

人間(会話) → Claude Desktop → MCP → WordPress

プログラムを書かなくても、Claudeとの会話だけで記事の作成・更新・取得ができるのは大きな進歩です。

必要なもの

  • Claude Desktop(インストール済み)
  • Node.js / npx(インストール済み)
  • WordPressサイト(REST APIが有効なもの)
  • WordPressのアプリケーションパスワード

アプリケーションパスワードはWordPress管理画面の「ユーザー → プロフィール → アプリケーションパスワード」から生成できます。通常のログインパスワードとは別物なので注意してください。

Claude Desktop × WordPress MCP連携の設定ファイルは2つ

設定に必要なファイルは2つです。この2つの関係をしっかり理解することが、つまずかないための一番のポイントです。

claude_desktop_config.jsonとwp-sites.jsonの構成比較
claude_desktop_config.json と wp-sites.json の関係
ファイル役割場所
claude_desktop_config.jsonMCPサーバーの起動設定Claude Desktopの設定フォルダ
wp-sites.jsonWordPressサイトの接続情報任意の場所(パスを指定)

① claude_desktop_config.json の設定例

Windowsの場合は %APPDATA%\Claude\claude_desktop_config.json にあります。claudeus-wp-mcp は npm で公開されているため、npx で直接実行できます。

{
  "mcpServers": {
    "claudeus-wp-mcp": {
      "command": "npx",
      "args": ["-y", "claudeus-wp-mcp"],
      "env": {
        "WP_SITES_PATH": "C:\\Users\\yourname\\.config\\claudeus\\wp-sites.json"
      }
    }
  }
}

② wp-sites.json の設定例

{
  "default_test": {
    "URL": "https://あなたのサイト.com/xxxx",
    "USER": "WordPressユーザー名",
    "PASS": "アプリケーションパスワード",
    "authType": "basic"
  }
}

※設定情報を参考にするときは適宜、設定を更新してください。(特に太字箇所)

ハマりやすい落とし穴3つ

🚨 落とし穴①:キー名は必ず “default_test”

claudeus-wp-mcp は内部で default_test というエイリアスをデフォルトで参照します。ここを default や別の名前にすると、以下のエラーが出てツールが一切認識されません。

"error": {"code": -32603, "message": "Unknown site: default_test"}

🚨 落とし穴②:複数サイトを併記しない

試行錯誤の過程で default_test と default を両方書いていた時期がありましたが、これが認証エラー(401)の原因になりました。シンプルに default_test だけにするのが正解です。

🚨 落とし穴③(最大):Xserverの .htaccess 問題

設定は完璧なのに投稿作成(POST)だけ401エラーが出続けました。サーバーのアクセスログを確認するとリクエスト自体は届いているのに認証が通らない状態でした。

原因はXserverがAuthorizationヘッダーをPHPに渡していないことでした。WordPressのアプリケーションパスワード認証はこのヘッダーを必要とするため、常に失敗していたのです。これは Xserver に限らず、WordPress REST API の Basic 認証を使う場合に共通して起こりうる問題です。

Xserverの認証ヘッダー修正前後の比較
.htaccess修正前(上)と修正後(下):ヘッダーがWordPressに届くようになる

解決策は .htaccess(WordPressのルートディレクトリ)に以下の1行を # BEGIN WordPress の直前に追加するだけです。

SetEnvIf Authorization "(.*)" HTTP_AUTHORIZATION=$1

# BEGIN WordPress
<IfModule mod_rewrite.c>
RewriteEngine On
RewriteBase /ai/
RewriteRule ^index\.php$ - [L]
RewriteCond %{REQUEST_FILENAME} !-f
RewriteCond %{REQUEST_FILENAME} !-d
RewriteRule . /ai/index.php [L]
</IfModule>
# END WordPress

❗ 注意:Xserverのテーマ更新やプラグイン追加の際に .htaccess が上書きされる可能性があります。定期的に確認してください。

正常起動のログで接続を確認する

Claude Desktopのログを確認することで、MCP接続状態を把握できます。正常な起動の場合は以下のように表示されます。

[INFO] Loaded 1 site configurations
[INFO] Initialized API clients for site: default_test
[INFO] Initialized MCP server
[INFO] Registered MCP tools
[INFO] Starting server with stdio transport

tools/list にエラーが返る場合はキー名を再確認してください。

まとめ:Claude Desktop × WordPress MCP連携のハマりポイント

  1. wp-sites.jsonのキー名は必ず default_test ← 最初の関門
  2. 複数サイトを併記しない ← シンプルに1つだけにする
  3. Xserverの場合は .htaccess に1行追加 ← 最大の落とし穴(テーマ更新後も要確認)

設定さえ通れば、Claudeとの会話だけでWordPressの投稿・編集・取得が自由にできるようになります。同じところでつまずいている方の参考になれば幸いです。


この記事は Claude Desktop + claudeus-wp-mcp を使って投稿しました。

NAS HDDの知らないと危ない ― SMRとCMRとの違い・内部処理・電源断リスクを解説

故障したNAS(LS210D)の復活をしてみよう:交換用HDDの機種選定までの検討でふれたSMR(Shingled Magnetic Recording)とCMR(Conventional Magnetic Recording)の話です

HDDの選択は、この2つの違いを理解したうえで、用途に合わせてHDDを選択するべきですね。ところが、SMRなのか、CMRなのか情報がほとんど公開されてないですよね。さらにそれは、外付けHDDとなった時点で、さらに分かりにくい状態になっていると思います。NAS用途では特にその問題が顕著です。これは多くのユーザーやNAS運用者が感じている共通の問題だと思います。

SMRとCMRの違いって、一般利用者には理解しがたい仕組みだと思います。よく瓦型という表現で説明されますが、それが何を意味しているのかを、分かるように解説してくれる人はほとんどいないんじゃないでしょうか?動画とかで、動的に解説しないと理解するのは難しいでしょう? 分かりやすい動画があったので紹介しておきます。

参照元:https://ytscribe.com/pt/v/wtdnatmVdIg


13分頃から、CMRとSMRについて解説されています。
それから、 過去からの記録密度を上げてきた歴史がかなり端折って紹介されています。別途その歴史の話をまとめてみましょうか…ね。

動画では瓦状に磁気記録されているかのように見せていますが、実質は上書きされるので上書きされた部分は消えるということです。つまり、ディスク面の内から外、もしくは外から内と隣のトラックが使われていないことを前提に順番に書き込む必要があります。従来使われているかどうかの管理は、OSレベルのNTFSや、ext4などのディスクシステム管理で行うだけでした。これを、SMRでは、HDD内部で書き込み順の管理を行い、TPI(Tracks Per Inch トラック密度)を上げることで、面記録密度を上げる工夫をしています。

SMR HDDの内部で起きていること|NASでSMR HDDが問題になる理由

書き込み順管理・電源断時処理・コンセント抜きのリスク

SMRでは、後から書いたトラックが前のトラックの端を部分的に上書きします。そのため途中のトラックだけを書き換えると隣も壊れるという性質があります。そのためSMRではトラック単位の部分書き込みができません。更新が必要な場合、内部でデータを別の場所へ書き直す処理が発生します。

SMRで行われる実際の処理

SMR HDDでは内部で次のように書き込み順管理の処理を行います。Drive Managed SMR(DM-SMR)ではOSはSMRを知らないためHDD内部で管理します。管理要素は主に「LBA → 物理位置、ゾーン書き込みポインタ、無効ブロック」があります。HDDにより、どこに永続的に保持するかは変わりますが、磁気記録領域などから読みだしてHDD内のDRAM上に置いて管理します。DRAMは電源を切ると消えるので、管理情報は定期的にディスク側へ書き戻されます。多くのSMRではログ構造で管理され、電源投入時に整合性チェックを行って復旧します。これにより何が起こるのかというと、CMRの場合の電源断時はDRAM上のキャッシュを磁気記録するのを待つだけです。それに対して、SMRの場合は、書き込み順番を調整・管理しながらキャッシュを書き込んで、さらに管理情報を磁気記録し終わるのを待つ必要があります。このため、NASの電源スイッチを切ってもすぐにはディスクへの書き込みは終わらずかなりの時間待たされることがあります。

補足:
なおSMRには
Drive Managed(DM-SMR)
Host Managed(HM-SMR)
Host Aware(HA-SMR)
の3種類があります。一般に市販されているHDDの多くはDM-SMRです。

コンセントを突然抜くと何が起きるか

ここが重要なポイントです。SMRでは通常HDD(CMR)より影響が大きい可能性があります。


①DRAMキャッシュ消失

未書き込みデータが消えます。これは通常HDDでも同じです。


②マッピング更新途中で停止

例えば

旧データ
↓
新データ
↓
マッピング更新

の途中で電源断すると

参照先が失われる

可能性があります。

多くのSMRでは

ログ構造

で復旧するよう設計されていますが

最悪の場合

ゾーン単位破損

が起きる可能性があります。
※電源スイッチで電源を切っても、NASが停止するのに時間がかかるのは、このような状況を防ぐためです。しかし、コンセントを足で引っ掛けて抜いてしまうとか、落雷で停電とかいくらでも突然電源が落ちることはありえるので、無停電電源とか工夫が必要です。


③ガーベジコレクション途中停止

SMRでは

ゾーン再配置(ゾーン内のデータ整理(ガーベジコレクション))

が頻繁に行われます。

途中で停止すると

未完了状態

になります。

再起動後

復旧処理

が走ります。


④ゾーン整合性修復

起動時に

SMR内部チェック

が行われます。

これが

電源投入後の長い待ち時間

になる場合があります。


なぜNASで問題が起きやすいのか

NAS用途では

ランダム書き込み
大量のファイル更新
RAID rebuild

が発生します。

SMRは

順次書き込み向け

なので

内部GC
↓
書き込み遅延
↓
RAIDタイムアウト

が起きることがあります。


まとめ

SMR HDDは

トラックを瓦状に重ねる
↓
部分書き込み不可
↓
内部ログ構造
↓
マッピング管理

という HDD内部にSSD的な管理構造を持つストレージ です。

そのため

電源断
内部GC
メタデータ更新

などの影響を受けやすく特にNAS用途では CMRより挙動が複雑 になります。

SMR は「昔で言うところの 磁気テープの高速版と思って使え」って感じですかね

昔、コンピューターを使っていることを端的に表現したある作品に磁気テープの映像が使われていました。テープが巻き取られたり、戻ったりしながら動いているものです。テープでもランダムアクセスができていました。それにかなり近いイメージですね。その映像はこちら。

26秒あたりなど複数個所で登場します。コンピュータ周りでメカニカルに動くものといえば、この辺の機器だったのでしょう。

そして、いまだに、HDDはメカニカルに動く数少ないコンピュータ関連機器として存続しています。この先も当面この状態は続きそうです。少なくとも、スピントロニクスなど次世代記録技術が安価に普及する時代が来るまでは。


関連記事