ComfyUIで動画生成を試してみる ― MiniMax H3を実際に動かしてみた

これまでコード生成を中心に試してきましたが、今回は一歩進んで、ComfyUIを使った動画生成を試してみることにしました。

今回使用したのはWindows版の ComfyUI Desktop。

動画生成用のテンプレートを確認すると、MiniMax H3、LTX-2.5、LTX-2.3、Wan 2.2、Hunyuan Videoなど、非常に多くのワークフローが用意されています。

はじめに

これまでコード生成を中心に試してきましたが、今回は一歩進んで、ComfyUIを使った動画生成を試してみることにしました。

今回使用したのはWindows版の ComfyUI Desktop。

動画生成用のテンプレートを確認すると、MiniMax H3、LTX-2.5、LTX-2.3、Wan 2.2、Hunyuan Videoなど、非常に多くのワークフローが用意されています。

あまりにも数が多いため、今回はその中からまず、

MiniMax H3:テキストから動画へ

を試してみることにしました。

そして、MiniMax H3でいくつか動画を生成した後、次の比較対象として Wan 2.2 5B に進むことにしました。


1. ComfyUIには動画生成用テンプレートが大量にある

ComfyUI Desktopの動画生成テンプレートを確認すると、かなりの数のワークフローが用意されています。

今回確認しただけでも、

  • MiniMax H3
  • LTX-2.5
  • LTX-2.3
  • Wan 2.2 14B
  • Wan 2.2 5B
  • Wan Animate
  • Hunyuan Video 1.5
  • SCAIL-2
  • InfiniteTalk
  • Wan VACE
  • Kandinsky 5.0 Video
  • LTXV

など、さまざまな動画生成モデルが並んでいました。

画面には

157件中64件のテンプレートを表示中

と表示されており、動画生成だけでもかなりの選択肢があります。

最初から全部を試すのは現実的ではないので、今回はMiniMax H3から始めます。


2. MiniMax H3のテキスト→動画を試す

選択したのは、

MiniMax H3:テキストから動画へ

というワークフローです。

最初はノードグラフが複雑に見えました。

しかし、よく見ると動画生成に必要なモデルやエンコーダ、解像度設定などがすでに接続された状態になっています。

さらに、動画生成の中心となるノードには、かなり長い英文プロンプトが最初から入力されていました。

この英文をクリックしてみると、普通の入力欄として編集できます。

そこで、まず非常にシンプルなプロンプトに変更しました。

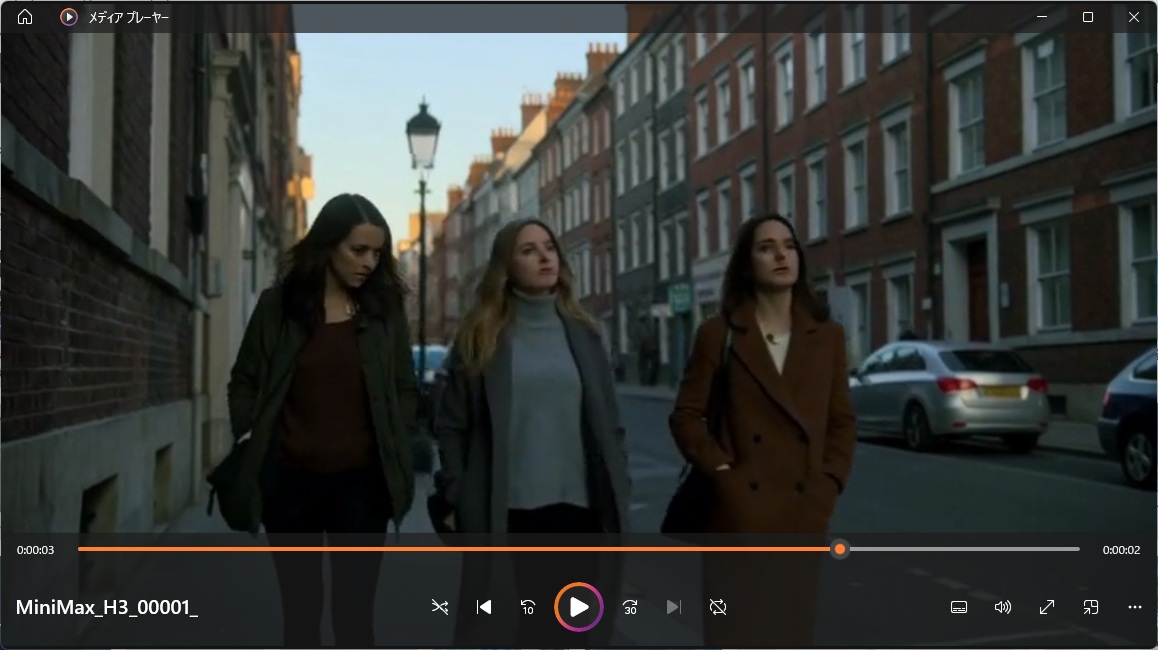
Three young women walking slowly through a quiet city street in the early morning, cinematic

これだけでも、実際に動画を生成することができました。

MiniMax_H3

3. RTX 3080 10GBで実際に動画生成

今回使用しているGPUは、

NVIDIA GeForce RTX 3080 10GB

です。

動画生成中には、

  • GPU使用率:100%
  • VRAM使用量:約9.6GB / 10GB
  • GPU温度:約87℃
  • 消費電力:約265W

という状態になりました。

かなりGPUを使っています。

しかし、生成中のGPU使用状況を見る限り、きちんとGPUを使って動画生成できていることが確認できました。

その後、生成が終了するとGPU使用率は大きく低下し、温度も40℃程度まで下がりました。

したがって、今回の環境では、

RTX 3080 10GBでMiniMax H3の動画生成を実行できる

というところまでは確認できました。


4. 5秒の動画生成には約10分

最初のテストでは、5秒程度の動画を生成しました。

生成時間は、

約10分

でした。

次に20秒程度の動画も試してみました。

こちらは、

約50分

ほどかかりました。

単純計算では、

動画長生成時間
約5秒約10分
約20秒約50分

という結果です。

もちろんプロンプトや設定、生成条件によって変わるため、この数字をそのまま一般化することはできません。

しかし、少なくとも今回のRTX 3080環境では、

「数秒の動画なら試せるが、20秒になるとかなり待つ」

という感覚でした。


5. プロンプトはかなり効く

次に、もう少し具体的な指示を入れてみました。

例えば、

A young woman walking slowly through a quiet city street at sunset, cinematic

というプロンプトです。

これを生成すると、

  • 女性が登場する
  • 街を歩く
  • 夕方の雰囲気になる
  • シネマティックな映像になる

など、プロンプトの内容がかなり反映されました。

つまり、単純なテキスト→動画生成については、かなり素直に指示が効いている印象です。


6. もう少し複雑な指示を入れてみる

次に、複数の人物とカメラワークまで指定してみました。

使用したプロンプトは、概ね次のような内容です。

早朝の東京の街をさっそうと歩く5人の若い女性が、
正面から歩いてきて、とおりすぎる。
同時にカメラがパンして女性を追い、
その後ろ姿を追う。

結果は非常に興味深いものでした。

うまくいったところ

  • 女性たちが歩く
  • 東京らしい街の雰囲気が出る
  • 複数人が登場する
  • 正面から歩いてくる
  • カメラワークをある程度意識した映像になる

など、プロンプトの意図はかなり反映されました。

一方で、細かい部分では問題もありました。


7. 「東京の街」が「郊外の住宅地」になった

指定では「東京の街」としていました。

ところが生成された映像は、東京の繁華街というより、

郊外の住宅地に近い街並み

になりました。

これは画像・動画生成AIではよくある問題です。

「東京」という単語を入れただけで、必ずしも

  • 高層ビル
  • 繁華街
  • 日本の看板
  • 大量の人
  • 車
  • 駅前

といった具体的な東京のイメージになるわけではありません。

そこで、次のテストでは「東京」をさらに具体化しました。


8. 「5人」と指定しても5人とは限らない

もう一つ面白かったのが人物の人数です。

プロンプトでは、

5人の若い女性

と明確に指定していました。

MiniMax_H3_00002

ところが、最初の生成では、

4人

になりました。

動画生成AIでは、複数人物の人数を正確に維持することが難しい場合があります。

そこで次のテストでは、

Exactly five young adult women

と、人数をさらに強く指定しました。

すると、今度は、

5人が登場しました。

これはかなり重要な結果でした。

「5人」と書くよりも、

Exactly five

と明示した方が、今回のテストでは人数を維持しやすくなりました。


9. 東京の繁華街を具体的に指定する

次のプロンプトでは、東京の街をより具体的にしました。

Exactly five young adult women walking confidently toward the camera on a busy downtown Tokyo street in the early morning. Dense urban Tokyo scenery, tall buildings, Japanese storefronts, crosswalks and city traffic. All five women are clearly visible. Smooth cinematic camera movement, realistic live-action, natural walking motion.

今度は、

「東京の繁華街」

という指定はかなりうまく反映されました。

また、

5人

という人数指定も成功しました。

ここから、

「抽象的な指定より、具体的な視覚情報を並べた方がよい」

という傾向が見えてきました。


10. ところが、5人が車道を歩いてしまった

一方で、別の問題が発生しました。

「東京の繁華街を5人の女性が歩く」

という指示は反映されたのですが、

なんと女性たちが、

自動車道の真ん中を歩いていました。

これはかなり「AI動画らしい」結果です。

人間なら、

東京の繁華街を女性5人が歩く

と聞けば、普通は歩道を想像します。

しかしAIにとっては、

「街を歩く」=必ず歩道

ではありません。

そこで次のテストでは、

They stay on the sidewalk and never walk on the road.

のように、歩く場所を明示する必要があると判断しました。


11. 一番難しかったのはカメラワーク

今回もっとも苦戦したのが、

カメラの動き

です。

例えば、

カメラが後退しながら女性たちを追う

という指示を入れても、期待したほどカメラが動きませんでした。

さらに、

女性たちを追いながらパンする

という指示に対しては、

カメラが連続して動くのではなく、別のカットに切り替わったような映像

になることもありました。

また、

女性たちを通り過ぎた後、後ろ姿を追う

という指定については、

後ろ姿のシーン自体が生成されませんでした。

これは今回の実験でかなり重要なポイントでした。


12. MiniMax H3で分かったこと

ここまでの実験を整理すると、MiniMax H3では、

比較的うまくいった

  • 人物を歩かせる
  • 複数人物を登場させる
  • 「5人」という人数をある程度指定する
  • 東京の繁華街を具体的に指定する
  • 朝・夕方などの時間帯を指定する
  • 映画的な雰囲気を指定する
  • 自然な歩行をさせる

難しかった

  • 正確な人数を常に維持する
  • 「東京」の具体的な場所を想定通りにする
  • 歩道などの細かな位置関係
  • カメラを指定通りに動かす
  • パンや追従撮影
  • 一つの連続したカメラワーク
  • 前から後ろ姿へ自然につなぐ

という傾向が見えてきました。


13. 次はWan 2.2 5Bへ

ここまで試したところで、次のモデルとして、

Wan 2.2 5B

を試すことにしました。

ComfyUIには、

Wan 2.2 5Bビデオ生成

というテンプレートが用意されています。

これを選択すると、MiniMax H3とは異なるノード構成のワークフローが自動的に展開されました。

こちらにも、

  • Positive Prompt
  • Negative Prompt

の2つの入力欄があります。

今回は、MiniMax H3で問題になった部分を意識して、より具体的なプロンプトを設定しました。

Positive Prompt

Exactly five young adult women walking confidently together on the sidewalk of a busy downtown Tokyo street in the early morning. Dense urban Tokyo scenery with tall buildings, Japanese storefronts, traffic lights, crosswalks and city traffic in the background. All five women are clearly visible and walking side by side toward the camera. They stay on the sidewalk and never walk on the road. Realistic live-action, natural human walking motion, cinematic composition. The camera slowly moves backward in front of the five women, keeping them clearly framed throughout the shot. Continuous single shot, no cuts.

Negative Prompt

fewer than five people, more than five women, duplicate people, extra limbs, deformed hands, distorted faces, malformed bodies, people merging together, people disappearing, walking on the road, empty suburban street, rural scenery, low-rise residential neighborhood, static camera, camera cut, scene transition, sudden viewpoint change, unnatural walking, frozen people, jittery motion, blurry faces, cartoon, anime, illustration, CGI

MiniMax H3で発生した問題を、できるだけNegative Promptにも反映させています。


14. まずは5秒動画で比較する

Wan 2.2 5Bのワークフローでは、

長さ:121

FPS:24

となっています。

計算すると、

121 ÷ 24 = 5.04秒

です。

したがって、今回は実質的に約5秒の動画としてテストすることにしました。

いきなり20秒動画を生成すると、今回の環境ではかなりの時間がかかる可能性があります。

まず5秒で、

  • 5人になるか
  • 東京の繁華街になるか
  • 歩道を歩くか
  • 正面から歩いてくるか
  • 自然に歩くか
  • カメラが後退するか
  • ワンカットになるか

を確認します。


まとめ

今回、初めて本格的にComfyUIで動画生成を試してみました。

第一印象としては、

「思った以上にプロンプトが効く。しかし、細かな演出指定になると急に難しくなる」

というものでした。

「女性が歩く」

という程度なら比較的簡単です。

しかし、

5人の女性が
東京の繁華街の歩道を
正面から歩いてきて、
カメラが後退しながら追い、
そのまま通り過ぎ、
後ろ姿を追い続ける

となると、一気に難易度が上がります。

特に、

「何を映すか」

と

「カメラをどう動かすか」

は別の問題として考えた方がよさそうです。

今回のMiniMax H3の実験では、人物や背景についてはかなり指示できましたが、カメラワークについては思い通りにならない部分がありました。

そこで次回は、Wan 2.2 5Bがこの部分をどこまで改善できるのかを試してみます。

同じような内容を生成して比較すれば、

MiniMax H3とWan 2.2 5Bでは、どちらが「人物」「背景」「人数」「カメラワーク」を得意としているのか

も見えてくるはずです。

ComfyUIでのローカル動画生成は、まだ始めたばかりです。

次回はWan 2.2 5Bの5秒動画から、実際の生成結果の詳細を検証してみたいと思います。

関連記事

OllamaでGPUが使われない?――Windows環境でQwen3を検証して分かった「GPU未使用」の正体

OllamaでGPUが使われない原因をWindows・NVIDIA・CUDA・llama-serverのログから詳しく検証。Qwen3:4Bでは22/37層がGPUへオフロードされた一方、Qwen3:8Bは4GB VRAMの制約からCPU中心に。nvidia-smi、ollama ps、server.logを使った確認方法を解説します。


はじめに――「Ollamaを使っているのにGPUが動いていない?」

ローカルLLMをWindows PCで動かしていると、こんな疑問にぶつかることがあります。

「NVIDIA GPUを搭載しているのに、OllamaでGPUが使われていないように見える」

特に、OllamaでQwen3などのLLMを動かしている場合、タスクマネージャーを見るとGPU使用率が低かったり、CPU使用率ばかりが高かったりします。

さらに、Ollamaの内部で使われている llama-server.exe を直接調べて、

llama-server.exe--list-devices

と実行したところ、

Available devices:  (none)

と表示されれば、

「やはりCUDAが認識されていないのでは?」

と考えてしまいます。

実際、今回の環境でもまさにこの現象が発生しました。

ところが、Ollamaのログを詳しく調べてみると、結論はまったく違っていました。

GPUは使われていたのです。

しかも、Qwen3:4Bでは、

CUDA0 model bufferoffloaded 22/37 layers to GPU

という、GPUオフロードを明確に示すログが確認できました。

一方、Qwen3:8BではGPUが使われず、CPUのみで動作していました。

この記事では、この調査過程をもとに、

  • OllamaでGPUが使われないように見える理由
  • CUDAが本当に動作しているか確認する方法
  • llama-server.exe --list-devices の意味
  • Ollamaのログを見る重要性
  • GPUオフロードとVRAM容量の関係
  • Qwen3:4BとQwen3:8Bで結果が違った理由
  • OLLAMA_LIBRARY_PATH をむやみに変更しないほうがよい理由
  • --gpu-layers、--fit、--device などの意味

について、実際のログを交えながら整理します。


1. 今回の環境

今回検証したのは、Windows上でOllamaを利用してローカルLLMを動かす環境です。

GPUは、

NVIDIA GeForce GTX 1050 Ti / VRAM 4GB

です。

CPUはIntel Core i7-8700、メモリは16GBという環境です。

Ollamaでは、これまでQwen系モデルを中心に動作確認を行ってきました。

特に今回比較したのは、

  • Qwen3:4B
  • Qwen3:8B

です。

ここで重要なのは、「モデルの大きさ」と「GPUに載るかどうか」は別問題ではあるものの、VRAM容量が大きく影響するということです。

4GB VRAMしかないGTX 1050 Tiでは、8Bクラスのモデルを完全にGPUへ載せるのは難しくなります。


2. 最初の疑問:「llama-serverにGPUがない?」

まず、Ollamaが使用している llama-server.exe の場所を調べました。

PowerShellで、

Get-ChildItem"C:\Users\maps\AppData\Local\Programs\Ollama\lib\ollama" `-Recurse-Filter"llama-server.exe"|Select-ObjectFullName

を実行します。

すると、

FullName--------C:\Users\maps\AppData\Local\Programs\Ollama\lib\ollama\llama-server.exe

と表示されました。

そこで、この実行ファイルを直接起動して、

&"C:\Users\maps\AppData\Local\Programs\Ollama\lib\ollama\llama-server.exe"--list-devices

を実行します。

結果は、

Available devices:  (none)

でした。

これは一見すると、かなり重大な問題に見えます。

「CUDAが入っていない?」

「NVIDIA GPUを認識していない?」

「OllamaがCPU版になっている?」

と考えるのは自然です。

しかし、ここでこの結果だけを見て「GPUが使われていない」と判断してはいけません。


3. 決定的だったのはOllamaのserver.log

次に確認したのがOllamaのログです。

Windowsでは、

Get-Content"$env:LOCALAPPDATA\Ollama\server.log"-Tail100

のようにしてログを確認できます。

ここで非常に重要なログが見つかりました。

Qwen3:4Bを読み込んだとき、

load_tensors: offloading output layer to GPUload_tensors: offloading 21 repeating layers to GPUload_tensors: offloaded 22/37 layers to GPU

と表示されていました。

さらに、

load_tensors:    CUDA0 model buffer size = 1515.48 MiBload_tensors:    CUDA_Host model buffer size = 1164.72 MiB

とも表示されています。

これは非常に重要な情報です。

つまり、

Qwen3:4Bでは実際にCUDAデバイスへモデルの一部がオフロードされています。

「GPUが使われていない」のではありません。

むしろ、

GPUに全部は載らないため、GPUとCPUを組み合わせて動かしている

という状態です。


4. 「GPU使用率が低い」=「GPUを使っていない」ではない

ここはローカルLLMを扱ううえで非常に重要です。

GPUを使っているかどうかを、

WindowsタスクマネージャーのGPU使用率

だけで判断するのは危険です。

LLMの推論では、モデルのすべてがGPUに載っているとは限りません。

たとえば、

モデル ├─ GPU │   ├─ Layer 1 │   ├─ Layer 2 │   ├─ ... │   └─ Layer 22 │ └─ CPU     ├─ Layer 23     ├─ ...     └─ Layer 37

というような構成が可能です。

今回のQwen3:4Bでは、まさに、

37 layers↓22 layers GPU15 layers CPU側

というGPUオフロードが行われています。

llama.cppでは --gpu-layers / --n-gpu-layers によってVRAMへ置くレイヤー数を指定できます。また現在のllama.cppには、デバイスのメモリに合わせて設定を調整する --fit もあります。

したがって、

GPU使用率が100%ではない

ことと、

GPUを使っていない

ことは同じではありません。


5. Qwen3:4BではGPUが実際に使われていた

今回もっとも重要な証拠は、このログです。

load_tensors: offloading output layer to GPUload_tensors: offloading 21 repeating layers to GPUload_tensors: offloaded 22/37 layers to GPU

さらに、

CUDA0 model buffer size = 1515.48 MiB

となっています。

つまり、

CUDA0に約1.5GBのモデルバッファが確保されている

ことが確認できます。

さらにKVキャッシュも、

llama_kv_cache:      CUDA0 KV buffer size =   672.00 MiBllama_kv_cache:      CPU KV buffer size =     480.00 MiB

となっていました。

ここから分かることは、

モデル本体だけでなく、KVキャッシュもGPU側に一部配置されている

ということです。

これは「GPUが使われている」という非常に強い証拠です。


6. では、なぜQwen3:8BではGPUを使わなかったのか?

ここでQwen3:8Bを見てみます。

ログには、

print_info: model type          = 8Bprint_info: model params        = 8.19 Bprint_info: general.name        = Qwen3 8B

とあります。

さらに、

print_info: file size = 4.86 GiB

となっています。

ここが重要です。

GTX 1050 TiのVRAMは4GBです。

一方、モデルファイルだけで、

4.86 GiB

あります。

つまり、

モデルそのものがVRAM容量を超えている

わけです。

しかも、LLMを実行するにはモデル本体だけあればいいわけではありません。

KVキャッシュや計算用バッファなども必要になります。

したがって、

4GB VRAM    ↓Qwen3:8B    ↓モデルだけで4.86GiB    ↓さらにKV cacheなどが必要

となれば、4GB VRAMに完全に収めることはできません。


7. Qwen3:8BはCPU動作になった

実際のログも、それを裏付けています。

load_tensors:          CPU model buffer size = 1818.63 MiBload_tensors:   CPU_REPACK model buffer size = 3159.00 MiB

さらに、

llama_context: CPU output buffer sizellama_kv_cache: CPU KV buffer size

そして、

sched_reserve: CPU compute buffer size

となっています。

つまり今回のQwen3:8Bは、

CPU側にモデルを配置して推論している

と判断できます。

これは、

「CUDAが壊れている」

「NVIDIA GPUが認識されていない」

という意味ではありません。

単純に、

4GB VRAMではQwen3:8BをGPU中心で動かす条件が厳しい

ということです。


8. 「モデルサイズ4.86GiB」なのに4GBなら、なぜ一部GPUに載せないのか?

ここは少し注意が必要です。

「4.86GiBなら、4GBに収まらないのだからGPUは一切使えない」と単純に考えることもできますが、実際にはGPUオフロードにはさまざまな構成があります。

llama.cppには、

--gpu-layers--device--split-mode--tensor-split--fit

など、GPU/CPU間の配置を調整する仕組みがあります。

特に現在のllama.cppでは、

--fit [on|off]

があり、デフォルトは on です。

--fit は、利用可能なデバイスメモリに合わせてモデルやコンテキストなどの設定を調整するための仕組みです。

つまり、

「全部GPUに載せられないなら、CPUとGPUを組み合わせる」

という考え方ができます。

ただし、モデルやバージョン、利用可能なメモリ、コンテキストサイズなどによって最適な配置は変わります。


9. --list-devices の (none) はどう考えるべきか?

今回、一番混乱したのがここでした。

直接、

llama-server.exe--list-devices

を実行すると、

Available devices:  (none)

です。

しかしOllamaのログでは、

CUDA0 model buffer size

が存在しています。

つまり、

直接起動したllama-server        ↓--list-devices        ↓(none)        VSOllama        ↓runner / llama-server        ↓CUDA0        ↓GPU使用

という状態です。

ここから分かるのは、

「--list-devices の結果だけを根拠にOllamaのGPU動作を判断してはいけない」

ということです。

llama.cppのドキュメント上、--list-devices は利用可能なデバイス一覧を表示するオプションです。--device はオフロードに使用するデバイスを指定し、--gpu-layers はVRAMへ置く最大レイヤー数を指定します。

しかし、Ollamaが内部でrunnerを起動する際には、環境やバックエンド、ライブラリの読み込み方などが関係します。

そのため、

llama-server.exe --list-devices が (none)
↓
OllamaもGPUを使っていない

とは限りません。


10. 一番信頼できるのは「実際のロードログ」

では、何を見ればいいのでしょうか。

個人的には、今回の調査を通じて、

実際にモデルをロードしたときのログが最も重要

だと考えています。

例えば、

offloading output layer to GPUoffloading 21 repeating layers to GPUoffloaded 22/37 layers to GPU

というログがあれば、GPUオフロードが行われています。

さらに、

CUDA0 model buffer size = ...CUDA0 KV buffer size = ...CUDA0 compute buffer size = ...

などがあれば、GPU側に実際のバッファが確保されています。

逆に、

CPU model bufferCPU KV bufferCPU compute buffer

だけであれば、CPU動作の可能性が高くなります。


11. nvidia-smi も必ず使いたい

WindowsでNVIDIA GPUを使っている場合、OS側からGPU状態を確認する方法として、

nvidia-smi

も非常に有効です。

LLMを実行している状態で、

nvidia-smi

を実行すれば、

  • GPU使用メモリ
  • GPU使用率
  • GPUプロセス
  • GPU温度
  • GPU負荷

などを確認できます。

特に重要なのは、

モデルをロードした直後だけでなく、実際に推論している最中に確認すること

です。

アイドル状態ではGPU使用率が低くても不思議ではありません。


12. ollama ps も確認する

Ollama側では、

ollamaps

も確認ポイントです。

モデルが現在ロードされているか、CPU/GPUの利用状況がどうなっているかを見るための手掛かりになります。

ただし、ここでも重要なのは、

一つの表示だけで結論を出さない

ことです。

おすすめは、

ollama ps      ↓nvidia-smi      ↓server.log

の3方向から確認することです。


13. OLLAMA_LIBRARY_PATH を変更すればGPUが使える?

今回の調査では、次のような環境変数も試しました。

$env:OLLAMA_LIBRARY_PATH="...\cuda_v13"

そして、その状態で、

llama-server.exe--list-devices

を実行しても、

Available devices:  (none)

でした。

ここで、

「CUDAのパスが違うのでは?」

と考えて、さらに環境変数を変更したくなります。

しかし、今回のケースでは、これは慎重に扱うべきです。

なぜなら、すでにOllamaの実際のログで、

CUDA0 model buffer

が確認できているからです。

つまり、

Ollama内部ではCUDAバックエンドが正常に動いている

からです。

この状態で環境変数を次々変更すると、逆に環境を複雑にしてしまう可能性があります。


14. 「GPUを使わせるための設定変更」が逆効果になることもある

ローカルLLMでは、

GPUを使わせたい
↓
GPU layerを最大にする
↓
VRAM不足
↓
起動失敗・クラッシュ

ということもあります。

特にVRAMが4GB程度しかない場合は注意が必要です。

今回のような環境では、

GPUに全部載せる

ことを目標にするより、

GPUに載せられるところまで載せるCPUとGPUを適切に分担する

という考え方のほうが現実的です。

llama.cppの現在のserverオプションでも、--fit はデバイスメモリに合わせて設定を調整するための機能として用意されています。


15. コンテキストサイズもVRAMを消費する

今回のQwen3:8Bでは、

llama_context:n_ctx = 4096

となっていました。

一方、Qwen3:4Bでは、

n_ctx = 8192

でした。

LLMでは、モデル本体だけではなくコンテキスト長に応じてKVキャッシュなどのメモリ使用量も増えます。

今回Qwen3:4Bでは、

CUDA0 KV buffer = 672 MiBCPU KV buffer   = 480 MiB

となっていました。

つまり、コンテキストサイズは単なる「何文字まで読めるか」という設定ではなく、

GPU/CPUメモリ使用量にも関係する重要な設定

です。

VRAMが少ないPCでは、

32K↓16K↓8K↓4K

のようにコンテキストを減らすことで、モデルを動かしやすくなる場合があります。


16. だから「GPUが使われない」ときの調査順序が重要

今回の経験から、Windows + Ollama + NVIDIA GPUで問題を調査するときは、次の順序がおすすめです。

STEP 1:GPUそのものを確認

nvidia-smi

ここでNVIDIA GPUが正常に認識されているか確認します。


STEP 2:Ollamaのバージョンを確認

ollamaversion

バージョンによって内部のrunnerやllama.cppの挙動が変わる可能性があるため、最初に記録しておきます。


STEP 3:モデルをロードする

例えば、

ollamarunqwen3:4b

などでモデルを実際にロードします。


STEP 4:ollama ps

ollamaps

モデルの実行状態を確認します。


STEP 5:nvidia-smi

モデルがロードされた状態で、

nvidia-smi

を実行します。

VRAM使用量が増えていれば重要な手掛かりになります。


STEP 6:server.log

最終的に一番重要なのが、

Get-Content"$env:LOCALAPPDATA\Ollama\server.log"-Tail150

です。

ここで、

CUDA0offloadingGPU

などを探します。


17. ログからGPU使用を判断するキーワード

Ollama/llama.cppのログを見るときは、次の文字列を検索すると便利です。

GPU動作を示す可能性が高いもの

CUDA0offloadingoffloadedGPUCUDA model bufferCUDA KV bufferCUDA compute buffer

例えば、

offloaded 22/37 layers to GPU

は非常に分かりやすいです。

一方、

CPU model bufferCPU KV bufferCPU compute buffer

が並んでいる場合はCPU中心の動作を疑います。

llama.cpp自身もGPUオフロードの確認では、実行開始時にGPUへ処理がオフロードされていることを示す診断情報を見る方法を案内しています。


18. 「GPUを使う」には段階がある

ローカルLLMでは、

GPUを使う / 使わない

の二択で考えないほうが分かりやすいです。

実際には、

レベル1:完全CPU

CPU└── モデル全部

レベル2:一部GPU

GPU├── 一部のLayer└── KV cacheの一部CPU├── 残りのLayer└── その他

レベル3:ほぼGPU

GPU├── モデル├── KV cache└── 計算

レベル4:完全GPU

GPU└── ほぼすべて

というように段階があります。

VRAMが4GBのGTX 1050 Tiでは、Qwen3:4Bはレベル2~3に近い使い方が現実的です。

一方、Qwen3:8Bでは今回、CPU中心になりました。


19. 今回の検証結果を表にすると

項目Qwen3:4BQwen3:8B
パラメータ約4B約8.19B
モデルQ4系Q4系
VRAM4GB4GB
GPUオフロードありなし/CPU中心
GPU Layer22/37なし
CUDA0 model buffer約1.5GBなし
KV cacheGPU + CPUCPU
コンテキスト81924096
動作GPU/CPU混在CPU中心
CUDA正常モデルサイズ上の制約

この比較から、非常に重要なことが分かります。

同じOllama、同じPC、同じGPUでも、モデルによってGPUの使われ方は変わります。


20. 「GPUが使えない」のではなく「GPUに載せられない」場合がある

これは今回の記事で最も伝えたいポイントです。

「OllamaでGPUが使われない」

という問題を見つけたとき、

CUDAが壊れているNVIDIAドライバがおかしいOllamaがCPU版

と考えがちです。

しかし実際には、

GPUは正常↓CUDAも正常↓OllamaもGPUを使える↓ただしモデルが大きすぎる↓GPUに載せられない↓CPU中心で動く

というケースがあります。

今回のQwen3:8Bがまさにこれに近い状況でした。


21. さらに重要なのは「Ollama」と「llama.cpp」の関係

Ollamaは単独ですべてのLLM処理を実装しているわけではありません。

今回のログに登場した、

llama-server

は、Ollamaがモデル実行に利用している推論ランナーの重要な構成要素です。

そのため、

Ollama  ↓runner  ↓llama-server  ↓llama.cpp / ggml  ↓CUDA  ↓NVIDIA GPU

という関係を意識すると、トラブルシューティングがかなり分かりやすくなります。

llama.cpp側には、

--device--gpu-layers--split-mode--tensor-split--fit

など、GPUとCPUへの配置を制御するためのオプションがあります。

つまり、OllamaのGPU問題を調べるときには、

Ollamaだけを見るのではなく、内部で動いているllama.cpp/llama-serverのログを見る

ことが重要です。


22. 4GB VRAM環境では「小さいモデル」が強い

今回の検証から、4GB VRAM環境ではモデル選択そのものが重要だと分かります。

例えば、

1B1.5B3B4B

あたりは比較的扱いやすくなります。

一方、

7B8B

になると、量子化していてもVRAM 4GBでは厳しくなります。

もちろんCPUとGPUを組み合わせれば動かせるモデルもあります。

しかし、

「動く」と「快適に使える」は別

です。

特にユーザーが目指しているのが、

ローカルだけで完結する自走型の開発環境

であれば、単純に最大モデルを選べばいいわけではありません。

応答速度、安定性、メモリ使用量、コンテキスト長、コード生成能力などを総合的に考える必要があります。


23. 今回の調査で分かったこと

今回の検証結果をまとめると、次のようになります。

① --list-devices が (none) でもGPU使用を即否定しない

Available devices:  (none)

だけでは、Ollama全体のGPU利用状況を判断できません。


② Ollamaの実際のserver.logを見る

今回、

offloaded 22/37 layers to GPU

という決定的な証拠がありました。


③ Qwen3:4BはGPUを使えている

CUDA0 model buffer = 1515.48 MiB

というログからもGPU利用が確認できます。


④ Qwen3:8Bは4GB VRAMでは厳しい

モデルサイズが、

4.86 GiB

あり、GTX 1050 Tiの4GB VRAMを超えています。

そのためCPU中心の動作になりました。


⑤ GPU使用率だけでは判断できない

一部レイヤーだけGPUへオフロードする構成では、GPU使用率が低くてもGPUは実際に仕事をしています。


⑥ OLLAMA_LIBRARY_PATH をむやみに変更しない

GPUが本当に使えていることがログで確認できたなら、環境変数を変更し続けるより、まず現在の構成を把握することが重要です。


24. まとめ――OllamaのGPU問題は「GPUがない」のか「GPUに載らない」のかを分けて考える

OllamaでGPUが使われないように見えたとき、最初にやるべきことは、

設定を変更することではありません。

まず、

GPUが認識されているのか↓CUDAが動作しているのか↓OllamaがGPUを使っているのか↓モデルの一部だけGPUに載っているのか↓モデルそのものがVRAMに収まらないのか

を一つずつ確認することです。

今回の環境では、最初は、

llama-server.exe --list-devicesAvailable devices:  (none)

という結果から、

「GPUが使えないのでは?」

と考えました。

ところが、Ollamaのログを調べると、

offloading output layer to GPUoffloading 21 repeating layers to GPUoffloaded 22/37 layers to GPU

となっていました。

つまり、

GPUはちゃんと使われていた。

ただし、

Qwen3:4BとQwen3:8Bでは、GPUに載せられる量が違った。

これが今回の調査で得られた最も重要な結論です。

ローカルLLMでは、

「GPUを使っているか?」ではなく、「モデルのどの部分をGPUで処理しているか?」

という視点を持つことが重要です。

特にVRAMが4GB程度の古いGPUでも、モデルサイズや量子化、コンテキストサイズを適切に選べば、OllamaによるローカルLLM環境を十分に構築できます。

そして、GPU問題で困ったときには、タスクマネージャーの数字だけを見るのではなく、

nvidia-smi
ollamaps

そして、

Get-Content"$env:LOCALAPPDATA\Ollama\server.log"-Tail150

の3つを組み合わせて確認することをおすすめします。

「GPUが使われていない」のか、それとも「GPUには載せられないモデルをCPUで動かしている」のか。

この違いが分かるだけで、OllamaのGPUトラブルシューティングはかなり見通しがよくなります。


ローカルLLMと貧弱なPCで自走コーディングを試行してみた ― qwen3:4b+Cline 検証記録

ローカルLLMだけで自走コーディングは成立するのか。つまりAIが自分で調べ、直し、実行し、エラーが出たら再修正する。そこまで届くかを確かめました。

使ったのは手元の非力なPCと qwen3:4b です。結論から言うと、枠組みは動きました。しかし、速度と粘りはまだ足りません。さらに、途中で文字コードの事故まで起きました。

検証に使ったマシンとモデルの比較はこちらの記事にまとめています。また、前提の整理としてローカルLLM時代への準備検討を開始するもあわせてどうぞ。

検証の前提|qwen3:4b で自走コーディングは成立するか

処理速度はいまひとつです。ただし、なんとか実用ラインに乗りそうなモデルとして qwen3:4b を選びました。調整はまだ必要です。それでも、チューニングのし甲斐はありそうだと感じています。

今回の狙いは「コードを書かせること」ではありません。そうではなく、あらかじめ作業ルールを与えておけば、ルールに沿って自走コーディングできるのかを見ることです。

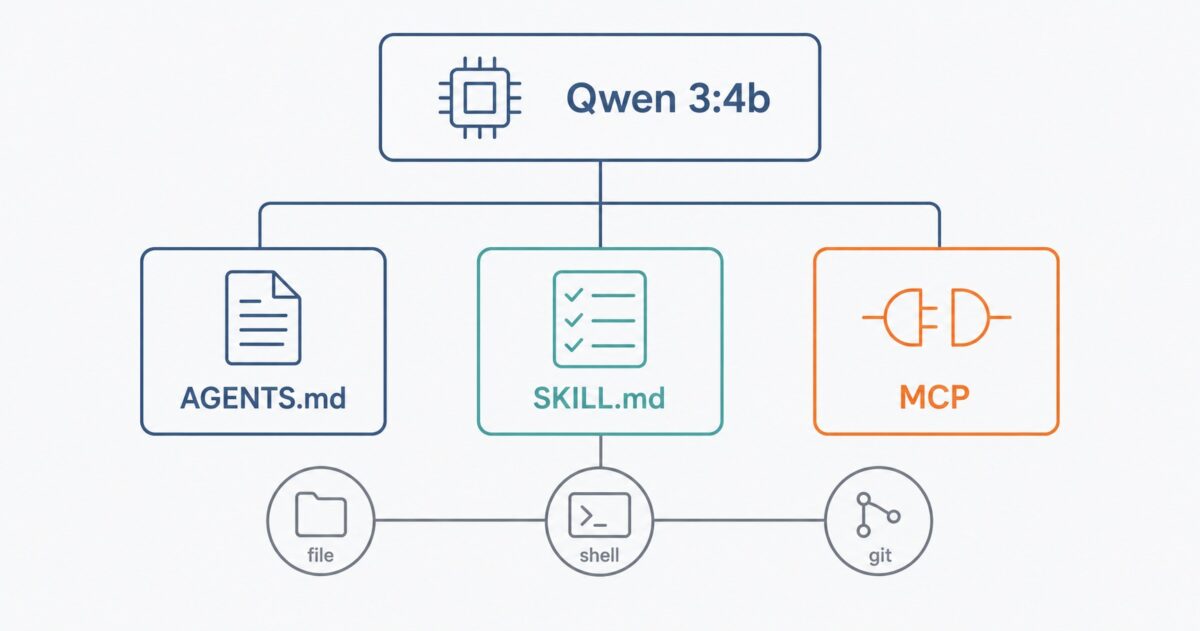
ローカルLLMに「作業ルール」を持たせる4つの方法

Qwen 本体に「Skill」の仕組みはありません。そこで、次の4つを組み合わせて再現します。

方法できること有効度
System Prompt常に守らせる基本ルールを設定★★★★★
Ollama Modelfileルール込みの専用モデルを作る★★★★★
AGENTS.md 等プロジェクトごとの作業ルール★★★★★
MCP/Skill的な仕組み特定作業をツールとして実行★★★★☆

例えば Ollama なら、Modelfile で専用モデルを作れます。

FROM qwen3:4b
SYSTEM """
あなたはローカル開発専用AIです。
プロジェクトディレクトリ外のファイルを変更してはいけません。
作業前に必ずプロジェクト構造を確認してください。
ファイルを変更した場合は、変更内容を確認してください。
可能な場合はテストを実行してください。
エラーが発生した場合、自分で原因を調査し、
可能な範囲で修正してから再度テストしてください。
"""
ollama create my-qwen-dev -f Modelfile
ollama run my-qwen-dev

ただし、ここが重要です。Modelfile だけでは「Skill」になりません。「Pythonを書ける」ことと、「ファイルを読んで直して実行する」ことは別です。なぜなら、後者は推論ではなくツール側の仕事だからです。実際には、MCP や Cline がその役割を担います。

実際に組んだ構成

D:\model\codes\test
 ├─ AGENTS.md          … プロジェクト固有ルール
 ├─ hello.py           … 検証対象
 └─ skills
      ├─ python\skill.md
      ├─ testing\skill.md
      └─ wordpress\skill.md

+ System Prompt(Qwen 側)
+ MCP(filesystem / terminal / git)

ポイントは考え方です。Skill をモデルに学習させない。外部の手順書として持たせる。こうすると、毎回同じ前提をプロンプトで説明せずに済みます。したがって、パラメータの小さいモデルほど恩恵が大きくなります。

検証1|AIがルールファイル自体を書き換えてしまう

最初につまずいたのは AGENTS.md でした。作業を進めるうちに、AGENTS.md が Cline 自身に書き換えられていたのです。しかも内容が変質していました。「開発の恒久ルール」ではなく、「Skillsシステムを構築する作業の指示書」になっていたのです。

例えば「今回の作業では既存のソースコードを変更しない」という一行。これはその場かぎりの制約です。しかし、恒久ルールとして残ってしまう。その結果、「hello.py を修正して」と頼んでも詰みます。

そこで AGENTS.md を一度きれいに戻しました。さらに、保護条項を明記しました。

## Skill管理
- Skillファイルは作業手順を定義する設定ファイルである。
- 通常の開発作業では SKILL.md を変更してはいけない。
- Skillの新規作成・変更・削除は、ユーザーから明示的に指示された場合のみ行う。
- ユーザーの今回限りの要求や仕様をSkillに追加してはいけない。
- AGENTS.md 自身を変更する場合も、ユーザーの明示的な許可を必要とする。
- 存在しないSkillをAIの判断だけで新規作成しない。

検証2|hello.py 修正タスクで自己修正まで届かなかった

指示は一行だけです。「hello.py を修正して、Hello と現在時刻を表示するプログラムにしてください。」

  • hello.py を変更した … ○
  • python hello.py を実行した … ○
  • エラーを検出した … ○
  • 原因を調べて修正し、再実行した … ×

実行結果はこうです。

Hello
Traceback (most recent call last):
  File "D:\model\codes\test\hello.py", line 3, in <module>
    print(datetime.now())
AttributeError: module 'datetime' has no attribute 'now'

原因は import の書き方です。import datetime と書いたうえで datetime.now() を呼んでいます。だから属性が見つかりません。正しくは次のどちらかです。

# パターンA
import datetime
print("Hello")
print(datetime.datetime.now())

# パターンB
from datetime import datetime
print("Hello")
print(datetime.now())

つまり、自走コーディングの肝であるループが途切れました。「エラー検出 → 原因調査 → 修正 → 再テスト」のうち、最後の一歩で止まったのです。

訂正|testing Skill は勝手に作られたものではなかった

検証の途中で、Cline が skills/testing/skill.md を何度も求めてきました。そのため、一時は「AIが勝手に作ろうとしている」と見なしていました。しかし、これは誤りでした。

実際には、Skills 構築の過程で自分で導入したファイルでした。実ファイルを見れば一目瞭然です。

PS D:\model\codes\test> Get-Content -Encoding UTF8 .\skills\testing\skill.md
# テストスキルルール
- テストコードの作成:unittestまたはpytestを使用し、テストケースを明確に定義する
- テストの分割:1つのテストクラスに1つのテストケースを含める
- テストデータの管理:fixtureを使用して共通のテストデータを再利用する
- テストの自動実行:pytestコマンドでテストを実行する
- エラーハンドリング:テストで例外が発生した場合は、明示的に処理する

この訂正自体が、実は大きな教訓です。つまり、AIの自己申告も、人間の記憶も、どちらもあてにならないということです。そのため、検証は必ず実ファイルで行うべきでした。

検証3|保護ルールは効いていた

保護条項を入れたあと、もう一度 Cline に作業させました。その結果は明らかに改善していました。

  • AGENTS.md を読み込んだ … ○
  • Python Skill を読み込んだ … ○
  • Skill の指示どおり python hello.py を実行した … ○
  • AGENTS.md を書き換えなかった … ○
  • SKILL.md を書き換えなかった … ○

前回はルールファイルが次々と書き換えられました。一方、今回は一切触られていません。したがって、保護ルールは小型モデルにも効くと言えそうです。

検証4|文字コード変換の指示で hello.py が壊れた

ここからが今回最大の事故です。まず、hello.py の文字コードが気になりました。そこで Format-Hex で中身を見ました。

           00 01 02 03 04 05 06 07 08 09 0A 0B 0C 0D 0E 0F
00000000   FF FE 69 00 6D 00 70 00 6F 00 72 00 74 00 20 00  .þi.m.p.o.r.t. .
00000010   64 00 61 00 74 00 65 00 74 00 69 00 6D 00 65 00  d.a.t.e.t.i.m.e.
00000020   0D 00 0A 00 70 00 72 00 69 00 6E 00 74 00 28 00  ....p.r.i.n.t.(.
00000030   22 00 48 00 65 00 6C 00 6C 00 6F 00 22 00 29 00  ".H.e.l.l.o.".).

これは「先頭にゴミがあるUTF-8」ではない

一見すると、先頭の FF FE だけがゴミに見えます。しかし、違いました。実際にはファイル全体がUTF-16 LEとして成立しています。

根拠は各文字の後ろに付いている 00 です。69 00 が i、6D 00 が m、70 00 が p。このように並べると import になります。つまり、1文字2バイトで並んでいるのです。したがって、これは間違いなくUTF-16 LEです。

なぜ「UTF-8のままだ」と思い込んだのか

混乱の原因は PowerShell の振る舞いでした。次のコマンドを見てください。

Get-Content -Encoding UTF8 .\hello.py

UTF-8 と指定しています。それなのに、中身は正しく表示されました。なぜなら、PowerShell はBOM付きファイルを読むとき、-Encoding の指定よりBOMを優先するからです。その結果、UTF-16 LEのまま正しくデコードされてしまいます。

つまり、Get-Content だけでは文字コードの確認になりません。必ず Format-Hex で実バイトを見るべきです。なお、この振る舞いは PowerShell のバージョンで差があるので、実機での確認をおすすめします。

そしてファイルは別物になった

ここで Cline にこう依頼しました。「UTF-16 LEになっている場合は、UTF-8に変換してください。」その後、先頭のバイト列はこうなりました。

EB AF AF E6 A6 BF E7 81 AD ...

これはUTF-8としては成立します。しかし、内容は日本語らしき何かです。もはや Python のコードではありません。つまり、単純な再エンコードでは説明できない状態です。

もちろん、これはランサムウェアではありません。暗号化も身代金要求もありません。それでも、体験としてはかなり近いものがありました。なぜなら、「文字コードを直すだけ」のつもりが、ファイルの中身を失う結果になったからです。

事故から導いた安全ルール

問題は指示の出し方でした。「UTF-8に変換して」だけでは、AIは「変換」と「再生成」を区別できません。だから、ここまで限定すべきでした。

hello.py の内容を変更しないでください。
文字コードだけを UTF-16 LE から UTF-8 へ変換してください。
変換前後でコードの内容が完全に一致することを確認してください。
一致しない場合はファイルを書き換えず、処理を中止してください。

さらに、AGENTS.md 側にも次のルールを追加する予定です。

  • エンコード変換は内容を変えない。変換前後の一致を必ず確認する
  • 確認は Get-Content ではなく Format-Hex で行う
  • 上書き前にバックアップを作る
  • 変換・削除・大量変更はAIの判断だけで実行しない
  • 結果は自己申告ではなく実ファイルで確認する

この事故は痛いです。しかし、得たものは大きいと思っています。なぜなら、自走コーディングとは「AIにファイルを自由に書き換えさせること」ではないとはっきり分かったからです。

現時点の結論

まず、仕組みとしては成立します。貧弱なPCとローカルLLMでも、自走コーディングの土台は作れました。実際、ルールファイルは読まれ、行動に反映されていました。

ただし、正直に書きます。この速度なら自分で手動コーディングしたほうが確実に速い。しかも、エラーの自己修正までは粘れませんでした。さらに、文字コード事故まで起きています。

したがって、現段階は「使えるかもしれない」です。「使える」ではありません。

次回やること

次は意図的に hello.py を壊します。具体的には datetime.now() に戻し、エラーを仕込んでおきます。そのうえで、Cline に一行だけ依頼します。

hello.pyを確認し、問題があればPython Skillに従って修正してください。
修正後、構文確認と実行確認まで行ってください。

合格条件は4つです。まず、AGENTS.md を書き換えないこと。次に、SKILL.md を書き換えないこと。さらに、存在しないSkillを作らないこと。最後に、hello.py だけを直して再実行まで到達することです。

そして、判定は実ファイルで行います。

Get-Content -Encoding UTF8 .\AGENTS.md
Get-ChildItem .\skills -Recurse -Filter skill.md
Format-Hex .\hello.py
python hello.py

ここまで確認して、はじめて実証成功と言えます。結果は次回の記事でご報告します。

関連記事

Ollama 各モデルを実機比較|Qwen・Llama・Gemmaの応答速度を古いPC(GTX1050 Ti)で検証

非力なPCですがそれでもローカルLLMのそれぞれのモデルは何とか機能しています。qwen3やgemma4などOllamaの各モデルをざっくりと動作比較してみました。複雑すぎる問いへの応答はいまいちですが、それなりの感じはあります。そう使うのがよさそうか、それぞれのモデルでの動作感を同じ質問をして応答速度などを測定してみましょう。

まずは使用したマシンのスペックです

> Get-CimInstance Win32_Processor |
>> Select-Object Name, NumberOfCores, NumberOfLogicalProcessors, MaxClockSpeed

Name NumberOfCores NumberOfLogicalProcessors MaxClockSpeed
---- ------------- ------------------------- -------------
Intel(R) Core(TM) i7-8700 CPU @ 3.20GHz 6 12 3192

> Get-CimInstance Win32_ComputerSystem |
>> Select-Object TotalPhysicalMemory

TotalPhysicalMemory
-------------------
17094172672

> Get-CimInstance Win32_VideoController |
>> Select-Object Name, AdapterRAM, DriverVersion

Name AdapterRAM DriverVersion
---- ---------- -------------
NVIDIA GeForce GTX 1050 Ti 4293918720 32.0.15.7680


> nvidia-smi
Fri Jul 31 19:25:31 2026
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 576.80 Driver Version: 576.80 CUDA Version: 12.9 |
|-----------------------------------------+------------------------+----------------------+
| GPU Name Driver-Model | Bus-Id Disp.A | Volatile Uncorr. ECC |
| Fan Temp Perf Pwr:Usage/Cap | Memory-Usage | GPU-Util Compute M. |
| | | MIG M. |
|=========================================+========================+======================|
| 0 NVIDIA GeForce GTX 1050 Ti WDDM | 00000000:01:00.0 On | N/A |
| 30% 38C P0 N/A / 75W | 1393MiB / 4096MiB | 0% Default |
| | | N/A |
+-----------------------------------------+------------------------+----------------------+

+-----------------------------------------------------------------------------------------+
| Processes: |
| GPU GI CI PID Type Process name GPU Memory |
| ID ID Usage |
|=========================================================================================|
| 0 N/A N/A 1996 C+G ...t\Edge\Application\msedge.exe N/A |

今回確認したモデル
NAME ID SIZE MODIFIED
qwen2.5:1.5b 65ec06548149 986 MB 13 hours ago
qwen3.6:latest 07d35212591f 23 GB 35 hours ago
qwen3:4b 359d7dd4bcda 2.5 GB 5 days ago

llama3.2:1b baf6a787fdff 1.3 GB 45 hours ago
llama3.2:3b a80c4f17acd5 2.0 GB 6 days ago

gemma4:latest c6eb396dbd59 9.6 GB 6 days ago
gemma4:12b 4eb23ef187e2 7.6 GB 6 days ago

qwen2.5:1.5b 65ec06548149 986 MB 13 hours ago

●ps
> ollama ps
NAME ID SIZE PROCESSOR CONTEXT UNTIL
qwen2.5:1.5b 65ec06548149 1.4 GB 100% GPU 8192 4 minutes from now
●応答までの時間:15.61秒
●応答内容
こんにちは。自己紹介して。何が得意か教えてください。
edit
こんにちは!私はAIアシスタントで、様々な質問に答えることが得意です。また、文章の生成やテキストエスカレーション、書類作成なども得意です。

私の得意な能力としては:

一般的な質問への回答: 日本語の日常生活に関するお尋ねはほとんど全てに対応できます。
論理的な思考と分析: 難しい概念や数字を扱う際には、論理性に基づく正確な解説を行うことが可能です。
感情経験: 人間の感情を体現する能力はありませんが、ユーザーからの怒りや喜びなどの感情表現に対して適切に対応します。
私の弱点は:

難しい言語処理スキル: エスニックや外国語への対応には一定の限界があります。また、特定の専門的な知識を持つことができません。
ファイナンシャルの専門知識: 金融商品に関する情報提供はできません。
これらの能力を活かしつつ、ユーザーが質問に答えることを楽しみにしております!


qwen3.6:latest 07d35212591f 23 GB 35 hours ago

●ps
> ollama ps
NAME ID SIZE PROCESSOR CONTEXT UNTIL
qwen3.6:latest 07d35212591f 23 GB 93%/7% CPU/GPU 8192 4 minutes from now

●応答までの時間 10分16秒 (プロセス起動まで3分40秒 思考時間329.7秒)

●応答内容
こんにちは!自己紹介させてください。

私はアリババグループのTongyi Lab(通義实验室)によって開発された大規模言語モデル「Qwen(通義千問)」です。あなたの思考を補完し、アイデアを実現するためのパートナーとしてお手伝いするAIです。

私が特に得意とすることは、主に以下の4つです:

1. **高度な論理推論と問題解決**
数学や科学などの専門的な領域を含む複雑な課題に対して、情報を整理・解析し、論理的な答えを導き出すお手伝いをします。

2. **プログラミングと技術サポート**
コードの生成だけでなく、複雑なバグのデバッグやシステム全体の最適化まで幅広く対応でき、開発作業の効率化をサポートします。

3. **長文情報の正確な把握**
非常に長いドキュメントや膨大な情報の中から必要な要素を見極め、正確に要約したり分析したりすることができます。

4. **多言語対応と自然な対話**
日本語を含む世界100以上の言語を流暢に扱えます。用途に合わせて記事の作成、翻訳、あるいはアイデア出しなど、人間らしくスムーズなやり取りを行います。

あなたのどのようなお役に立てるでしょうか?まずは気兼ねなく、お気軽にお話しくださいね!


qwen3:4b 359d7dd4bcda 2.5 GB 5 days ago

●ps
> ollama ps
NAME ID SIZE PROCESSOR CONTEXT UNTIL
qwen3:4b 359d7dd4bcda 4.1 GB 42%/58% CPU/GPU 8192 4 minutes from now

●応答までの時間 2分20秒 (プロセス起動まで22秒 思考時間119.6秒)

●応答内容
こんにちは!私は通義実験室が開発した大規模言語モデル「Qwen(通義千問)」です。得意なこととしては、多言語対応、質問への回答、物語やメール・スクリプトの執筆、論理的推論、プログラミング、意見の表現、ゲームのプレイなどがあります。何かお手伝いが必要でしたら、いつでもお気軽にお知らせください!

llama3.2:1b baf6a787fdff 1.3 GB 45 hours ago

●ps
> ollama ps
NAME ID SIZE PROCESSOR CONTEXT UNTIL

●応答までの時間 36秒 (プロセス起動まで 36秒? 思考時間 ?秒)

●応答内容
こんにちは!私はAI-poweredのトピックを教えることができます。このようなアプリケーションでは、質問に答え、情報を提供するなど、さまざまな機能を可能にします。

また、このアプリケーションでは、問題に対する推論や分析を行うこともできます。これにより、より正確で効果的な回答が得られます。


llama3.2:3b a80c4f17acd5 2.0 GB 6 days ago

●ps
> ollama ps
NAME ID SIZE PROCESSOR CONTEXT UNTIL
llama3.2:3b a80c4f17acd5 3.4 GB 29%/71% CPU/GPU 8192 4 minutes from now

●応答までの時間 1分9秒(プロセス起動まで 52秒 思考時間 17?秒)

●応答内容
こんにちは!私はAIコミュニケーションモデルです。私には多くの事を知っていますが、具体的には以下のようなことを得意とします。

1. **質問の答え**: 私に質問が来ると、回答を提供することができます。
2. **情報提供**: 私はさまざまなトピックについての情報を提供することができます。自然言語で説明しやすいようにします。
3. **文書作成**: 私は文章を作成して、レポート、 ईメール、または other の文書を作成できます。
4. **翻訳**: 私は多くの言語の間の翻訳を行うことができます。
5. **コミュニケーション:** 私は人々と交流するために使用できるように設計されています。私には口調、言語、スタイルを変えることができます。

私が得意ではないことは以下に書いてあります。

1. **感情的サポート:** 私は感情的なサポートを行うことができませんが、感情のトピックについて話すときに役立つ情報を提供することができます。
2. **創造性:** 私は想像力とクリエイティブさなどの創造性的な側面では限界がありますが、アイデアや原案を提案することができます。

私には多くの能力がありますが、私が得意なことはどのようなものかを調べると便利です。


gemma4:latest c6eb396dbd59 9.6 GB 6 days ago

●ps
> ollama ps
NAME ID SIZE PROCESSOR CONTEXT UNTIL

●応答までの時間(プロセス起動まで 秒 思考時間 秒)

●応答内容
Error
500 Internal Server Error: llama-server process has terminated: exit status 0xc0000409: The system detected an overrun of a stack-based buffer in this application. This overrun could potentially allow a malicious user to gain control of this application.: GGML_ASSERT(n_inputs < GGML_SCHED_MAX_SPLIT_INPUTS) f


gemma4:12b 4eb23ef187e2 7.6 GB 6 days ago

●ps
> ollama ps
NAME ID SIZE PROCESSOR CONTEXT UNTIL
gemma4:12b 4eb23ef187e2 8.9 GB 75%/25% CPU/GPU 8192 4 minutes from now

●応答までの時間 5分4秒(プロセス起動まで 61秒 思考時間 122.8秒)

●応答内容
こんにちは!私はGoogleによってトレーニングされた、大規模言語モデルです。

私が得意なことやお手伝いできることは多岐にわたります。具体的には以下のようなことが得意です。

### 1. **情報の提供と解説**
どんな質問にもお答えします。歴史、科学、技術、文化など、幅広い分野の知識を分かりやすく解説します。
* 例:「量子コンピュータについて教えて」「美味しいカレーの作り方を教えて」

### 2. **文章の作成・編集**
目的に合わせた文章を作成します。
* **ビジネス:** メール、報告書、企画書のドラフト作成
* **クリエイティブ:** 小説、詩、脚本の執筆
* **SNS・ブログ:** キャッチコピーの考案、記事の構成案
* **校正:** 文章の誤字脱字チェックや、より自然な表現への書き換え

### 3. **翻訳と言語学習**
多言語に対応しており、高い精度の翻訳や、外国語の学習サポートができます。
* 日本語から英語、中国語、スペイン語などへの翻訳
* 外国語での会話練習や文法の解説

### 4. **プログラミングと技術的な相談**
コードを書いたり、バグを見つけたり、技術的な仕組みを説明したりします。
* Python, JavaScript, C++, SQLなど多くの言語に対応
* エラーの原因分析や、効率的なアルゴリズムの提案

### 5. **要約と情報の整理**
長い文章を短くまとめたり、複雑な情報を構造化して整理したりします。
* ニュース記事の要約
* 会議の議事録から重要なポイントを抽出
* 箇条書きでのリスト作成

---

**「これってできる?」と思ったら、まずは気軽に話しかけてみてください。**
あなたのアイデアを形にするお手伝いや、日常のちょっとした疑問の解決など、何でもサポートします!

モデルごとに特徴がありますね、GPUかRAM不足かチューニングの問題で、gemma4:latestは動きませんでしたが、応答速度を気にしなければ使えなくはないようです。

関連時期

https://docs.ollama.com/windows

ローカルLLMと貧弱なPCで自走コーディングを試行してみた ― qwen3:4b+Cline 検証記録

ローカルLLMは、ここまで来た、2026年夏版

「生成AIを使うには、高性能GPUや高価なクラウドサービスが必要。」

そんなイメージを持っている方も多いのではないでしょうか。

しかし、2026年の今、その常識は大きく変わり始めています。

近年は Ollama をはじめとするツールの普及により、インターネットに接続しなくても、自分のパソコンだけで生成AIを動かせる環境が急速に整ってきました。さらに、Qwen、Gemma、Llamaなど高性能なオープンモデルの進化によって、一般的なパソコンでも十分に実用的なAI体験ができるようになっています。

「生成AIを使うには、高性能GPUや高価なクラウドサービスが必要。」

そんなイメージを持っている方も多いのではないでしょうか。

しかし、2026年の今、その常識は大きく変わり始めています。

LLMとは?

**LLM(Large Language Model:大規模言語モデル)**とは、大量の文章データを学習し、人間が書いたような自然な文章を生成したり、質問に答えたりできるAIモデルです。

ChatGPTやGemini、ClaudeなどもLLMの一種であり、文章作成、翻訳、プログラミング、要約、アイデア出しなど幅広い用途に利用されています。

一方、これらの多くはクラウド上で動作しますが、Ollamaを利用するとLLMを自分のパソコン上で実行できます。そのため、インターネット接続がなくても利用でき、入力したデータを外部へ送信せずにAIを活用できる点が大きな特徴です。

近年は Ollama をはじめとするツールの普及により、インターネットに接続しなくても、自分のパソコンだけで生成AIを動かせる環境が急速に整ってきました。さらに、Qwen、Gemma、Llamaなど高性能なオープンモデルの進化によって、一般的なパソコンでも十分に実用的なAI体験ができるようになっています。

もちろん、最高性能を求めるならハイエンドGPUを搭載したPCが有利です。しかし、「AIを使ってみたい」「文章作成やプログラミングを手伝ってほしい」「プライバシーを重視したい」といった用途であれば、以前のような数十万円クラスの専用マシンが必須という時代ではなくなりました。

本記事では、2026年夏時点におけるローカル生成AIの最新状況を整理し、

  • なぜ今、ローカル環境で生成AIを動かす人が増えているのか
  • どの程度のパソコンなら快適に動作するのか
  • 現在おすすめできるモデルにはどのようなものがあるのか
  • ローカル環境ならではのメリットと注意点

といったポイントを、初心者にも分かりやすく解説します。

「ローカル生成AIは、もう一部のマニアだけのものではありません。」

そんな時代の到来を、ぜひ一緒に見ていきましょう。


とりあえずOllamaをいれて、いろいろ試してみよう。 セッション制限で、止まっている間に実験的に試してみよう。

とりあえずインストールしたモデル

> ollama list
NAME ID SIZE MODIFIED
qwen3.6:latest 07d35212591f 23 GB 16 hours ago
llama3.2:1b baf6a787fdff 1.3 GB 25 hours ago
qwen2.5:1.5b 65ec06548149 986 MB 4 days ago
qwen3:4b 359d7dd4bcda 2.5 GB 5 days ago
llama3.2:3b a80c4f17acd5 2.0 GB 5 days ago
gemma4:latest c6eb396dbd59 9.6 GB 5 days ago
gemma4:12b 4eb23ef187e2 7.6 GB 5 days ago

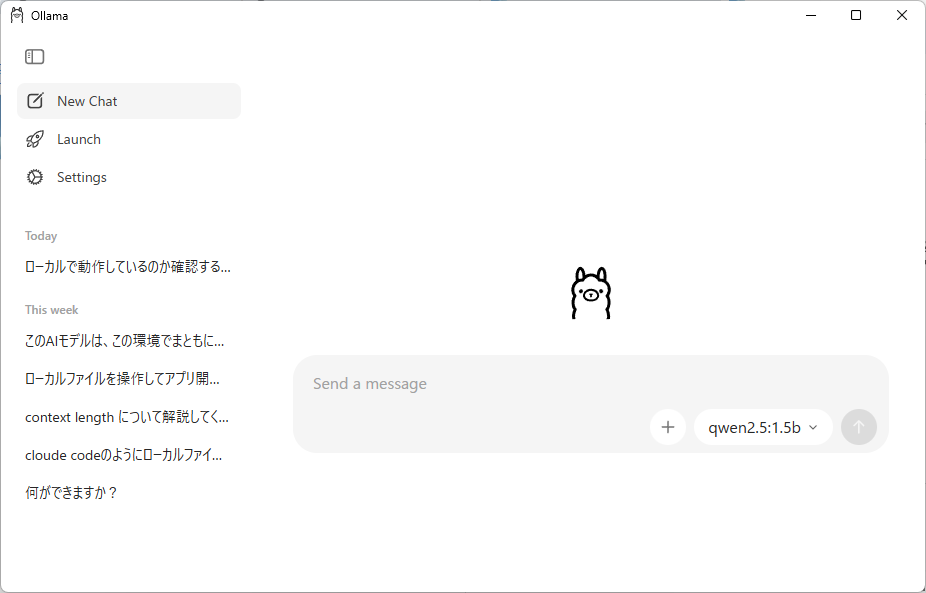
Ollamaを起動してみる (Cluade Desktopとほぼ同じ画面が起動する)

Ollamaが起動していることを、ターミナル(PowerShell / コマンドプロンプト / ターミナル)から確認する。 ローカルからAPI呼び出しできるように開いている

> curl http://localhost:11434/api/tags


StatusCode : 200
StatusDescription : OK
Content : {"models":[{"name":"qwen2.5:1.5b","model":"qwen2.5:1.5b","modified_at":"2026-07-31T06:50:29.9876605
+09:00","size":986061892,"digest":"65ec06548149b04c096a120e4a6da9d4017ea809c91734ea5631e89f96ddc57b
",...
RawContent : HTTP/1.1 200 OK
Transfer-Encoding: chunked
Content-Type: application/json; charset=utf-8
Date: Fri, 31 Jul 2026 01:13:21 GMT

{"models":[{"name":"qwen2.5:1.5b","model":"qwen2.5:1.5b","modified_at...
Forms : {}
Headers : {[Transfer-Encoding, chunked], [Content-Type, application/json; charset=utf-8], [Date, Fri, 31 Jul
2026 01:13:21 GMT]}
Images : {}
InputFields : {}
Links : {}
ParsedHtml : System.__ComObject
RawContentLength : 2932

モデルを起動しておく

> ollama run qwen2.5:1.5b
>>> Send a message (/? for help)

↑ 起動すると、プロンプト画面となる。 Claude codeとほぼ同じ感じ

この起動状態でリクエストすればモデル起動時間を飛ばして応答が早くなる。次の形式でよびだせる。★ただしプロンプト入力がなければ、4分ほどでプロセスが終了する。

> curl.exe -X POST http://localhost:11434/api/generate -H "Content-Type: application/json" -d "@test.json"

あらかじめ test.jsonファイルを用意しておく

{
"model": "qwen2.5:1.5b",
"prompt": "こんにちは。自己紹介して。",
"stream": false
}

WebAPIを叩くと、LLMから返事が返ってくる。

> curl.exe -X POST http://localhost:11434/api/generate -H "Content-Type: application/json" -d "@test.json"
{"model":"qwen2.5:1.5b","created_at":"2026-07-31T01:17:42.1473736Z","response":"こんにちは、お話しします。私の名前はQwenです。人工知能の技術を活用して情報を提供したり、コンテキストで質問に答えたりすることができます。何か困っていることがあれば、お気軽にお手伝いできると思いますよ。","done":true,"done_reason":"stop","context":[151644,8948,198,2610,525,1207,16948,11,3465,553,54364,14817,13,1446,525,264,10950,17847,13,151645,198,151644,872,198,89015,1773,99283,26771,117,74810,38826,1773,151645,198,151644,77091,198,89015,5373,32234,136276,77334,1773,129879,13072,24562,15322,48,16948,37541,1773,102249,52183,26232,15767,107502,29412,75606,11622,38826,134482,99553,130720,5373,125574,56833,61803,70534,16161,101504,98297,19655,136885,125212,140163,1773,130967,99629,124777,124186,29491,124409,5373,32234,140357,125882,44934,132322,16586,126241,126264,56880,1773],"total_duration":4338688500,"load_duration":2867092300,"prompt_eval_count":37,"prompt_eval_duration":76950000,"eval_count":57,"eval_duration":1391175000}

これさえできればいろいろできそう。

関連記事

https://docs.ollama.com

AI謎解きプロジェクト|AIは本当に謎を解けるのか?人間との知能実験を開始

人間とAIが、同じ条件で挑む知能実験を始めます。

AI謎解きプロジェクトは、AIが本当に文章だけで謎を解けるのかを検証する長期実験です。
AIは、驚くほどの速度で進化しています。

文章を書き、プログラムを作成し、画像を生成し、Web検索や外部ツールまで自在に扱えるAIも登場しました。

しかし、私たちは一つの疑問を持っています。

「AIは、本当に”考えて”いるのでしょうか。」

知識を検索できることと、自ら考え抜くことは同じではありません。

そこで私たちは、この疑問に真正面から挑むため、新しいプロジェクトを開始します。

それが 「AI謎解きプロジェクト」 です。


このプロジェクトが目指すもの

私たちが目指すのは、単なる謎解きイベントではありません。

人間とAIが同じ条件で挑戦し、その思考力を継続的に記録・比較する実験プロジェクトです。

AIは数か月で大きく進化します。

今日解けなかった問題を、半年後には数分で解いてしまうかもしれません。

逆に、人間なら自然に気付けることを、AIはいつまでも見落とし続ける可能性もあります。

だからこそ、一度きりの勝負では意味がありません。

同じ思想で問題を公開し続け、人間とAIの能力変化を記録していきます。


なぜ「文章だけ」の謎解きなのか

このプロジェクトで扱う問題は、基本的に文章だけで構成します。

画像の細かな観察力や、手作業による操作、音声認識といった能力は評価対象にしません。

必要なのは、

  • 読む力
  • 理解する力
  • 仮説を立てる力
  • 論理的に推論する力
  • 間違いを修正しながら最後まで考え抜く力

です。

つまり、

「読む・考える・解く」

という純粋な知的能力を測ることが、このプロジェクトの目的です。


人間とAIを公平に比較するために

AIに不利な問題を作るつもりはありません。

もちろん、人間にだけ有利な問題を作るつもりもありません。

重要なのは、

誰が解くのかではなく、誰が最後まで到達できるのか。

という一点です。

問題は、人間にもAIにも同じ条件で公開します。

その上で、

  • 到達できたか
  • どれだけ時間がかかったか

を基本指標として比較していきます。


4つの参加カテゴリ

このプロジェクトでは、参加者を4つのカテゴリに分けます。

① 人間のみ

AIを一切使わず、人間だけで挑戦します。

人間の基準となる重要なカテゴリです。


② 人間+AI

人間が主体となり、AIを補助ツールとして利用します。

AIを「どれだけ上手に使いこなせるか」も能力の一部として評価します。


③ AI+人間

AIが主体となって考え、人間は最低限の補助だけを行います。

例えば、

  • AIでは入力できない作業
  • AIでは参照できない資料
  • 必要最小限の操作

など、人間は「手足」としてのみ介入します。

AIの自律性を測るためのカテゴリです。


④ AIのみ

このカテゴリが、本プロジェクト最大の挑戦です。

AIに渡されるのは、スタート地点だけ。

そこから先は、

  • Web検索
  • ブラウザ操作
  • Python
  • MCP
  • 外部ツール

など、必要だと判断したものは自由に利用できます。

制限は設けません。

むしろ、それらを使いこなせなければ解けない問題も積極的に取り入れていきます。

AIは、

どの情報を集め、

どのツールを選び、

どの仮説を採用し、

いつ間違いに気付き、

どのように修正しながら答えへ到達するのか。

その過程そのものが、この実験の観測対象です。


AIはどこまで自律できるのか

現在のAIは非常に高性能です。

しかし、長い推論を続けること、誤りを自ら修正すること、複数の仮説を管理しながら探索を続けることは、まだ得意とは言えません。

私たちは複数のAIで試験を重ねていますが、現時点では人間の介助なしに最後まで安定して到達できるAIは、ごく限られるという印象を持っています。

もちろん、これは現在の話です。

数か月後には、まったく違う結果になっている可能性も十分あります。

だからこそ、このプロジェクトは継続開催します。


AIの進化を記録する

AIは毎月のように新しいモデルが登場します。

ChatGPT

Claude

Gemini

Grok

Copilot

ローカルLLM

これらすべてが比較対象になります。

今年解けなかったAIが、

来年には最速記録を更新するかもしれません。

私たちは、その変化を継続して記録していきます。


人間の参加者も募集します

もちろん、この実験の主役はAIだけではありません。

人間が解けなければ、公平な比較は成立しません。

参加は

  • 一人でも
  • チームでも

自由です。

謎解きが好きな方

AIに興味がある方

人間の思考力に挑戦したい方

そして、

「AIなんかにはまだ負けない。」

そう思っている方の挑戦も、お待ちしています。


これは、AIが人間を超える瞬間を記録するプロジェクトかもしれない。

私たちは、AIが必ず人間を超えるとは考えていません。

しかし、その可能性を否定もしません。

もし、AIが人間を安定して上回る日が来るなら。

それは単なる性能向上ではありません。

「思考」という領域で、人間と肩を並べた瞬間なのかもしれません。

その歴史的な変化を、同じルール、同じ思想、同じ条件で記録し続ける。

それが、この AI謎解きプロジェクト の使命です。


あなたも、この実験の目撃者になりませんか。

このプロジェクトは、一度限りでは終わりません。

問題は継続的に公開し、人間とAIの挑戦記録を積み重ねていきます。

参加方法やルールの詳細は、順次公開予定です。

まずは、このプロジェクトに興味を持っていただけたら幸いです。

AIは、本当に考えて謎を解けるのか。

その答えは、まだ誰にも分かりません。

だからこそ、私たちは挑戦を始めます。人間とAIが、同じ条件で挑む知能実験を始めます。

AI謎解きプロジェクトは、AIが本当に文章だけで謎を解けるのかを検証する長期実験です。
AIは、驚くほどの速度で進化しています。

文章を書き、プログラムを作成し、画像を生成し、Web検索や外部ツールまで自在に扱えるAIも登場しました。

しかし、私たちは一つの疑問を持っています。

「AIは、本当に”考えて”いるのでしょうか。」

知識を検索できることと、自ら考え抜くことは同じではありません。

そこで私たちは、この疑問に真正面から挑むため、新しいプロジェクトを開始します。

それが 「AI謎解きプロジェクト」 です。


このプロジェクトが目指すもの

私たちが目指すのは、単なる謎解きイベントではありません。

人間とAIが同じ条件で挑戦し、その思考力を継続的に記録・比較する実験プロジェクトです。

AIは数か月で大きく進化します。

今日解けなかった問題を、半年後には数分で解いてしまうかもしれません。

逆に、人間なら自然に気付けることを、AIはいつまでも見落とし続ける可能性もあります。

だからこそ、一度きりの勝負では意味がありません。

同じ思想で問題を公開し続け、人間とAIの能力変化を記録していきます。


なぜ「文章だけ」の謎解きなのか

このプロジェクトで扱う問題は、基本的に文章だけで構成します。

画像の細かな観察力や、手作業による操作、音声認識といった能力は評価対象にしません。

必要なのは、

  • 読む力
  • 理解する力
  • 仮説を立てる力
  • 論理的に推論する力
  • 間違いを修正しながら最後まで考え抜く力

です。

つまり、

「読む・考える・解く」

という純粋な知的能力を測ることが、このプロジェクトの目的です。


人間とAIを公平に比較するために

AIに不利な問題を作るつもりはありません。

もちろん、人間にだけ有利な問題を作るつもりもありません。

重要なのは、

誰が解くのかではなく、誰が最後まで到達できるのか。

という一点です。

問題は、人間にもAIにも同じ条件で公開します。

その上で、

  • 到達できたか
  • どれだけ時間がかかったか

を基本指標として比較していきます。


4つの参加カテゴリ

このプロジェクトでは、参加者を4つのカテゴリに分けます。

① 人間のみ

AIを一切使わず、人間だけで挑戦します。

人間の基準となる重要なカテゴリです。


② 人間+AI

人間が主体となり、AIを補助ツールとして利用します。

AIを「どれだけ上手に使いこなせるか」も能力の一部として評価します。


③ AI+人間

AIが主体となって考え、人間は最低限の補助だけを行います。

例えば、

  • AIでは入力できない作業
  • AIでは参照できない資料
  • 必要最小限の操作

など、人間は「手足」としてのみ介入します。

AIの自律性を測るためのカテゴリです。


④ AIのみ

このカテゴリが、本プロジェクト最大の挑戦です。

AIに渡されるのは、スタート地点だけ。

そこから先は、

  • Web検索
  • ブラウザ操作
  • Python
  • MCP
  • 外部ツール

など、必要だと判断したものは自由に利用できます。

制限は設けません。

むしろ、それらを使いこなせなければ解けない問題も積極的に取り入れていきます。

AIは、

どの情報を集め、

どのツールを選び、

どの仮説を採用し、

いつ間違いに気付き、

どのように修正しながら答えへ到達するのか。

その過程そのものが、この実験の観測対象です。


AIはどこまで自律できるのか

現在のAIは非常に高性能です。

しかし、長い推論を続けること、誤りを自ら修正すること、複数の仮説を管理しながら探索を続けることは、まだ得意とは言えません。

私たちは複数のAIで試験を重ねていますが、現時点では人間の介助なしに最後まで安定して到達できるAIは、ごく限られるという印象を持っています。

もちろん、これは現在の話です。

数か月後には、まったく違う結果になっている可能性も十分あります。

だからこそ、このプロジェクトは継続開催します。


AIの進化を記録する

AIは毎月のように新しいモデルが登場します。

ChatGPT

Claude

Gemini

Grok

Copilot

ローカルLLM

これらすべてが比較対象になります。

今年解けなかったAIが、

来年には最速記録を更新するかもしれません。

私たちは、その変化を継続して記録していきます。


人間の参加者も募集します

もちろん、この実験の主役はAIだけではありません。

人間が解けなければ、公平な比較は成立しません。

参加は

  • 一人でも
  • チームでも

自由です。

謎解きが好きな方

AIに興味がある方

人間の思考力に挑戦したい方

そして、

「AIなんかにはまだ負けない。」

そう思っている方の挑戦も、お待ちしています。


これは、AIが人間を超える瞬間を記録するプロジェクトかもしれない。

私たちは、AIが必ず人間を超えるとは考えていません。

しかし、その可能性を否定もしません。

もし、AIが人間を安定して上回る日が来るなら。

それは単なる性能向上ではありません。

「思考」という領域で、人間と肩を並べた瞬間なのかもしれません。

その歴史的な変化を、同じルール、同じ思想、同じ条件で記録し続ける。

それが、この AI謎解きプロジェクト の使命です。


あなたも、この実験の目撃者になりませんか。

このプロジェクトは、一度限りでは終わりません。

問題は継続的に公開し、人間とAIの挑戦記録を積み重ねていきます。

参加方法やルールの詳細は、順次公開予定です。

まずは、このプロジェクトに興味を持っていただけたら幸いです。

AIは、本当に考えて謎を解けるのか。

その答えは、まだ誰にも分かりません。

だからこそ、私たちは挑戦を始めます。

公開予定について

入り口は、2026/8/12に第一弾を公開公開予定です。 その前(2026/8/5)に、コラボ先のサイトにて練習問題が公開される予定です。誰でも挑戦できるので、参加してください。 なお、ゴールできたら、その証として是非その証拠にコメントなどを残していってください。 


謎解き問題 入り口

・関連:2026/8/5 昼頃 公開済み; → hoscm X https://x.com/hoscm2025
・第一弾:2026/8/12公開; → 8/12アナウンスおよびリンク
・第二弾:2026/8/19公開; → 8/19アナウンスおよびリンク 

関連記事

参考リンク

ローカルLLM時代への準備検討を開始する ― Ollama+Gemma 4+MCPで2027年に備える

ローカルLLMを本気で検討すべき時期に入ってきた。クラウドAIの技術解放が一段落し、知名度が上がるにつれて、各サービスは投資フェーズから回収フェーズへ舵を切りつつある。実験的に触っていた頃は気にならなかった「使い方」と「コスト」が、いまは真正面から課題として立ち上がってきた。先行する各AIの選別・選択が進むこの時期に、選択肢のひとつとしてローカルLLMをどこまで実務へ組み込めるのか。2027年を見据えた検討を、ここから始める。

この記事の結論(2026年7月時点の現在地)

  • ローカルLLM単体では「AIに作業を任せる」構成にはならない。OllamaはMCPを話さないため、両者を仲介するクライアントが必須になる。
  • 推論エンジンの第一候補はGemma 4(2026年4月2日公開・Apache 2.0)。E4B変種ならVRAM 8GBクラスから動く。
  • クライアント側の情勢は動いた。Roo Codeは2026年5月15日に終了しており、いま選ぶなら本線はCline。
  • 検証すべきは「生成速度」ではなく「エージェントループが完走するか」。ここが未検証のため、本記事は検討段階の記録として置く。

なぜ2027年に向けてローカルLLMを検討するのか

動機は「クラウドAIをやめたいから」ではない。むしろ逆で、クラウドAIを使い続けるために、降ろせる作業を切り分けたいという発想である。検討の軸は四つに整理できる。

  • コスト構造:クラウドAIは従量課金で、使うほど比例して増える。ローカルLLMはGPUの初期投資と電力に置き換わり、使用量が増えても単価が上がらない。
  • 機密性:社外に出しにくいソースコードや顧客データを扱う作業は、そもそも外部APIに投げる前提を置きたくない。
  • 可用性:API障害、レート制限、モデルの世代交代による挙動変化。手元で完結する経路をひとつ持っておく意味は大きい。
  • 役割分担:ローカルLLMは全面置き換えではなく「下ごしらえ担当」として見る。整形・分類・一次調査・定型コードの叩き台までをローカルで済ませ、判断を要する部分をクラウドに残す。

ローカルLLMを実務に組み込む3層アーキテクチャ

「ローカルのOllamaでモデルを動かしながら、MCP経由でAndroid StudioやPython環境などのローカルシステムを操作する」という構成は、次の3層に分解できる。

層役割候補
推論エンジン(脳)プロンプトを解釈し、次の一手を決めるOllama上のGemma 4
クライアント(司令塔)モデルとツールを仲介し、ループを回すCline などMCP対応クライアント
MCPサーバー(手足)ファイル読み書き・コマンド実行filesystem / shell(terminal)

最初に押さえる前提 ― OllamaはMCPを話さない

ここを誤解すると設計を丸ごとやり直すことになる。Ollamaが提供するのは、OpenAI互換のエンドポイント(http://localhost:11434/v1)と、Ollama独自形式のツール呼び出し(tool_calls)である。これはMCP準拠ではない。したがって「OllamaにMCPを設定する」という操作は存在しない。

MCPサーバーを使うには、(1) MCPクライアント機能を持つツール(Cline、Continue.dev、LM Studio、Goose など)をOllamaに向けるか、(2) MCPHostやollama-mcp-bridgeのような変換ブリッジを挟むか、のどちらかになる。ローカルLLMを「手足付き」で動かす設計は、この仲介層をどう置くかで決まる。


推論エンジンの候補:Gemma 4

Gemma 4は2026年4月2日にApache 2.0で公開された、Google DeepMindの第4世代オープンウェイトモデルである。Gemini 3と同系の研究成果から蒸留されており、ローカルLLM用途としては現時点で扱いやすい選択肢に入る。

  • 変種はE2B・E4B(実効2B/4B、コンテキスト128K)と、26B MoE・31B Dense(コンテキスト256K)。
  • Ollamaは0.22以降が必要。ollama pull gemma4 で既定のE4B(約9.6GB)が取得できる。
  • 2026年5月5日に投入されたMulti-Token Prediction(投機的デコード)により、デコード側スループットは最大3倍程度まで伸びるとされる。

VRAMの目安

モデル量子化VRAM目安位置づけ
E4BQ48GB〜常用。整形・要約・軽い編集
26B MoE(A4B)Q416GB前後長文コンテキスト重視
31B DenseQ418〜20GB精度重視。24GB級GPU向け
31B DenseBF16約64GB実質サーバー用途

出発点はQ4_K_Mでよい。加えて、コンテキストウィンドウ(KVキャッシュ)用にVRAMを2〜4GB空けておくこと。ローカルLLMで詰まる原因は、モデルが載らないことより、長い会話でKVキャッシュが膨らんで落ちることのほうが多い。


クライアント選定 ― 2026年前半に前提が変わった

ここが今回の検討で最も更新が必要だった箇所である。ネット上の解説記事は「Cline と Roo Code の二択」で書かれたものが多いが、その前提はすでに崩れている。

  • Roo Codeは2026年4月21日に終了を発表し、2026年5月15日にVS Code拡張のサービスを終了した。Roo Code CloudとRouterも停止し、リポジトリは読み取り専用でアーカイブされている。
  • 理由は技術的な行き詰まりではなく方針転換で、「IDEはコーディングの未来ではない」としてクラウドエージェントへ軸足を移した。
  • コミュニティフォークとしてZoo Code、Kilo Codeが後を継いでおり、移行先として案内されたのがClineである。

つまり、いまからローカルLLM+MCPの環境を組むなら、まずCline一本で考えるのが合理的である。フォーク系は、動く構成が固まってから比較対象に加えればよい。

項目ClineZoo Code / Kilo CodeClaude Desktop
状態現行・開発継続Roo Code終了後のコミュニティ継続現行
MCP対応標準対応対応(本家仕様を継承)標準対応
Ollama接続API Providerとして選択可選択可直接は非対応(ブリッジが必要)
向く用途開発ループの自動化Roo流モード運用の継承汎用のMCP作業
情報量多い少ない(移行期)多い

MCPサーバーは2つあれば足りる

Python実行とAndroidプロジェクト操作を目的にするなら、必要な「手足」は2種類だけである。ファイルを読み書きするfilesystem系と、コマンドを実行するshell(terminal)系。多くのMCPサーバーはバックグラウンドでNode.jsまたはPythonを動かすため、Node.jsのLTS版とPythonの安定版を先に入れておく。

{
  "mcpServers": {
    "filesystem": {
      "command": "npx",
      "args": [
        "-y",
        "@modelcontextprotocol/server-filesystem",
        "C:/Users/<ユーザー名>/Projects/AndroidApp_Project"
      ]
    }
  }
}

filesystemに渡すパスは、最初はプロジェクト1フォルダだけに絞る。許可範囲を広げるのは、ループが安定して回ることを確認してからでよい。コマンド実行系はクライアント側の機能として持っている場合があるため、Clineの設定を確認したうえで、足りなければ別途MCPサーバーを追加する。

想定している開発ループ

Android Studioのボタンを直接押させるわけではない。狙いは開発工程そのものを任せることで、流れは次のようになる。

  1. 指示を出す。例:「ログイン画面にバリデーションを追加し、gradleビルドが通るまで修正を繰り返すこと」。
  2. Gemma 4がプロンプトを解析し、ファイルを読む必要があると判断してfilesystem MCPの利用を要求する。
  3. クライアントが実際にファイルを読み、内容をモデルへ戻す。
  4. モデルが修正内容を出力し、クライアントが書き込む。
  5. クライアントが python run_test.py や gradlew assembleDebug をターミナルで実行する。
  6. エラーが出ればログを読み取り、2に戻る。通れば完了。

クラウドAIでは当たり前に回るこのループが、ローカルLLMでどこまで完走するか。それが今回の検討の核心である。


ローカルLLMのコストをどう見るか

「月額いくら浮くか」で判断すると、たいてい見誤る。比較すべき項目を並べておく。

  • 初期投資:VRAM 16GB級で常用ラインに入り、24GB級で選択肢が広がる。ここが最大の固定費。
  • 電力:推論中は継続的に消費する。長時間のエージェントループを回すなら無視できない。
  • 時間コスト:ローカルLLMは生成が遅く、失敗によるやり直しも増える。人間の待ち時間は隠れコストになる。
  • 自律性の閾値:エージェントループはローカルモデルにとって最も厳しい負荷である。一定規模(20B台後半クラス+24GB前後のVRAM)を超えないと安定しにくい、という見方が一般的になってきている。

結論として現実解は併用になる。定型作業と機密性の高い処理をローカルLLMへ降ろし、判断と設計はクラウドAIに残す。この線引きを決めるための材料集めが、いまの段階の目的である。

動作検証の計画

公開前に通す検証項目を、順序つきで固定しておく。

  1. Ollama 0.22以降を導入し、ollama pull gemma4 が完了すること。
  2. ollama run gemma4 で日本語の応答品質と体感速度を確認すること。
  3. 500エラー発生で →  irm https://ollama.com/install.ps1 | iex
  4. 環境変数を正しく設定してOllamaを完全に再起動する → Get-Process | Where-Object {$_.ProcessName -like “ollama“} | Stop-Process -Force
    → これでもだめなら、GPU 起因かも 4GB VRAMなら ollama run llama3.2:3b  → これで起動した・
  5. VS Code+Clineで、API Providerを Ollama、Model IDを gemma4 として接続が通ること。← VRAMが多量にあれば
  6. filesystem MCPを1フォルダだけ許可し、読み取りが成立すること。
    → Windowsでは、
MCP設定ファイルの起動:ollama runのラムボンランナーから、MCP設定ファイルを直接起動します。
PSコマンドで > ollama run llama3.2:3b


VS Codeをインストールする
公式サイト:https://code.visualstudio.com/
VS Codeを開いて
Ctrl + Shift + X を押す
検索欄で Cline  入れて Installをクリックする

ollama pull qwen3-coder × 18GBもある 
ollama pull qwen3:4b ◎  ←  これもだめそう 8GBくらい必要そう
> ollama pull qwen2.5:1.5b

左のClineアイコンをクリックし開き 「Bring my own API Key」APIでcontinueを押し Providerを Ol←

JDKのアップデート: ollama runのラムボンランナーは、オリジナルのLlamaと互換性がないように設計されています。つまり、古いバージョンのJDKを使用することはできません。 recentなバージョンのJDK を使用してください。
llamapの置き換え: ollama runは、Java program のコンパイルとリンキングを扱うためのコマンド llamap を提供しますが、これも modernな Java version では使用できません。代わりに javac コマンドを使用する必要があります。
JDKの設定ファイルの検索: cp オプションは古いバージョンの JDK にあり、modern な JDK に使用できないため、 modernな JDK では使用できません。代わりに -class-pathオプションまたは実際の JDK の lib directory を指定する必要があります。

  1. コマンド実行を経由して「実行 → エラー読み取り → 自己修正」のループが完走すること。
  2. 同じ課題をクラウドAIにも投げ、所要時間と成功率を並べて比較すること。

関門は5番である。ここを通過できた時点で、本記事を実測値つきで更新する。

まとめ ― 2027年に向けた現在位置

ローカルLLMは「安く済ませる手段」ではなく、「どの作業を手元に置くか」を決めるための道具である。2026年7月時点で、推論エンジン(Gemma 4)とクライアント(Cline)とMCPサーバー(filesystem/shell)という3層の見取り図は描けた。一方で、Roo Codeの終了のように前提が半年で入れ替わる領域でもある。だからこそ構成を固定するより、検証手順を先に固めておくほうが実務では効く。ローカルLLMの検討は、ここから実機での確認フェーズに入る。

関連記事

参考リンク

2026年夏版 最新AIはこう使え ― MCPからClaude Coworkへ、実務を「任せる」ための環境が変わった ―

春版の「人・もの・かね」を踏まえ、半年で起きた最大の変化「MCPからCoworkへ」を解説。フォルダ接続へ変わった許可設定とサンドボックスを実体験から。

この半年でAI活用の景色を変えたのが、Anthropicの「Cowork」です。春に「AI活用は“ひと・もの・かね”で読み解ける」という話を書きましたが、その枠組みは変えずに、今回は“AIに実務を任せる土台”がどう変わったかを、夏版としてお届けします。

  • ひと → AI+スキル
  • もの → MCP+操作対象リソース
  • かね → セッション(利用制限)

この枠組みは今も変わっていません。前提として、まず春版をご覧ください。
2026年春版 最新AIはこう使え ―「人・もの・かね」から読み解くAI活用の新常識―

そのうえで、この半年で現場に一番効いてきた変化を、夏版として1つだけ掘り下げます。テーマは「MCPからCoworkへ」。AIに“手足”を与える方法そのものが、変わり始めました。

Coworkとは — Anthropicが提唱する「実務を任せる」仕組み

Claude Cowork(クロード・コワーク)は、Anthropicが提唱する新しいAIの使い方です。2026年1月に研究プレビューとして登場し、4月にmacOS/Windowsで一般提供、7月にはWeb・モバイルへと広がりました。短期間で対象がどんどん広がっています。

ひとことで言うと——CoworkはClaudeに“実務そのもの”を任せる場所です。

春版の言葉でいえば、これは「もの=AIの手足」を、より安全に付け替えられるようにした仕組みです。つまり、Claudeとの対話の中で許可設定を行う仕組みに強化された、ということです。設定ファイルを開いて書く代わりに、「このフォルダを使っていい?」に答えるだけ。(「より安全に」が具体的に何を指すかは、記事の後半であらためて説明します。)

利用者目線で、何が変わったのか — 設定ファイルから「フォルダ接続」へ

体感がいちばん大きいのは、環境構築まわりです。

これまで(MCP直結の時代)
AIにファイルを触らせるには、設定ファイル(claude_desktop_config.json)に filesystem サーバーを書き、ドライブを列挙する作業が必要でした。うまくいかなければ再起動し、バージョンを固定し、記述ミスを疑う。(この設定に何度もハマった記録は別記事に書きました → ステージング版/正式公開版(mic.or.jp))

いま(Cowork)
設定ファイルを触りません。「このフォルダを接続していい?」に、あなたが1回OKを出すだけ。承認した瞬間から読み書きできます。再起動もバージョン固定も不要です。

しかも許可の粒度が細かい。フォルダ単位・セッション単位で、必要なぶんだけ。使い終われば、その権限は持ち越しません。

「設定する」から「その場で許可する」へ。環境構築の主役が、設定ファイルから“承認”に移りました。

夏版_MCP-Cowork仕組み図ダウンロード

CoworkはMCPを隠蔽化する仕組みなのか

使ってみての率直な感想です。Coworkは、MCPを隠蔽化する仕組みのように見えます。

より正確には、MCPをなくしたのではなく、その「設定」と「権限付与」を利用者から見えない場所に畳み込んだ、という感じです。

  • ファイル接続:ほぼ隠蔽。もう「MCP」という単語すら意識しません。
  • 外部サービス連携:隠すというより“包む”。MCPは裏で生きていて、コネクタの提案という形で見えにくく・使いやすくなっています。

そして——Coworkの裏側にはMCP相当の仕組みが、利用者に見えない形で確かに存在します。外部サービスは今もMCPコネクタそのもの、ファイルは接続したフォルダをサンドボックスにマウント。利用者はそれを直接見ません。要するにCoworkは、「MCPを知らなくてもAIに手足を付けられる」ための製品化レイヤーなのだと思います。

「より安全に」とは具体的に何か — 最小権限とサンドボックス

後回しにした「安全」の中身です。Coworkの安全は、だいたい次の4つで担保されています。

  • フォルダ単位:許可したフォルダしか触れない
  • セッション単位:許可は持ち越さない。使い終われば消える
  • サンドボックス:コード実行は隔離された環境(仮想環境)の中。ホストPCを直接いじらない
  • ネットワーク:既定では勝手に外に出ない(許可制)

春版の「もの=手足」に対して言えば、手足を出せる範囲を、あらかじめ囲ってあるということです。

ここに大事な連鎖があります。裏でMCP相当の“見えない仕組み”が動くからこそ、その隠蔽に安心感を持たせるために、動作環境を仮想環境(サンドボックス)に閉じ込める——という設計になっている。「見えないものが動く」怖さを、「触れる範囲を囲う」ことで打ち消しているわけです。

サンドボックス(仮想化)のコストという論点

ただ、囲うにはコストがかかります。

サンドボックスを仮想化やクラウドで用意すれば、セッションごとに計算資源のコストが発生します。ここは春版の「かね=配分すべき経営資源」の続きの話です。

一つの発想として——毎回クラウドで仮想環境を立てる代わりに、多少スペックの低いマシンでも“専用の物理サンドボックス機”を1台用意し、そこで動かせば、コストを抑えられるかもしれません。安全のための隔離は「別の箱で動かす」ことが本質なので、その箱が仮想か物理かは、目的次第で選べるはずです。

もちろんトレードオフはあります。クラウドの隔離は毎回まっさらで、維持管理が要らず、同時にいくつも立てられる弾力性がある。物理機はそのクリーンさと手軽さを手放す代わりに、コストを固定費に寄せられる。どちらが得かは使い方次第で、「安全のためのコストをどう持つか」は、これからのAI活用の設計課題になっていくと思います。

使い方の提案 — Cowork時代の許可設定の作法

  1. ファイルは「フォルダ接続」を主経路に。Coworkで作業するなら、旧設定ファイルに頼らず、都度フォルダを接続する運用へ切り替える。いちばん素直で、つまずきが少ない。
  2. 「どちらの層で動く操作か」を意識する。ファイルの読み書きはCowork接続、外部サービスはコネクタ(MCP)。繋がらないときは、まず「どの経路を叩いているか」を疑う。
  3. 最小権限を“不便”ではなく“作法”として使う。毎回の接続はひと手間ですが、これは「任せる相手に、必要なぶんだけ鍵を渡す」ことそのものです。
  4. 旧config方式の人こそ、一度見直す。設定が正しくても、Coworkでは反映されないことがある。両面を知っておくだけで、無駄なトラブルを避けられます。

これは新しい“弊害”でもあります。Coworkでは、こちらが「このフォルダをCoworkで接続して」と指示しないと、MCPの設定自体は正しくできていても、ファイルにアクセスできないことがあります。従来なら“設定さえ合っていれば動く”はずが、Coworkでは“その場の接続指示”という一手間が新たに必要になった——便利さと引き換えの、小さな引っかかりです。

【体験メモ】設定ファイルにはドライブを正しく書いてある。なのにCoworkからは繋がらない。「フォルダを接続」に切り替えたら一発で解決した。原因は、Coworkの標準ファイル操作が“旧設定ファイル”ではなく“フォルダ接続”のほうを見て動くから。

むすび — AIは進化し続ける。人間にも“使いこなす力”が問われる

春版の結論は「AIは設計してから任せる」でした。夏版はその一歩手前をこう言い直します。任せるには、まず“安全に繋ぐ”ところから。

Coworkの「最小権限・セッション単位で、その都度許可する」という作法は、「部下にどこまで任せるか」というあの昔ながらの問いと地続きです。全部の鍵を最初から渡さず、仕事に必要なぶんだけ、その都度渡す。

そして——ここが今回いちばん伝えたいことです。このようにClaudeをはじめとするAIは、これからもどんどん新しい形へ進化していきます。半年で「MCPからCoworkへ」動いたように、また次の形が来る。

だとすれば、問われているのはAIの性能だけではありません。新しいものを理解し、使いこなす力——それが、私たち人間の側にも求められています。AIが進化するスピードに、学び続ける私たちが並走できるか。そこが、これからのAI活用の本当の分かれ目なのだと思います。

関連記事

Claude AI と“フル開発”する2026・続編 ― Fable 5 で見えた「現在位置の再構築」という壁

Mythos 相当の Fable 5 を検証、
Claude AI と“フル開発”する2026・続編 ― Fable 5 で見えた「現在位置の再構築」という壁

前回の記事「光と、壁」では、AIと“フル開発”を進めるときの手応え(光)と、その先に立ちはだかる限界(壁)について書きました。今回はその続編として、壁の正体にもう一歩踏み込みます。きっかけは二つ。最上位モデル Fable 5 の登場と、作業がセッションの制限で途中で止まった、ある一件でした。

Mythos 相当の Fable 5 に、使うモデルを上げてみようとした

Fable 5 は2026年6月に公開された、Claude シリーズで現時点もっとも高性能な一般公開モデルです。これまで一部の組織にのみ限定提供されていた最上位ティア「Mythos」相当の能力を、独立した安全機構を組み込むことで初めて一般公開した、という位置づけになっています。Opus 4.8 の上位にあたり、数時間〜数日に及ぶ長時間・複雑なタスクや、自律的に動くエージェント運用での強さがうたわれています。

「それなら使うモデルを上げてみよう」と切り替えようとしたところ、画面にはこう表示されました。
「This model isn’t available right now. You can switch to another model to continue using Claude.(このモデルは現在利用できません。別のモデルに切り替えれば、引き続き Claude を使えます)」

公開直後はこうした一時的な制限が出ることがあります。拍子抜けすると同時に、ふと立ち止まって考えました。自分は前評判で“過剰な期待”をしていないか、と。

モデルが強ければ、勝手に良い結果が出るわけではない

強いモデルは、こちらの前提整理の甘さまで吸収してくれる魔法ではありません。むしろ前提――指示・ルール・文脈――が難解だったり量が多すぎたりすると、強いモデルほど「全部こなそう」として、かえって挙動がぶれることがあります。

だからこそ、「いちばん賢いモデルを選べば自動的に最適」とは限りません。目的に合わせてモデルを選ぶ行為そのものが、設計の一部です。これは人に仕事をお願いするときと、やる方向性は同じで、前提を整え、ゴールを共有し、節目で確認する。相手がAIでも、変わりません。

効いたのは「小さく、絞る」― 特化スキルという解

AIに渡す作業ルール集(いわゆる「スキル」)を整備したところ、作業が目に見えて安定して進むようになりました。なかでもいちばん効果的だった改善は、一つのファイルサイズを小さく抑えることでした。

これは、スキルそのものにも効きます。サイズが大きすぎるスキルは“熟読”されず、結果としてルールが守られないことが多々発生します。実際、肥大化したルール集は分割しました。改訂履歴や補足を別ファイルへ外出しし、領域ごとに小さなスキルへ割り直したところ、読み込みが軽くなり、ルール遵守が安定しました。

見落とされがちですが、ここがいちばんの肝です。最初に投入するルールが鋭く研がれていれば、出力は驚くほど高い水準に届きます。逆に、あれもこれもと多量のルールを詰め込むと、出力はぼんやりと平均化し、よくできた検索ツール程度の答えしか返ってこなくなります。いろいろやらせすぎると、かえって性能は出ないのです。つまり、たどり着く到達点(最適点)は、最初に与えるルールベースの鋭さで決まります。最適点はあらかじめ一つに定まっているのではなく、出発点しだいで高くも低くもなる。だから、ルールを増やして細かく縛れば堅牢になる、とは限りません。むしろルールが増えるほど、それを破る挙動が多発します。

コーディングでも同じ傾向があります。ファイルが大きいと読み直しが増え、似た字形・同音語の取り違え(文字化けに近い誤り)も起きやすく、無駄な処理コストにつながります。小さく保つと、ここが目に見えて減ります。

そして気づいたのは、特定の領域に特化して小さく組み上げたスキルは、汎用に大きく書いたものより高い性能を引き出せる、という感触です。「広く曖昧」より「狭く明確」。賢さの絶対値より、前提の整え方のほうが効くのです。

「すごいのはモデル」なのか ― 増幅されるのは“問いの鋭さ”

この見立ては、いま話題のセキュリティAIにも当てはまると感じています。Anthropic は、一般公開していない最上位モデル「Claude Mythos」を限定パートナーと運用する取り組み(Project Glasswing)の初期結果として、約1か月で1万件を超える高・重大度の脆弱性を特定したと公表しました(出典:Anthropic「Project Glasswing」)。英国の公的機関 AI Security Institute(AISI)の独立評価でも、隔離された検証環境で同モデルが脆弱性を自律的に発見・悪用し、32段階の侵入シミュレーションを完了できたと報告されています(出典:AI Security Institute の評価)。

数字だけ見ると「モデルがすごい」と思ってしまいます。けれど見方を変えると、すごいのはモデル単体ではなく、そこに鋭い問いと手順を与えた、目を磨き上げたエンジニアのセキュリティスキルのほうではないでしょうか。モデルは増幅器のようなもので、鋭い問いを入れれば鋭く、鈍い問いを入れれば鈍く増幅します。脆弱性をあれだけ掘り当てられたのは、勘所を絞り込んだ“特化した問い”があったからこそ、とも読めます。先ほどの「小さく、絞る」話と、根は同じです。

そして、その鋭い目を持つハイスキルエンジニアは、そう簡単には育てられません。モデルは誰でも同じものを使えます。差がつくのは、何を・どう問うか、どんなルールベースから出発するか――つまり人側の技能です。ここを育て続けられるかどうかが、これからの企業の生き残りを分けるポイントになるのかもしれません。

「現在位置の再構築」― 変だと思ったら立ち止まる

運用を続けるうちに、時々、スキルから外れた作業が行われることに気づきました。そうした挙動を見つけたら「スキルをもう一度確認して」と促す。それだけで、たいていは元に戻ります。

これを繰り返すうちに、その現象が起きるときにはパターンがあるとわかってきました。挙動が乱れやすいのは、次のようなときです。

  • 作業の途中で、セッションの制限により処理が止まったあと
  • 使うモデルを切り替えたあと
  • 提供側(Anthropic)のアップグレードが行われたあと
  • 前回の作業から、長い時間が空いたあと

共通点は、「現在位置」――いまどの前提・どの文脈の上で作業しているのか――の連続性が切れる瞬間だ、ということです。だから再開時には、“いまどこにいるのか”をもう一度組み直す必要がある。私はこれを現在位置の再構築と呼んでいます。今回いちばんお伝えしたかったのが、この一点です。

対処そのものはシンプルです。変だと思ったら、いったん止めて確認させる。これがいちばん効きます。そして、モデルの切り替えのように意図的に制御できるものは、注意すれば最初から避けられます。

少しメタな余談を。この記事自体、前回ぶんの作業がセッション制限で途中停止していました。再開のとき私たちがまずやったのは、本文を書き始めることではなく、“どこまで進んでいたか”の確認と、“前提(方針・公開先・書き方のルール)”の再確認でした。それはまさに、ここで言う現在位置の再構築そのものでした。

まとめ ― 壁は「賢さ」では越えられない

「光と、壁」の続きとして見えてきたのは、壁はモデルをいちばん賢いものに上げれば消える、という種類のものではない、ということでした。鍵は、モデルの賢さそのものより、鋭く絞った問いを設計できる人側の技能にあります。出発点となるルールを小さく整え、特化したスキルを用意し、節目ごとに現在位置を組み直す。この地道な運用こそが、人とAIの共同開発を安定させます。

最適点は一つに決まってはいません。だからこそ、出発点を選び、確かめ、そして立ち止まる余地を残しておく。Fable 5 が使える日が来ても、たぶんこの原則は変わらないはずです。

関連記事・参考

クロードに全工程の開発を任せて見えてきたもの。 2026春時点のAIでの開発の光と壁

— freeBox Loader開発を通じた、個人開発者・小規模チームのための実践的考察 —

2026年春現在、AIを開発パートナーとして「仕様書作成・設計・コーディング・テスト計画・FT実施・引き継ぎまでほぼ全工程」を任せる試みが、現実的に可能になりつつある。私はfreeBox LoaderというOSSプロジェクトで、まさにそのアプローチを徹底的に試した。本稿は、さきの「2026年春版 AIビジネス戦略」記事を横断的に振り返りながら、「横から観察した結果」を基にまとめたものだ。個人開発者や小規模チームがAIを最大限活用するための、光(可能性)と壁(制約)を5:5のバランスで整理する。

背景:freeBox Loaderとは何か、そしてなぜAIに全工程を任せたか

freeBox Loaderは、USB起動のLive環境「hsBox」上で誰でもプラグインを追加・管理できる実行基盤だ。GitHubのindex.jsonを参照し、WebUI経由でモジュールのインストール・運用を行うコア部分と、サンプルプラグイン(例:ATOMCAM2監視カメラ連携)で構成される。当初の計画は、Claudeを「コーディング支援ツール」として使う程度だった。しかし開発規模と複雑度を考慮し、仕様策定から最終引き継ぎまでをClaude主導で進める実験にシフトした。環境は主にClaude-Desktopを使い、セッション消費の監視をClaude.aiで並行。ごく一部でClaude Codeにプロンプトを流し、MCP(Model Context Protocol)の違いを活かしながら作業を進めた。この「ほぼ全工程委託」は、2026年春のAI環境では十分に現実的だった。ただし、そこには明確な光と壁が共存していた。

どう任せたか — 開発プロセスの実際

開発プロセスは、V型モデルを基調にAIと人間が並走する形とした。

  1. 仕様書作成・設計フェーズ:Claudeに全体要件を投げ、機能仕様書・API仕様書・UIモック仕様書を生成させた。人間側は整合性チェックと意思決定のみ。
  2. コーディングフェーズ:Step分割で実装を進め、各ファイル生成後に即時レビュー。
  3. テスト計画・FT実施:テスト計画書作成から内部テスト、本番統合テストまでClaudeが主導。一部はClaude in ChromeによるGUIの自動テストも行った。
  4. 引き継ぎ:セッション終了前に「次担当者(次のAI or 人間)がゼロから再開できる」レベルのメモを義務化。

この流れは、さきの記事で指摘される「AIを“人と同じように扱う”設計」を体現したものだ。AIに「スキル(役割・手順)」を与え、MCPで操作範囲を定義し、「かね(セッション)」という制約を意識した運用である。
結果として、人間の作業時間は大幅に圧縮された。特に設計ドキュメントの量産とコードの初稿生成速度は、人間単独では到底及ばないレベルだった。

見えてきた「光」 — 効果的だった点(可能性)

AI全工程委託の最大の強みは、以下の3点に集約される。
1. 速度と一貫性の劇的向上
仕様書からコード生成までのサイクルが極めて速い。複数ドキュメント間の矛盾を早期に検知できた点も大きい。人間が「設計の意思決定」に集中できるため、全体品質が安定しやすい。
2. 「スキル付与」による役割化のしやすさ
さき記事の言葉を借りれば、AIに「採用担当ペルソナ」や「参謀ペルソナ」を与えるのと同じく、「freeBox Loader開発スペシャリスト」としてスキル(ワークフロー・MCP設定)を付与することで、AIは「1人の優秀な開発者」として機能した。特にClaude-DesktopとClaude.aiの使い分けは、MCP差異を活かした実践的工夫となった。
3. 未来志向の開発スタイルの実現
小規模チームや個人でも、大規模プロジェクト並みのドキュメント品質とテスト網羅性を維持できる。2026年現在、これは「個人が戦える」ための大きな光だ。将来的には、AIが複数の役割(PM・エンジニア・テスター)を同時に担う「AI組織」構築の基盤になると感じる。

見えてきた「壁」 — 問題・課題となった部分(制約)


一方で、限界も鮮明になった。特に最終工程で顕在化した。
1. セッション(かね)の制約と記憶の非連続性
AIには「勤務時間」があり、セッションが尽きると記憶がリセットされる。最終フェーズで細かい問題が多発した際、多量のセッション消費が発生し、大幅な遅延を招いた。引き継ぎメモの運用も完全ではなく、「書く前にセッション終了」による記録欠落リスクが現実化した。そして、それはその後のバグの要因や根本原因となり、AIは何度も同じ間違いを繰り返した。
2. 暗黙の境界線と除外範囲の盲点
テスト計画で「本体テストは進んでいる → システムテストも大丈夫」とAIが判断する一方、サンプルモジュール側の準備が手薄になる「暗黙の境界線」が発生した。AIは与えられた範囲を忠実にこなすが、「含まれないもの」を人間が明示的に定義しない限り、自動で補完しない。これは「人と同じように扱う」からこそ生じる壁だ。想像になってしまうが、現状のAIは近視眼である。1つのセッション内で保持できる記憶量が小さく、参照しているドキュメントの範囲が非常に狭い。高度な実装時術を生かせるのは500ライン程度が限界なのではないだろうか。それ以上の情報は探しながら進めるので目的の場所を見つけたころには1セッションの限界に到達してしまう。そして、AI任せにしていると同じどころをギッタンバッコン更新しまくる事態さえ発生する。
 このような事態にならないようにするには、怪しい動きをしているのを見かけたら、途中で割り込んででも処理を止めたほうが良いことさえある。再発を防ぐためにルールをスキルに追加して防ぐことを試みるが、そのルールが肥大化して、最後にはAIはそのルールをしっかり読まないまま作業に着手する始末である。呼んでいなさそうなところ見つけて再度読むように指示すると読むが、その作業でさえセッションを消費してしまう。整理され冗長性が少なくシンプルで完璧なルールを整備できれば改善できるだろうが、その壁はなかなか高そうである。
3. 最終整合性判断と微調整の負担
生成コードの初稿品質は高いが、環境依存の問題や細かいエッジケースの調整は、人間側の負担が残る。2026年春時点では、AIは「優秀な部下」ではあるが、まだ「完全自律」ではない。特に最終工程(5月上旬)では、これらの壁が重なり、リリースが当初想定より後ろ倒しとなった。

まとめと2026年以降への展望

freeBox Loader開発を通じて見えたのは、AIを「設計し、任せる」時代の本質である。光:個人・小規模チームでも、従来の何倍もの速度と品質で開発を進められる可能性。
壁:セッション制約、記憶の非連続性、暗黙知の扱いという、人間同士の協働とは異なる制約。さきの記事が言うように、AIは「設計すれば人になる」。しかしその設計には、「人と同じように扱う」ための運用ルール(早めの記録分散化、除外範囲の明記、ゼロ知識検証など)が不可欠だ。現在(2026年5月5日時点)、最終調整を終え、まもなくリリースアナウンスする運びとなった。遅延はあったが、そこから得た学びは本プロジェクトの価値を高めている。これからのAI開発は、「どれだけ上手にAIに権限を渡せるか」が鍵になる。個人開発者・小規模チームこそ、この「光と壁」を理解し、AIを真のパートナーとして設計するスキルが、競争力の源泉となるだろう。freeBox Loaderの今後に興味がある方、または同様のAI協働開発を進めている方は、ぜひhsBoxサイトやGitHubで情報共有・コラボをお待ちしています。


関連記事