コンクリート劣化の引き金は「急乾燥」だけではなかった ―― AEの集中発生4回を気象データと重ねて検証

AEセンサーが捉えたコンクリートの「悲鳴」の集中発生4回を、気象庁の10分値と重ねて検証しました。雨上がりの急乾燥だけでなく、強風や強い雨で壁が濡れる「急な湿潤」でもAEが集中していました。

90%→40%)との関係を紹介しました。ただ、あのときは気象データとの一致を文章で説明しただけで、データを並べて見せてはいませんでした。取り上げたAEの集中発生も1回だけでした。

その後も記録を続け、ログを整理し直したところ、AEが短時間に集中して発生した場面は合計4回ありました。今回は4回それぞれについて、気温・湿度・雨・風の推移とAEの発生タイミングを1枚のグラフに重ね、コンクリート劣化の引き金を検証します。

結論を先に書くと、引き金は「急乾燥」だけではありませんでした。強風や強い雨で壁が一気に濡れる「急な湿潤」の場面でも、AEは集中して発生していました。現場の定点カメラの画像でも、発生の前後に壁が濡れていた様子を確認できています。

今回使ったデータとグラフの見方

  • AE:壁に取り付けた自作のAEロガー(4チャンネル)の記録です。しきい値を超えた信号を、時刻と振幅で記録しています。
  • 気象:気象庁「過去の気象データ検索」の10分ごとの値(気温・相対湿度・降水量・平均風速・最大瞬間風速・日照時間)を使いました。観測点は現場から少し離れた近隣の地点です。
  • 定点カメラ:壁を10分ごとに撮影している定点カメラ(ATOM Cam 2)の画像で、発生前後の壁の濡れ具合を確認しました。

プライバシーに配慮して、今回のグラフでは日付と観測地点名を伏せ、横軸を「AE集中発生からの経過時間」(発生の60時間前〜12時間後)にしています。グラフは上から、日照・気温・湿度・降水量(10分ごと)・風速・AE検出数の順です。赤い破線がAEの集中発生時刻、一番下の灰色の斜線は記録が止まっていた区間です。AE検出数は、1件と100件を同じグラフに収めるため対数目盛にしています。

ログを整理して分かった2つの注意点

  1. 時刻の「桁あふれ」:ロガー内部の経過時間カウンター(ミリ秒単位)は、約49.7日で一周してゼロに戻ります。そのまま読むと、実際より約50日前の日付に見えてしまいます。時刻合わせの記録と照合して補正したところ、見落としていた集中発生が見つかりました。
  2. メモリ満杯による記録停止:記録用のメモリ(EEPROM)は128件で満杯になります。4回のうち3回は、集中発生の最中に満杯になって記録が止まっていました。グラフの件数は「少なくともこれだけ発生した」という値です。

イベント① 雨上がりの急乾燥(前回のケース)

イベント①のグラフ。雨上がりの晴天で湿度が87%から40%まで下がり気温が上がった後、乾燥のピーク直後にAEが43件集中して発生している
イベント①:雨上がりの急乾燥。乾燥のピークを過ぎた直後にAEが集中

2日前の雨で、湿度は100%近くありました。そこから晴れて、発生までの約10時間で湿度は87%→40%、気温は8.5℃→19.5℃と一気に変わっています。直前24時間の雨はゼロで、風も穏やか(最大瞬間風速6m/s程度)でした。

AEの集中発生(43件・約11分間)は、乾燥が最も進み、日照が切れて湿度が底から戻り始めた直後に起きています。同じ日の朝、乾燥が急に進み始めた時間帯にも小さな集中(4件)がありました。表面だけが乾いて縮み、湿った裏側との差で反ろうとする力が拘束されてひび割れる、という前回の仮説と合う結果です。

定点カメラの画像では、このときの壁はまだしっとりと湿り気を残していました。空気は一気に乾いても、壁はすぐには乾ききっていなかったことになります。なお、AEの出方は11分間で43件と、後で紹介する②〜④(数秒間に69〜108件)に比べるとずっと穏やかでした。

イベント② 大雨から約10時間後

イベント②のグラフ。乾燥した晴天の後に約46ミリの大雨で湿度が100%に達し、雨が上がって約10時間後にAEが69件集中して発生している
イベント②:乾燥→大雨の後、約10時間たってからAEが集中

2日前は湿度40%前後の乾いた晴天でした。その後雨になり、発生当日の未明から朝にかけて約46mmの大雨(1時間に最大13.5mm)が降り、湿度は100%に張り付きました。

AEが集中した(69件・約6秒間)のは、雨が上がってから約10時間後です。そのときは湿度91%・ほぼ無風・雨なしで、気象データの上では発生の瞬間に目立った変化はありません。

ところが定点カメラの画像を見ると、壁は朝から全面が湿った状態で、それが夕方まで続き、暗くなってから濡れた状態に変わったように見えます。AEが集中したのは、ちょうどこの時間帯です。観測点では雨が記録されていないため、局所的なにわか雨だったのか、湿った空気で壁の表面が結露したのかは、まだ分かりません。

イベント③ 暴風雨の始まり

イベント③のグラフ。雨が続いた後、最大瞬間風速が約16メートルから28メートルへ急に強まり始めた瞬間にAEが108件集中して発生している
イベント③:雨の後、風が急に強まり始めた瞬間にAEが集中

2日前の午後は、気温30℃・湿度40%を切る乾燥した日でした。そこから雨になり、発生までの24時間の雨量は35.5mmです。

AEの集中発生(108件・約9秒間)は、最大瞬間風速が約16m/sから30分ほどで28m/sまで一気に強まり始めた、その瞬間でした。28m/sは記録期間中で最も強い風です。センサー付近は雨粒が直接当たる場所ではありませんが、強風のときは霧状になった雨が吹き込んで壁が濡れます。強風で壁が急に濡れた可能性があります。なお、雨を伴わない強風の日(最大瞬間風速16〜17m/s)にはAEの集中は起きていないので、風そのものが原因とは考えにくいです。

現場でも風は相当なものでした。AE発生の10〜20分ほど前に、定点カメラが強風で吹き飛ばされて向きが変わってしまい、このときの壁の様子は写っていませんでした。

イベント④ 梅雨の長雨と強い雨

イベント④のグラフ。湿度ほぼ100%の長雨が2日半続き、10分間に4ミリから6.5ミリの強い雨が繰り返す中でAEが94件集中して発生している
イベント④:長雨の中、強い雨が繰り返す合間にAEが集中

湿度ほぼ100%が2日半続く梅雨の長雨でした。発生までの雨量は24時間で51.5mm、60時間では143.5mmに達しています。

AEの集中発生(94件・約4秒間)の約1時間半前には10分間に4mmの強い雨が2回続き、その直後には最大瞬間風速も9m/s台まで強まっていました。発生の約20分後にも、10分間に6.5mmの強い雨が降っています。

定点カメラの画像では、発生の40分〜2時間ほど前に、壁の全面が湿った状態に変わっていました。強い雨と風が重なった時間帯なので、風で吹き込んだ雨で濡れたと考えられます。壁が濡れてから少し時間をおいて、AEが集中したことになります。

4回を並べて見えた、コンクリート劣化の2つの引き金

タイプイベントAEの出方直前24時間の雨量気象の状況定点カメラで見た壁
急乾燥①43件/約11分0mm晴天で湿度87%→40%。乾燥のピークの直後まだしっとり湿っていた
急な湿潤②69件/約6秒46.0mm大雨の約10時間後(雨なし・湿度91%)暗くなってから濡れた様子
急な湿潤③108件/約9秒35.5mm最大瞬間風速が約16→28m/sへ強まり始めた瞬間直前にカメラが強風で吹き飛ばされ確認できず
急な湿潤④94件/約4秒51.5mm強い雨と風の後、次の強い雨の直前発生の40分〜2時間ほど前に全面が湿った状態に
AE集中発生4回の比較(気象は近隣の観測点の値)

前回の①は「湿った状態から一気に乾く」変化でした。②〜④はその逆で、「壁が一気に濡れる」変化が起きた場面です。②と④は定点カメラでも濡れを確認でき、③も強風で雨が吹き込む状況でした。コンクリート劣化の引き金は、乾燥そのものではなく乾湿の急な変化だと考えたほうが、4回とも説明しやすくなります。

AEの出方にも違いがあります。①は11分かけてゆっくり43件だったのに対し、②〜④は数秒のうちに69〜108件が集中しました。今回の4回を見る限り、「急な湿潤」のほうがAEは短時間に激しく出ています。

ただし、雨量だけでは決まらない

記録が残っている期間に、1日20mm以上の雨が降った日は13日ありました。そのうちAEの集中発生につながったのは3つの雨の期間だけです。1日40mm前後の雨の日や、1時間に13〜14mmの強い雨が降った日でも、AEの集中発生は起きていません。

③では強風、④では短時間の強い雨が重なっていました。雨量だけでは決まらず、強風や短時間の強雨で壁が実際に濡れるかどうかが効いている可能性がある、というのが現時点での見立てです。

なぜ「濡れる」と音が出るのか(仮説)

前回は「表面が乾いて縮もうとするのに、湿った裏側と周囲に拘束されて縮めない。その結果、表面に引っ張る力が集中してひび割れる」と説明しました。今回の結果は、その逆向きの変化でも同じことが起きうることを示唆しています。

  • 表面の吸水膨張:乾いていた表面が急に水を吸うと、表面だけが膨らもうとします。すでにある微細なひびの面どうしが押し合ったり、ずれたりすることで、音(AE)が出る可能性があります。④で壁が濡れてから少し遅れてAEが集中したのも、水を吸って膨らむまでに時間がかかると考えれば説明がつきます。
  • 乾湿の往復による疲労:「乾く→濡れる→乾く」の急な往復が繰り返されると、同じひびが何度も開いたり閉じたりして、少しずつ進行していくと考えられます。
  • 背面の土圧・水圧の増加:大雨の後は、壁の裏側の土に水が溜まり、壁を押す力が増えます。表面が濡れて膨らもうとする力に、この力が重なっている可能性もあります。

いずれもまだ仮説の段階です。

残っている疑問

  • ②〜④のAEは、振幅がほぼ一定で数秒間に集中しています。振幅がばらつきながら11分間続いた①とは性質が違います。壁を伝う水の流れなど、ひび割れ以外の音を拾っている可能性も、まだ完全には否定できません。
  • ②で暗くなってから壁が濡れた原因(局所的な雨か、結露か)は分かっていません。定点カメラは10分ごとの撮影で、夜間は見えにくいという限界もあります。
  • 気象データは近隣の観測点のものなので、現場とは雨の降り方や風向きが違う可能性があります。
  • メモリ満杯などで記録が止まっていた期間があり、夏の大雨の一部は検証できていません。

次にやること

  • 定点カメラの固定強化:③では強風でカメラの向きが変わり、肝心の場面が写っていませんでした。嵐の日でも壁を撮り続けられるように固定し直します。
  • ロガーの改良:満杯で止まらないように記録容量を増やし、時刻の補正を自動化します。可能であれば、波形そのものも保存したいところです。
  • 濡れセンサーの追加:壁の表面が濡れた瞬間とAEの発生を、直接比べられるようにします。

まとめ

  • ログを補正して整理すると、AEの集中発生は4回ありました。
  • 1回は雨上がりの「急乾燥」、3回は強風や強い雨で壁が濡れる「急な湿潤」の場面でした。定点カメラでも、②と④で発生の前後に壁が濡れていたことを確認しました。
  • AEは、「急な湿潤」のほうが数秒のうちに激しく集中していました。
  • 雨量だけでは決まらず、壁が実際に濡れるかどうかが効いている可能性があります。
  • コンクリート劣化の原因は「乾燥」だけでなく、「乾湿の急な変化」として捉え直す必要がありそうです。

次は、濡れセンサーやロガーの改良で「壁が濡れた瞬間」とAEを直接比べられるようにして、続報でお伝えします。

関連記事

出典:気象データは気象庁「過去の気象データ検索」の10分ごとの値をもとに加工して作成しました(観測地点名は非公表)。
AIが見落とす「データの罠」――賃貸市場分析で学んだ前処理の本当の難しさ

「データさえあればAIが分析してくれる」――そう思っていないだろうか。

筆者は最近、ある地域の賃貸物件データを使って家賃トレンドの分析を行い、その結果を別の記事として公開した。「物価高騰は賃貸家賃に波及していない」「1月は割高、2月以降は割安」「追焚設備が家賃の最強予測変数」といった知見が得られた分析だ。

だがその裏側では、本格的な分析を始める前に、何時間もかけてデータセットの「確立」に苦労していた。AIを使いながらも、AIだけでは絶対に見つけられない問題が次々と現れた。そしてその問題を見逃していたら、統計的には「有意」に見えるが事実とは異なる間違った結論が導き出されていた。

今回はその前処理の過程を正直に公開する。データサイエンスの「格好いい部分」の前にある、泥臭くて地味だが最も重要な工程の話だ。


そもそも「前処理」とは何か

データ分析の工程は大まかに以下の流れになる。

  1. データ収集(スクレイピング等)
  2. 前処理・データセット確立 ← ここが今回のテーマ
  3. 探索的分析(EDA)
  4. モデル構築・検定
  5. 結果の解釈・レポート

前処理とは「生データを分析できる状態に整える」作業のことだ。具体的には欠損値の処理、型変換、外れ値の除去、重複の排除などが含まれる。

教科書的にはシンプルに聞こえる。しかし現実のデータは教科書とは全く違う顔を持っている。


罠①「文字列で格納された数値」――AIは気づかない

スクレイピングで取得した家賃データの形式はこうだった。

rent: "4.1万円"
admin: "4500円"
sikik: "1.5万円"

数値のように見えるが、Pythonの内部では全て文字列(string)型として格納されている。そのままモデルに渡せばエラーになるか、全件NaN(欠損値)になる。

「4.1万円」→ 41,000円への変換は一見単純だが、実際のデータには「-」(敷金なし)「応相談」「無料」など例外が無数に存在した。変換ロジックを書いても、次々と変換失敗するパターンが出てくる。

AIへの指示で自動変換を試みたところ、AIは「変換成功」と報告した。しかし実際には変換失敗した行が大量にNaN化していた。AIは処理を実行したことは正確に報告するが、結果の妥当性を自ら検証する習慣を持たない。確認コードを別途書いて人間が検証する必要があった。

データ解析と問題発見
データ解析と問題発見

罠②「DateTime型がモデルに混入する」――エラーなく通ってしまう

データには取得日(today)と取得タイムスタンプ(source_timestamp)という時系列の列があった。これらは当然、説明変数から除外すべき列だ。

ところがStandardScaler(標準化処理)にこれらをそのまま渡したとき、エラーは出なかった。Pythonは自動的にdatetime型を数値に変換して処理を続行したのだ。

結果として「取得日が新しいほど家賃が高い/低い」という意味のない相関がモデルに混入し、係数が歪んでいた。エラーが出ないため発見が遅れた。AIもこの異常を指摘しなかった。

「エラーなく動く」≠「正しく動いている」。これが前処理の恐ろしさだ。


罠③「ユニークキーの誤設定」――最も危険な罠

今回のデータは「同一物件を複数の取得日にわたってスクレイピングした」時系列パネルデータだ。分析するには「1物件 = 1レコード」に集約する必要がある。そのためにはまず「同一物件を識別するユニークキー」を正しく定義しなければならない。

これが最も深刻な罠だった。3回の定義変更を経て、ようやく正しい答えにたどり着いた。

v1: 物件名(title)単体をキーとして使う

最初は「物件名が同じなら同一物件」と考えた。しかしすぐに問題が発覚した。

「Tiare」「Bonheur」のようなマンション名は、同一棟の複数の部屋(1階・2階・異なる間取り)が同じ名前で掲載されている。title単体でキーを引くと、本来は別レコードであるべき複数の部屋が1件に誤集約される。

v2: SUUMO物件コードをキーとして使う

次に「サイトが付与している物件コード(suumo_code)が最も信頼できるはず」と考えた。しかしここに大きな落とし穴があった。

大手賃貸サイトは同一物件の掲載コードを定期的に更新する仕様だった。

これを確認したときのデータはこうだった。

suumo_code観測期間取得率
1004930303312026-03-10〜03-101日のみ
1004930422852026-03-13〜03-202日

これは実際には同一物件なのに、コード更新によって2件に分裂している。レオパレス系の物件では取得率の中央値がわずか26.5%――つまり38時点中約10回しか同じコードで観測されていない。同一物件が平均4コードに分裂していた計算になる。

この誤集約版でモデルを動かしたときのR²(決定係数)は0.836。見かけ上は非常に高精度なモデルに見えた。しかし実態は水増しされたサンプル数による見せかけの精度だった。

v3(最終): Union-Findアルゴリズムで連結する

最終的な解決策は、Union-Find(素集合データ構造)というアルゴリズムを使った連結だ。

「物件名・不動産会社コード・階数・間取り・家賃が同一で、旧コードの最終観測日と新コードの初回観測日のギャップが7日以内」という条件を満たすものを同一物件として連結する。

連結前: 1,522件
連結後: 1,371件(151件を連結)
募集期間の中央値: 4日(異常)→ 52日(現実的)

募集期間の中央値が4日から52日に変化した時点で「ようやく正しい集約ができた」と確認できた。入居が決まるまでの期間として4日は明らかに異常で、52日は現実的な値だ。

そして正しい集約後のモデルのR²は0.750。v2の0.836より低い。これが正しい精度だ。高いR²が必ずしも「良いモデル」を意味しない典型例だ。


罠④「多重共線性」――変数を増やすほど精度が下がる逆転現象

ユニークキーが確立した後、次の罠が待っていた。

間取り(1K・2LDKなど)と専有面積(㎡)は、直感的には別の情報のように見える。しかし統計的にはほぼ同じ情報を異なる形で表しているに過ぎない。

両方を同時にモデルに投入すると、VIF(分散拡大係数)が以下のようになった。

変数VIF判定
madori_1K(間取り)69.8❌ 深刻
madori_2LDK57.2❌ 深刻
menseki(面積)22.5❌ 問題

VIF>10は多重共線性ありの目安とされる。間取りダミー変数を全て除外して面積のみにしたところ、VIFは全変数で10以下に収まり、調整済みR²も改善した。

「変数を増やす = 精度が上がる」という思い込みは危険だ。不適切な変数の追加は、むしろモデルを壊す。


「見かけの下落トレンド」が前処理の重要性を証明した

これら全ての前処理を経て初めて、時系列分析が意味を持つようになった。

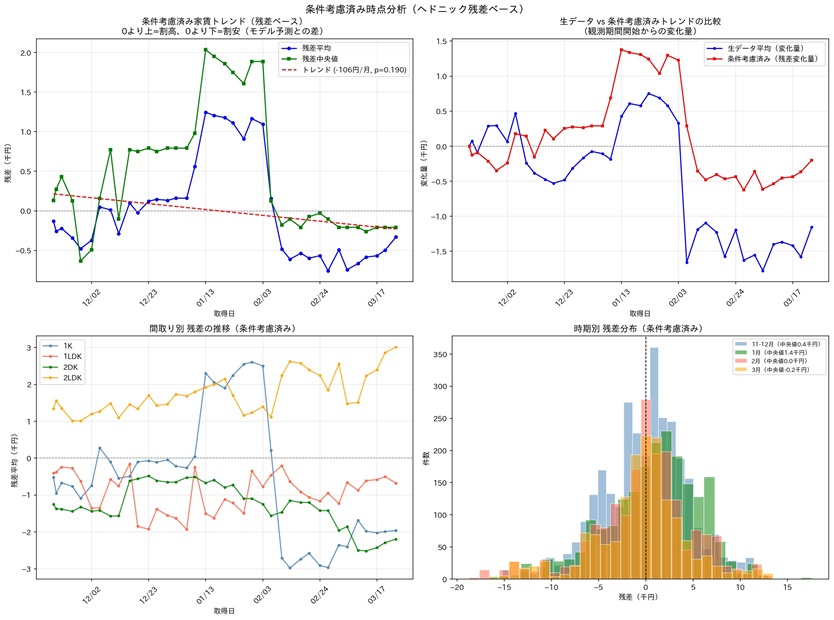
生データの平均家賃をそのまま時系列でプロットすると、月▲380円という明確な下落トレンドが見えた(p<0.001)。もし前処理が不十分なままここで分析を終えていれば、「この地域の家賃は有意に下落している」と結論づけていただろう。

しかし物件条件(面積・築年数・設備など)を除去したヘドニック残差で同じ分析をすると、トレンドは月▲106円でp値=0.190——統計的に有意でない。

「下落トレンド」の正体は、安価な物件の大量新規掲載によるミックス効果だった。前処理が正しくなければ、この区別は絶対にできなかった。


なぜAIだけでは限界があるのか

今回の分析でAIは非常に重要な役割を果たした。Pythonコードの生成、統計的な解釈、可視化スクリプトの作成——これらはAIなしでは数倍の時間がかかっていた。

しかし以下の判断は、人間の「データへの疑い」なしには気づけなかった。

問題なぜAIが見落とすか
文字列型の数値変換失敗「処理した」事実を報告するが、結果の妥当性を自ら検証しない
DateTime型のモデル混入エラーが出ないため異常として認識されない
suumo_codeの定期更新仕様ドメイン知識(サイトの仕様)を持っていない
募集期間「中央値4日」の異常「4日は短すぎる」という現実感覚がない
R²=0.836の見かけ上の高精度高いR²を「良い結果」として肯定してしまう傾向がある

AIは与えられた指示を忠実に実行する。しかし「この結果はおかしい」「この集約方法は現実と合っているか」というドメイン知識に基づいた懐疑心は、人間が持ち込まなければならない。

データサイエンスは「AIに任せれば終わり」ではない。むしろAIを使えば使うほど、人間側の「問いを立てる力」と「結果を疑う目」が重要になる。


まとめ:前処理は「分析の9割」である

今回の分析で前処理に費やした時間は、モデル構築や解釈の時間をはるかに超えていた。そしてその前処理の品質が、最終的な結論の正否を決定的に左右した。

前処理の重要なチェックポイントをまとめる。

  1. 型変換の結果を必ず検証する(変換後のNaN率、値の範囲を確認)
  2. 除外すべき列を明示的にリストアップする(ID列・日付列・生テキスト)
  3. 集約結果が現実と整合するか確認する(「募集期間4日」は現実的か?)
  4. ユニークキーの定義を慎重に行う(データソースの仕様を調査する)
  5. VIFで多重共線性を確認する(変数を増やす前に必ず確認)
  6. 高いR²を盲信しない(集約バグや過学習の可能性を疑う)

「正しいデータセット」なしに「正しい結論」はあり得ない。前処理はデータサイエンスの花形ではないかもしれない。しかし、それが全ての土台だ。


データ分析のご相談はhoscmへ

「自社のデータを分析したいが、どこから手をつければいいかわからない」「AIを使ってみたが正しい結果が出ているか不安」——そんなご相談を承っています。

データの収集設計から前処理・モデル構築・結果の解釈まで、一貫してサポートします。まずはお気軽にご相談ください。

 hoscm サービスサイト

賃貸市場の「本当の家賃トレンド」をデータで暴く――5ヶ月間(2025年11月〜2026年3月)・1,365物件の分析から見えたこと

本記事は、AI連携でどこまで自動化できるかを検証したものです。記事の中身の妥当性については十分には検証できていませんが、作業過程で検証を何回か繰り返しています。元データの取得方法は過去記事を参考にしてください。では、以下がClaude codeを使って解析、生成した分析結果の記事です。


「最近、家賃が上がっている気がする」――そう感じている人は多いだろう。物価高騰が続く中、賃貸市場にも影響が出ているという報道は絶えない。では実際のところ、家賃は本当に上がっているのか。

筆者はある地域の賃貸物件データを約5ヶ月間・38時点にわたってスクレイピングし、統計的な手法で「本当の家賃トレンド」を分析した。単純な平均値の変化ではなく、物件の条件(広さ・築年数・設備など)を揃えた上で比較するという、ヘドニック価格指数的なアプローチを用いた。結果は、多くの人の直感を裏切るものだった。


データの概要

  • 収集期間: 約5ヶ月(38時点)
  • 生データ: 8,592レコード
  • 分析対象物件数: 1,365件(重複・外れ値除去後)
  • 物件タイプ: 賃貸アパート・マンション・一戸建て(ある地方都市周辺)

注目すべきは、大手賃貸サイトは同一物件の掲載コードを定期的に更新する仕様があることだ。そのまま集計すると同じ物件が複数カウントされてしまう。この問題を解決するため、Union-Find(素集合データ構造)というアルゴリズムを用いて同一物件を連結し、正確な集計を実現した。


発見①「家賃は上がっていない」――条件を揃えると見えた真実

まず、シンプルに取得日ごとの平均家賃をプロットすると、月▲380円という下落トレンドが確認された(p<0.001)。「家賃が下がっているじゃないか」と思うかもしれない。

ところが、物件の条件(広さ・築年数・設備・階数など44変数)を重回帰モデルで除去した後の「残差」で同じ分析をすると――

トレンド: 月▲106円、p値=0.190(統計的に有意でない)

つまり、条件を揃えると家賃変動はゼロに近い。物価高騰の影響は、少なくともこの地域・この期間においては賃貸市場には波及していなかったということだ。

生データで見えていた「下落トレンド」の正体は、安価な物件の大量新規掲載によるミックス効果だった。


発見②「2月の急落」は本物か

データを眺めていると、2月上旬に平均家賃が突如▲1,500円近く急落する場面があった。

要因金額
物件ミックスの変化(安価物件の大量掲載)▲1,000円
本物の需要緩和(条件考慮後も残る下落)▲500円
合計▲1,500円

急落の3分の2はミックス効果で、残り3分の1が実態のある需要緩和だった。このような「見かけの変動」と「実態の変動」を区別するには、条件考慮済みの分析が不可欠だ。


発見③「1月は割高、2月以降は割安」という季節性

条件考慮済みの残差を月別に見ると、明確な季節パターンが浮かび上がった。

時期残差(条件考慮済み)解釈
11〜12月±500円程度安定
1月+1,000〜+2,000円需要ピーク・割高
2月以降▲400〜▲800円需給緩和・割安

1月は引越しシーズン前の駆け込み需要で、同じ条件の物件でも約1,000〜2,000円高く成約されていた。逆に2月以降はその反動で割安感が出ている。

賃貸を探すなら、1月ではなく2〜3月以降の方がコスト効率が良いという示唆が得られる。


発見④ 家賃を決める最強の変数は「追焚」だった

重回帰分析で44変数を投入したところ、最も家賃との相関が高かった変数は意外にも「追焚(お風呂の追い焚き機能)の有無」(相関係数r=0.670)だった。

順位変数相関係数
1追焚設備あり+0.670
2専有面積(㎡)+0.651
3総戸数(棟の規模)-0.584
4仲介手数料額+0.526
5礼金+0.459

追焚が最強の予測変数になった背景には、地域の入浴文化や生活習慣が影響している可能性がある。また、「大規模物件(総戸数が多い)ほど家賃が低い」という結果は、管理コストの規模の経済を反映していると考えられる。


発見⑤ 「2LDKは割高、1LDKは割安」という構造的価格差

間取り別に条件考慮済みの残差を分析すると、興味深い構造が浮かび上がった。

間取り残差解釈
2LDK+1,000〜+3,000円一貫して割高
1LDK▲1,000〜▲2,000円一貫して割安
1K季節性あり(1月に割高)需要変動大きい

同じ面積でも、2LDKはファミリー向けの需要プレミアムが乗っており割高になる傾向がある。一方1LDKは供給過多気味で割安。カップルや二人暮らしなら1LDKも候補に入れると費用対効果が高い。

賃貸市場の家賃トレンド分析グラフ(条件考慮済み)

分析に使ったモデルの精度

最終的に採用したモデル(重線形回帰・44変数+交互作用2項目)の精度は以下の通り:

指標値
R²(決定係数)0.750
調整済みR²0.699
RMSE4,506円
VIF>10(多重共線性)なし

実際の家賃と予測値の誤差が平均±4,500円程度に収まっており、賃貸物件の価格モデルとして実用的な精度が得られた。


まとめ:賃貸市場の「見えない構造」

今回の分析から得られた主要知見をまとめる。

  1. 物価高騰は賃貸家賃に波及していない(少なくともこの地域・この期間)
  2. 家賃の下落トレンドは物件ミックスの変化が原因で、実態は横ばい
  3. 1月は割高、2月以降は割安というサイクルが存在する
  4. 追焚・専有面積・大規模物件の規模が家賃を最も強く説明する
  5. 2LDKは割高、1LDKは割安という構造的価格差がある

賃貸物件を探す際、これらの知見を活用することで、より合理的な意思決定ができるだろう。


分析の補足・免責事項

本分析は特定の賃貸情報サイトのデータをスクレイピングして実施したものであり、市場全体を代表するものではない。また、「掲載から消えた = 入居決定」という推定には不確実性が伴う。分析期間が約5ヶ月と限られているため、年間の季節変動を完全には捉えられていない点にも注意が必要だ。

本記事の分析コードはPython(pandas・scikit-learn・statsmodels・scipy)を使用して作成した。


どうだろうか、素人が使いこなすには難しいかもしれないが、分かっている人が分析する分には効率的な作業を行える。課題は本当にわかっているか、ちゃんと検証できているかだろう。 この資料を生成するまでの過程は、別の記事にしてみよう。


関連記事