【その3】ローカルAIでMV動画を自動生成|準備5分+待ち3時間で4分の動画が作り放題

シナリオからMV向けの動画を自動生成する仕組みがほぼ完成。ブラウザでの準備5分+待ち約3時間で4分の動画が完成。変な画像だけ差し替える修正機能、無料・商用可モデルでの検証、高性能モデルへの切替も解説します。

この記事でわかること

  • ローカルPCだけで、シナリオからMV向けの動画を自動生成する流れ
  • 4分の動画に必要な作業時間(準備5分+待ち約3時間)
  • 変な画像・動画だけをブラウザで確認して、差し替える方法
  • 無料・商用利用可のモデルでの検証結果と、高性能モデルへの切り替え方

動画生成の仕組みが「ほぼ完成」しました

2026年10月末に、シナリオから動画を自動で作るシステムが動き始めました(2026秋 シナリオから動画を、手元のPC(LLM)だけで自動で作るシステムが稼働)。続く11月8日の【その2】では、シナリオの時間どおりに長さを合わせる仕組みと、生成時間の見積もり機能を作りました(【その2】シナリオから楽曲の4分39秒の長編動画を自動生成)。

その後も改良を重ね、MV動画づくりの一連の流れが、最初から最後までほぼ通しで動くようになりました。シナリオからの生成の自動化が一段落したので、開発の重心を「仕組み」から「ストーリー(コンテンツそのもの)」へ移していきます。

第8段(試作8回目)では、次の機能が加わりました。

  • 効果音(SE)の調整:ある程度、狙いどおりに効くようになりました
  • キャラクターの固定:登場人物の見た目を、カットをまたいで保つ機能です。ある程度効いています
  • 個別修正:カットごとに、プロンプトや設定を直せます
  • 楽曲の重ね合わせ:曲のタイミングに、かなり合う感触です

試作8回目の動画は、個別修正を使わない、AIだけが書いた初版です。

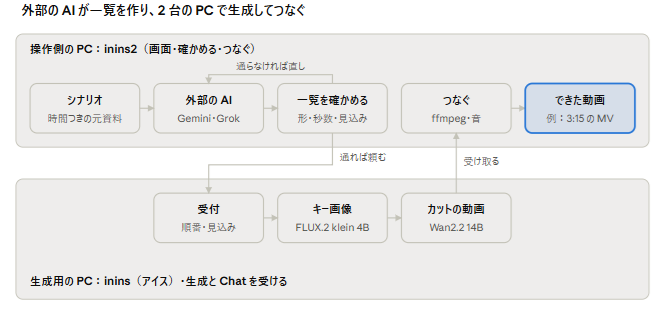
シナリオからMV動画ができるまでの流れ

全体の流れは次のとおりです。

  1. シナリオを用意する(楽曲に合わせた、場面ごとの文章)
  2. 外部のAI(GeminiやGrokなど)に、場面ごとのプロンプト一覧(JSON)を作らせる
  3. ブラウザの画面で一覧を確認し、生成を依頼する(人の作業はここまで・約5分)
  4. 生成用PCが、画像と動画を順番に自動で作る(約3時間)
  5. できた画像・動画をブラウザで確認し、必要なカットだけ直して差し替える
  6. カットを1本につなぐ

構成は、操作用PCと、GPUを積んだ生成用PCの2台です。それぞれの窓口をあわせて「アイシズ」と呼んでいます。画像はFLUX.2 klein 4B、動画はWan2.2 14Bを、ComfyUIで動かしています。人の手が必要なのは、依頼文を外部AIに貼る、返事を貼り戻す、生成を頼む、の3か所だけです。

【動画埋め込み②】元の楽曲「システムアラート」(4分39秒)。この曲の世界をシナリオにして映像化しています。

準備5分+待ち約3時間で、4分のMVができる

4分前後のMV向け動画の場合、Webブラウザ上での準備操作は5分ほど。生成を依頼してから素材がそろうまでは、約3時間です。

  • 人の作業:約5分(依頼文を外部AIに貼る→返事を貼り戻す→生成を依頼する)
  • 待ち時間:約3時間(画像と動画の自動生成。人は張り付かなくてよい)
  • できるもの:4分程度のMV向けの動画

3時間は短くありませんが、人が画面の前にいる必要はありません。夜に依頼して、朝に確認する使い方ができます。【その2】では、3分15秒の一覧に対して「約7時間37分」の見込みが出ていました。そこから見ると、待ち時間は大きく縮んでいます。なお、約50カット(縦・標準解像度)の場合の目安です。

縮んだ要因のひとつは、同じモデルを続けて流す順序の工夫だと考えています。画像モデルと動画モデルを交互に流すと、毎回モデルの読み込みが入り、2秒の動画1本が約590〜610秒、画像1枚が約110秒かかっていました。同じモデルを続けて流すと、動画は約258秒、画像は約10秒に縮みます(前回の実測値)。

変な画像だけ直せる「部分差し替え」

画像生成AIには、どうしても当たり外れがあります。手が崩れている、顔が別人になっている、背景がおかしい。3時間かけて作った素材に1枚変なものが混ざるたびに、全体を作り直していては割に合いません。

そこで、ブラウザ上で画像や動画を確認し、必要な部分だけを修正して差し替えられるようにしました。実際に使ってみて、うまく動いています。

  1. ブラウザで、各カットの画像と動画を見て確認する
  2. 変なカットだけを選んで、修正する
  3. 修正したカットを、元のカットと差し替える
  4. 最後に、1本につなぎ直す

修正の方法は2通りあります。ひとつは、そのカットのプロンプトや設定を直して、作り直す方法。もうひとつは、できあがった画像を参照画像にして、気になる部分だけを直す方法です。どちらも使っています。

効くのは、時間の差です。前回の実測では、画像1枚の再生成は10秒〜約2分、2秒の動画1本は約4〜10分でした。数十カットある動画のうち数カットを直すだけなら、全体の3時間をやり直さずに済みます。

ローカルで動くから「作り放題」

使うモデルがすべてローカルPCで動くため、クラウドの動画生成サービスに多い「1本ごとの課金」や「月の生成回数の上限」を気にする必要がありません。かかるのは、PCの電気代と待ち時間だけです。

試行錯誤が欠かせない動画づくりでは、これが大きな差になります。1つのシナリオを何度でも作り直せますし、気に入らない場面は遠慮なく撮り直せます。夜間に回して朝に確認する使い方なら、待ち時間もあまり気になりません。

しかも、生成用PCのGPUはRTX 3080(VRAM 10GB)です。最新のハイエンドではない、手元にありそうな構成で動いています。自分のPCで試してみたい方の目安にしてください。

無料・商用利用可のモデルで検証、高性能モデルへの切り替えも簡単

現在の動作検証は、無料で、かつ商用利用も可能なモデルだけで行っています。

  • 画像:FLUX.2 klein 4B(Apache 2.0ライセンス)
  • 動画:Wan2.2 14B
  • 文章の相談相手:Ollama上のgemma4:26b

画像モデルは、当初FLUX.2 devを検討しました。しかし非商用ライセンスだったため、発信用の制作には使えないと判断し、klein 4Bに切り替えました。「無料で動く」だけでなく「作品として公開できる」ことを条件にしています。

そのうえで、ワークフロー(ComfyUIでの処理の定義)を差し替えれば、より高性能なモデルも簡単に使えるようにしてあります。すでにMiniMax H3も登録しており、音つきの生成にも対応できます。

ただし、高性能なモデルを使うときは、ライセンスと表記条件の確認が欠かせません。たとえばMiniMax H3は商用利用が可能ですが、使う場合は動画の説明文への明記が必要です。ライセンスは更新されることがあるため、使う前に必ず配布元の一次情報で確認してください。

実際に作った動画

ここまでに作った動画を並べます。いずれもシナリオから自動生成した素材をもとにしています。

【動画埋め込み③】警告音が鳴り響くサイバーパンク都市へ(AI シナリオから自動生成)

【動画埋め込み④】ローカルPCだけでシナリオ→動画を自動生成してみた

【動画埋め込み⑤】発案から1日。AIだけでサイバーパンクアニメ作ってみた

【動画埋め込み⑥】AIだけでサイバーパンクアニメ作ってみた 音入りに挑戦 その6

【動画埋め込み⑦】試作8回目 警告音が鳴り響くサイバーパンク都市へ(AI自動生成)Claude版 Short

シナリオ作りのコツ:時間とカットを決めておく

仕組みが整うと、品質を左右するのはシナリオです。【その2】で分かった、うまくいくコツを3つ紹介します。

  • 場面ごとの時間を書く:「0:00 – 0:17」のように、元のシナリオに時間を入れておきます。外部のAIに「この時間を必ず使う」と求めると、できた一覧が曲の長さに揃います。
  • 1カットは5秒以内にする:Wan2.2は動画1本が5秒までです。長い場面は5秒以下のカットに分け、キー画像は1枚を使い回します。
  • 秒数の合計を曲の長さと比べる:4分39秒の曲なら279秒です。一覧の動画の秒数の合計が合っているかを、生成の前に確かめます。

この3つを依頼文に入れただけで、28秒だった一覧が、シナリオどおりの3分15秒(41カット)になりました。

現状の課題も正直に

  • 音:Wan2.2は音を作れません。曲を重ねるか、音つきで作れるモデルが必要です。効果音(SE)は、その6では期待しない音が入ってしまいましたが、試作8回目で調整しなおし、ある程度効くようになりました。まだ調整は続きます。
  • キャラクターの固定:固定機能を追加して、ある程度効いています。完全ではないので、精度を上げていきます。
  • 待ち時間:約3時間にはまだ縮める余地があります。静止画に動きを付けて、安く尺を埋める方法なども試したいと考えています。

ここからは「ストーリー」の番

仕組みがほぼ固まったので、次は中身、つまり物語・キャラクター・映像の演出です。同じ仕組みでも、シナリオ次第でまったく違う作品になります。これまでの試作は、楽曲「システムアラート」の世界(青白い管理都市に、赤いノイズが侵食していく)でした。今後は、シナリオ作りに時間をかけて、作品の幅を広げていきます。

ゆくゆくは、MVだけでなく、縦のショート動画や通知映像など、いろいろな形に対応させたいと考えています。

よくある質問

ローカルAIでMV動画を作るには、どんなPCが必要ですか?

開発では、GPUがRTX 3080(VRAM 10GB)の生成用PCと、操作用のPCの2台を使っています。生成には時間がかかるため、夜間に回す使い方が向いています。必要なスペックは、使うモデルや動画の大きさで変わります。

本当に無料で作れますか?

検証に使っているモデルは、無料で、かつ商用利用が可能なものです。ただし、PCと電気代はかかります。モデルのライセンスは更新されることがあるので、使う前に配布元で確認してください。

音も自動で入りますか?

現在使っている動画モデルのWan2.2は、音を作れません。曲を重ねるか、音つきで作れるモデル(MiniMax H3など)を使います。効果音つきの生成も、調整を重ねて、ある程度効くようになりました。

高性能なモデルに切り替えられますか?

できます。ワークフローを差し替えることで、別のモデルを使えるようにしてあります。ただし、モデルごとにライセンスや表記の条件が違うため、確認が必要です。

まとめ

  • シナリオからMV向けの動画を自動生成する仕組みが、ほぼ完成した
  • 4分程度の動画で、ブラウザでの準備は約5分、生成の待ちは約3時間
  • 変な画像・動画は、必要なカットだけ確認して差し替えられる
  • 検証は無料・商用利用可のモデルで行い、ワークフローの差し替えで高性能なモデルにも対応できる
  • 開発の重心は、仕組みからストーリーへ移っていく

完成版(フル)は11月25日にhoscmから、ショート版は同日にMIC-NETチャンネルで公開する予定です。次回は、ストーリーづくりを中心に報告します。
関連記事

【その2】シナリオから楽曲の4分39秒の長編動画を自動生成|ローカルAIで時間通りに作る方法、 アイシズ(統合インテリジェンスサーバー群)開発

シナリオ(3分15秒のMV)から時間通りのプロンプト一覧を作り、ローカルのLLM+Wan2.2/FLUXで長編動画を自動生成。生成時間の見積もり機能と、同じモデルを連続実行するだけで大幅に時間を短縮する方法を公開。アイシズ(aia studio)開発記その2。

概要

シナリオ(3 分 15 秒の MV)から、時間どおりの長さのプロンプトの一覧を外部の AI に作らせられるようになりました。前の回は 28 秒にしかならなかった一覧が、今回は 195 秒(41 カット)で通りました。→ 楽曲の長さが4:39だったのでアイシズで自動調整も強化

aia studio(アイシズ) は、ローカルの LLM と画像・動画の生成モデルで、シナリオから動画を作る自作のツールです。今回のスレッド(06・2026-10-31)では、次の 3 つを進めました。

  • 頼む前に「およそ何時間・何時ごろ終わるか」が分かるようにした
  • 外部の AI への依頼文を強めて、シナリオの時間を守らせた
  • 操作画面の使い勝手を直した

あわせて、生成の順番を変えるだけで時間を大きく縮められることにも気づきました(下の「気づき」)。

全体の構成

操作側の PC と、GPU のある生成用の PC の 2 台で動きます。それぞれの窓口である inins(アイス)と inins2 を、あわせて「アイシズ」と呼んでいます。

[embed: node/cb244d1f-8588]

人の手は、依頼文を AI に貼る・返事を貼り戻す・頼むの 3 か所だけです。画像と動画は生成用の PC で順に作られ、済むと操作側が自動で受け取ってつなぎます。

改善 1:かかる時間の見込み

一覧を確かめた時点で、生成にかかる時間と終わる時刻が出ます。長編では何時間もかかるので、夜に流すか・今流すかを頼む前に決められます。

実際の表示(MV の一覧・48 行):

問題ありません:48 行
動画の行 41 本・秒数の合計 195 秒(3:15)
かかる時間の見込み:この一覧 約 7 時間 37 分 → 今すぐ頼むと 明日 04:51 ごろに終わる見込み
  - 画像_flux2_klein_4B_文から画像_api:7 行・約 13 分
  - 動画_wan2.2_14B_画像から動画_api:41 行・約 7 時間 25 分
  • 見込みのもとは、生成用のマシンが記録している実績です。秒数・大きさ・枚数が同じジョブの、最近 5 件の平均を使います
  • 同じ実績がない行は、同じワークフローの実績か既定の値で数え、「ずれやすい」と表示します
  • 生成の途中も、行ごとに「実行 3 分・あと約 7 分」、一覧ごとに「全部終わる見込み 明日 03:10 ごろ(あと約 15 時間)」と出ます(数字は表示の例)
  • 計算は生成用のマシンの受付 1 か所で行い、コマンドと画面の両方で同じ数字を出します

改善 2:外部の AI への依頼を強めて、シナリオの時間を守らせた

依頼文に「元資料の時間を必ず使う」「1 カットは 5 秒まで」と書いただけで、できた一覧の長さがシナリオどおりの 3:15 になりました。

回依頼文外部の AI動画の行長さ
前の回(2026-10-30)「1 場面=数秒」・例が 2 秒Grok14 本28 秒
1 回目(2026-10-31)「1 場面=約 15 秒」だけGemini15 本75 秒
2 回目(2026-10-31)時間を守る・5 秒以下のカットに分けるGemini41 本195 秒(3:15)

1 回目で尺が足りなかった原因は 2 つです。

  • 動画モデル(Wan2.2)は 1 本 5 秒までです。「15 秒」と書いても、AI は 5 秒に抑えて場面の数だけ作りました
  • 依頼文で、シナリオに書いてある時間(「0:00 – 0:17」など)を守るように求めていませんでした

直したこと:

  • 依頼文のひな形で、次のことを求めるようにした:元資料の時間を必ず使う・場面の長さを動画の行の秒数の合計で埋める・長い場面は 5 秒以下のカットに分ける(キー画像は 1 枚を使い回す)・行のメモに時間とカットの番号を書く
  • 1 場面の秒数がモデルの上限を超えたら、依頼文を作るときに知らせる
  • 返事を確かめるときに「動画の行 N 本・秒数の合計 M 秒」を出し、シナリオの長さとすぐ比べられるようにした

外部の AI に任せるのは「決まった形の答え」(一覧の JSON)だけです。形や値の範囲はツールが確かめ、通らない行は「直し」の依頼文を自動で作ります。

改善 3:操作画面(inins2)の使い勝手

実際に使ってみて引っかかった所を、すべて直しました。どれも実機で確かめ済みです。

引っかかったこと直したあと
「元資料」の欄にシナリオの文を貼るとエラーになる場所でも URL でもない行があれば、文として使う。短い文とファイルの場所が混ざっていたら止めて知らせる
「クリップボードから貼る」で読めないことがある1 回読み直し、だめなら「欄を選んで Ctrl+V」と案内する
行の一覧を開いても、10 秒ごとの読み直しで閉じる開け閉めを一覧ごとに覚える
評価のメモを書いている途中でも、読み直しで文が消える書きかけを覚え、書いている間は作り直さない
行数や 1 場面の秒数などの制限が固定設定と画面の欄で変えられる

画面は、生成の状態を見るタブと、外部の AI とやり取りするタブに分かれています。外部の AI とは「依頼文をコピーして貼る → 返事を貼って確かめる → 頼む」の 3 手でやり取りできます。

気づき:画像と動画を交互に流すと、毎回モデルを読み直していた

同じモデルを続けて使えば、動画 1 本は約 600 秒から 258 秒、画像 1 枚は約 110 秒から 10 秒に縮みます。前の回の 28 行の一覧は「画像→動画→画像→動画…」と交互に流れ、全部の行でモデルを読み直していました。

流し方動画 1 本(Wan2.2・2 秒)画像 1 枚(FLUX.2 klein 4B)
交互に流す(2026-10-30 の 28 行)590〜613 秒108〜113 秒
同じモデルが続く258 秒10 秒
  • 各行の記録では、使い回せたノード(キャッシュ)がどの行も 0 でした。メモリ(32 GB)に 2 つのモデルが収まらず、入れ替えるたびに読み直していると推定しています
  • 同じワークフローを続けて流せば、28 行は約 2 時間 37 分から約 1 時間 10 分になる見込みです(実機ではこれから確かめます)
  • 人が手で作るときは、もうこの順に並べていました。その工夫をツールの受付(生成の順番を決める所)に入れます

これから

次の目標は、この MV のシナリオから音入りの 3:15 の動画を自動で作ることです。次の順で進めます。

  1. 生成の順番:同じモデルを続けて流し、全体の時間を縮める。見込みも、秒数の違う実績を秒数の比で伸ばして近づける
  2. 作品の設定と時間つきの一覧:全体の長さ・向き(縦・横・ドット数)・音・表現方法などを最初に決める。一覧の行に開始と終わりの時間を持たせ、すき間や重なりをツールが確かめる
  3. 目次と部:行が多い作品は、目次を先に作らせて部に分けて頼む
  4. 時間でつなぐ・曲を重ねる:カットを時間の位置に置き、曲に合わせる

その先には、キャラクタの固定、静止画に動きを付けて安く尺を埋める方法、できた動画の品質を自動で調べる仕組みが控えています。いまは MV の形に合わせていますが、ゆくゆくは縦のショートや通知映像など、いろいろな形に対応させます。


関連記事

2026秋 シナリオから動画を、手元のPC(LLM)だけで自動で作るシステムが稼働(自動動画生成)

InIns’s (アイシズ) 開発記 2026年10月25日〜30日の6日間のまとめ

文章のシナリオを渡すと、場面ごとの画像と動画を自動で作り、最後に1本につなぐ。そんなツールを、ローカルのLLMと画像・動画生成モデルだけで作っています。この記事では、6日間でできたこと、測った数字、つまずいた点、そして第一弾の動画から見えた課題を書きます。

第一弾の動画(縦・14場面・28秒)をここに入れます第一弾:MV『システムアラート』の試作。青と白の管理都市に、赤いノイズが侵食していく構成。生成の音はなし。

つくっているもの

役割の違う2台のPCを使います。重い生成は、RTX 3080(VRAM 10GB)の生成用PCが受け持ち、依頼や受け取り、結合は、GPUの弱い操作用PCから行います。操作用PCは、同じ部屋のLAN内でつながっているだけで、外には公開していません。

シナリオ→外部AI(依頼文を貼る)→プロンプト一覧(JSON)→常駐サーバー→ComfyUI→動画を受け取って結合

画像は FLUX.2 klein 4B、動画は Wan2.2 14B(ほかに MiniMax H3 も登録)、文章の相手には Ollama 上の gemma4:26b を使っています。シナリオから場面ごとの一覧を作る部分は、手元のLLMではなく、外部のAI(Grok や Gemini)にチャットで任せる設計にしました。

6日間の経過

日できたこと
10/25〜27方針と決めごとを文書化。ComfyUIのワークフローをAPI形式で4本書き出し、最小のプログラムで動画を1本生成(2秒・640×640・602秒)。
10/28LLMと生成モデルを同時に載せたときのメモリを実測。操作用PCから依頼して生成用PCで動画ができる「段階A」が完成。ライセンスを調べ、画像モデルをFLUX.2 devからklein 4Bへ変更。
10/29文から画像、参照画像から画像、HD動画を追加。前の成果物を画像として再利用する書き方を整備。Chatと生成を1本にまとめたサーバー(inins)を作成。一覧を一括で頼む仕組みを追加。
10/30外部AIが作った28行の一覧が1回で通り、全部生成。動画をつなぐコマンドと、操作用PCの管理画面(inins2)を追加。
システムアラート1回目版

測ってわかったこと

作業時間
Wan2.2 動画2秒(640×640)258秒(モデル読み込み済み)/約600秒(読み込みから)
Wan2.2 動画2秒(縦480×832/横1280×720)595秒/631秒。HDにしても時間はほぼ変わらず
klein 4B 蒸留版 アイキャッチ2枚(1600×896)49秒(初回)、10秒(2回目)
klein base 4B 同じ条件225秒。蒸留版の方が圧倒的に速い
参照画像から画像(昼を夕方に直す)41秒
gemma4:26b の読み込み毎回約2分(GPU 39%/CPU 61%で動作)

動画の生成中はRAMの空きが2〜4GBしかなく、LLMと同時に載せるのは現実的ではありません。そこで「GPUの仕事は1度に1つ」とし、動画を作る前にLLMを外す運用にしました。動画は1本約10分なので、14本なら単純計算で2時間強。長編では待ち時間の設計が重要になります。

つまずいたこと

  • ライセンス。画像モデルFLUX.2 devは非商用ライセンスで、発信用の制作には使えないと判断し、Apache 2.0のklein 4Bへ切り替えました。9Bも非商用でした。MiniMax H3は商用可ですが、使う場合は動画の説明文に明記します(開発中に確認した範囲なので、公開前には一次情報を確かめます)。
  • ワークフローの書き出しミス。画像から動画の入力がフレームの「最後」につながっていた、UNETに別モデルが入っていた、など。中身を読んで直しました。
  • 手順書の細かな誤り。PowerShellにcmdの書き方を示した、別のPCで実行された、など。以後は、貼ればそのまま動く形で示す決まりにしました。
  • 小さなLLMの限界。手元のgemmaにファイルを読み書きさせると、文字化けを正常な結果として受け取り、書き換わっていないのに「完了」と答えました。原因は、道具のエラーの返し方にありました。

第一弾の動画から見えた課題

元のシナリオは3分15秒の曲ですが、できた動画は28秒でした。時間の情報は一覧の形に入っておらず、依頼文の例が「2秒」だったため、外部AIがその値を全行に写したのが主因です。次の版では、作品全体の向き・大きさ・長さ・音の扱いを最初に決めて強制し、場面ごとの時間も一覧に持たせます。

音もありません。Wan2.2は音を作れないためで、音つきならMiniMax H3、または曲を重ねる指定が必要です。登場人物の固定も未対応で、同じ少女が毎回別の顔になります。キャラクターを登録し、一覧から参照する仕組みを作ります。

依頼文を作る、返事を貼って確かめる、誤りがあれば直しの依頼文を作る、という手順は、人の作業が片道2つ(貼る・ドロップ)で済むようにしてあります。

これから

  • 全体の所要時間の見積もりを、確かめの段階で出す
  • 手元の小さなLLMに、依頼の仕分けだけを任せる(15件の試験で最も良かったqwen3:4bが11件正解。決まりと似た例を足して精度を上げる)
  • 作品の設定、場面の時間、キャラクターの固定、音の指定
  • できた動画の自動チェックと、撮りためた実写からの場面抽出(将来)

関連記事

ComfyUIで動画生成を試してみる ― MiniMax H3を実際に動かしてみた

これまでコード生成を中心に試してきましたが、今回は一歩進んで、ComfyUIを使った動画生成を試してみることにしました。

今回使用したのはWindows版の ComfyUI Desktop。

動画生成用のテンプレートを確認すると、MiniMax H3、LTX-2.5、LTX-2.3、Wan 2.2、Hunyuan Videoなど、非常に多くのワークフローが用意されています。

はじめに

これまでコード生成を中心に試してきましたが、今回は一歩進んで、ComfyUIを使った動画生成を試してみることにしました。

今回使用したのはWindows版の ComfyUI Desktop。

動画生成用のテンプレートを確認すると、MiniMax H3、LTX-2.5、LTX-2.3、Wan 2.2、Hunyuan Videoなど、非常に多くのワークフローが用意されています。

あまりにも数が多いため、今回はその中からまず、

MiniMax H3:テキストから動画へ

を試してみることにしました。

そして、MiniMax H3でいくつか動画を生成した後、次の比較対象として Wan 2.2 5B に進むことにしました。


1. ComfyUIには動画生成用テンプレートが大量にある

ComfyUI Desktopの動画生成テンプレートを確認すると、かなりの数のワークフローが用意されています。

今回確認しただけでも、

  • MiniMax H3
  • LTX-2.5
  • LTX-2.3
  • Wan 2.2 14B
  • Wan 2.2 5B
  • Wan Animate
  • Hunyuan Video 1.5
  • SCAIL-2
  • InfiniteTalk
  • Wan VACE
  • Kandinsky 5.0 Video
  • LTXV

など、さまざまな動画生成モデルが並んでいました。

画面には

157件中64件のテンプレートを表示中

と表示されており、動画生成だけでもかなりの選択肢があります。

最初から全部を試すのは現実的ではないので、今回はMiniMax H3から始めます。


2. MiniMax H3のテキスト→動画を試す

選択したのは、

MiniMax H3:テキストから動画へ

というワークフローです。

最初はノードグラフが複雑に見えました。

しかし、よく見ると動画生成に必要なモデルやエンコーダ、解像度設定などがすでに接続された状態になっています。

さらに、動画生成の中心となるノードには、かなり長い英文プロンプトが最初から入力されていました。

この英文をクリックしてみると、普通の入力欄として編集できます。

そこで、まず非常にシンプルなプロンプトに変更しました。

Three young women walking slowly through a quiet city street in the early morning, cinematic

これだけでも、実際に動画を生成することができました。

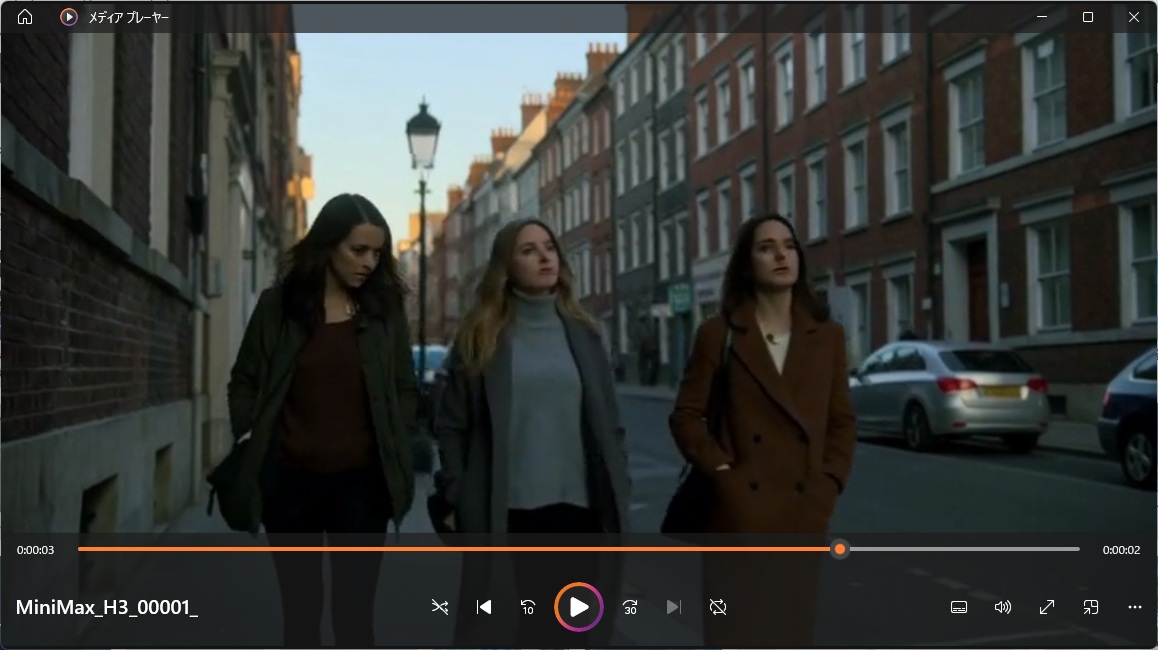
MiniMax_H3

3. RTX 3080 10GBで実際に動画生成

今回使用しているGPUは、

NVIDIA GeForce RTX 3080 10GB

です。

動画生成中には、

  • GPU使用率:100%
  • VRAM使用量:約9.6GB / 10GB
  • GPU温度:約87℃
  • 消費電力:約265W

という状態になりました。

かなりGPUを使っています。

しかし、生成中のGPU使用状況を見る限り、きちんとGPUを使って動画生成できていることが確認できました。

その後、生成が終了するとGPU使用率は大きく低下し、温度も40℃程度まで下がりました。

したがって、今回の環境では、

RTX 3080 10GBでMiniMax H3の動画生成を実行できる

というところまでは確認できました。


4. 5秒の動画生成には約10分

最初のテストでは、5秒程度の動画を生成しました。

生成時間は、

約10分

でした。

次に20秒程度の動画も試してみました。

こちらは、

約50分

ほどかかりました。

単純計算では、

動画長生成時間
約5秒約10分
約20秒約50分

という結果です。

もちろんプロンプトや設定、生成条件によって変わるため、この数字をそのまま一般化することはできません。

しかし、少なくとも今回のRTX 3080環境では、

「数秒の動画なら試せるが、20秒になるとかなり待つ」

という感覚でした。


5. プロンプトはかなり効く

次に、もう少し具体的な指示を入れてみました。

例えば、

A young woman walking slowly through a quiet city street at sunset, cinematic

というプロンプトです。

これを生成すると、

  • 女性が登場する
  • 街を歩く
  • 夕方の雰囲気になる
  • シネマティックな映像になる

など、プロンプトの内容がかなり反映されました。

つまり、単純なテキスト→動画生成については、かなり素直に指示が効いている印象です。


6. もう少し複雑な指示を入れてみる

次に、複数の人物とカメラワークまで指定してみました。

使用したプロンプトは、概ね次のような内容です。

早朝の東京の街をさっそうと歩く5人の若い女性が、
正面から歩いてきて、とおりすぎる。
同時にカメラがパンして女性を追い、
その後ろ姿を追う。

結果は非常に興味深いものでした。

うまくいったところ

  • 女性たちが歩く
  • 東京らしい街の雰囲気が出る
  • 複数人が登場する
  • 正面から歩いてくる
  • カメラワークをある程度意識した映像になる

など、プロンプトの意図はかなり反映されました。

一方で、細かい部分では問題もありました。


7. 「東京の街」が「郊外の住宅地」になった

指定では「東京の街」としていました。

ところが生成された映像は、東京の繁華街というより、

郊外の住宅地に近い街並み

になりました。

これは画像・動画生成AIではよくある問題です。

「東京」という単語を入れただけで、必ずしも

  • 高層ビル
  • 繁華街
  • 日本の看板
  • 大量の人
  • 車
  • 駅前

といった具体的な東京のイメージになるわけではありません。

そこで、次のテストでは「東京」をさらに具体化しました。


8. 「5人」と指定しても5人とは限らない

もう一つ面白かったのが人物の人数です。

プロンプトでは、

5人の若い女性

と明確に指定していました。

MiniMax_H3_00002

ところが、最初の生成では、

4人

になりました。

動画生成AIでは、複数人物の人数を正確に維持することが難しい場合があります。

そこで次のテストでは、

Exactly five young adult women

と、人数をさらに強く指定しました。

すると、今度は、

5人が登場しました。

これはかなり重要な結果でした。

「5人」と書くよりも、

Exactly five

と明示した方が、今回のテストでは人数を維持しやすくなりました。


9. 東京の繁華街を具体的に指定する

次のプロンプトでは、東京の街をより具体的にしました。

Exactly five young adult women walking confidently toward the camera on a busy downtown Tokyo street in the early morning. Dense urban Tokyo scenery, tall buildings, Japanese storefronts, crosswalks and city traffic. All five women are clearly visible. Smooth cinematic camera movement, realistic live-action, natural walking motion.

今度は、

「東京の繁華街」

という指定はかなりうまく反映されました。

また、

5人

という人数指定も成功しました。

ここから、

「抽象的な指定より、具体的な視覚情報を並べた方がよい」

という傾向が見えてきました。


10. ところが、5人が車道を歩いてしまった

一方で、別の問題が発生しました。

「東京の繁華街を5人の女性が歩く」

という指示は反映されたのですが、

なんと女性たちが、

自動車道の真ん中を歩いていました。

これはかなり「AI動画らしい」結果です。

人間なら、

東京の繁華街を女性5人が歩く

と聞けば、普通は歩道を想像します。

しかしAIにとっては、

「街を歩く」=必ず歩道

ではありません。

そこで次のテストでは、

They stay on the sidewalk and never walk on the road.

のように、歩く場所を明示する必要があると判断しました。


11. 一番難しかったのはカメラワーク

今回もっとも苦戦したのが、

カメラの動き

です。

例えば、

カメラが後退しながら女性たちを追う

という指示を入れても、期待したほどカメラが動きませんでした。

さらに、

女性たちを追いながらパンする

という指示に対しては、

カメラが連続して動くのではなく、別のカットに切り替わったような映像

になることもありました。

また、

女性たちを通り過ぎた後、後ろ姿を追う

という指定については、

後ろ姿のシーン自体が生成されませんでした。

これは今回の実験でかなり重要なポイントでした。


12. MiniMax H3で分かったこと

ここまでの実験を整理すると、MiniMax H3では、

比較的うまくいった

  • 人物を歩かせる
  • 複数人物を登場させる
  • 「5人」という人数をある程度指定する
  • 東京の繁華街を具体的に指定する
  • 朝・夕方などの時間帯を指定する
  • 映画的な雰囲気を指定する
  • 自然な歩行をさせる

難しかった

  • 正確な人数を常に維持する
  • 「東京」の具体的な場所を想定通りにする
  • 歩道などの細かな位置関係
  • カメラを指定通りに動かす
  • パンや追従撮影
  • 一つの連続したカメラワーク
  • 前から後ろ姿へ自然につなぐ

という傾向が見えてきました。


13. 次はWan 2.2 5Bへ

ここまで試したところで、次のモデルとして、

Wan 2.2 5B

を試すことにしました。

ComfyUIには、

Wan 2.2 5Bビデオ生成

というテンプレートが用意されています。

これを選択すると、MiniMax H3とは異なるノード構成のワークフローが自動的に展開されました。

こちらにも、

  • Positive Prompt
  • Negative Prompt

の2つの入力欄があります。

今回は、MiniMax H3で問題になった部分を意識して、より具体的なプロンプトを設定しました。

Positive Prompt

Exactly five young adult women walking confidently together on the sidewalk of a busy downtown Tokyo street in the early morning. Dense urban Tokyo scenery with tall buildings, Japanese storefronts, traffic lights, crosswalks and city traffic in the background. All five women are clearly visible and walking side by side toward the camera. They stay on the sidewalk and never walk on the road. Realistic live-action, natural human walking motion, cinematic composition. The camera slowly moves backward in front of the five women, keeping them clearly framed throughout the shot. Continuous single shot, no cuts.

Negative Prompt

fewer than five people, more than five women, duplicate people, extra limbs, deformed hands, distorted faces, malformed bodies, people merging together, people disappearing, walking on the road, empty suburban street, rural scenery, low-rise residential neighborhood, static camera, camera cut, scene transition, sudden viewpoint change, unnatural walking, frozen people, jittery motion, blurry faces, cartoon, anime, illustration, CGI

MiniMax H3で発生した問題を、できるだけNegative Promptにも反映させています。


14. まずは5秒動画で比較する

Wan 2.2 5Bのワークフローでは、

長さ:121

FPS:24

となっています。

計算すると、

121 ÷ 24 = 5.04秒

です。

したがって、今回は実質的に約5秒の動画としてテストすることにしました。

いきなり20秒動画を生成すると、今回の環境ではかなりの時間がかかる可能性があります。

まず5秒で、

  • 5人になるか
  • 東京の繁華街になるか
  • 歩道を歩くか
  • 正面から歩いてくるか
  • 自然に歩くか
  • カメラが後退するか
  • ワンカットになるか

を確認します。


まとめ

今回、初めて本格的にComfyUIで動画生成を試してみました。

第一印象としては、

「思った以上にプロンプトが効く。しかし、細かな演出指定になると急に難しくなる」

というものでした。

「女性が歩く」

という程度なら比較的簡単です。

しかし、

5人の女性が
東京の繁華街の歩道を
正面から歩いてきて、
カメラが後退しながら追い、
そのまま通り過ぎ、
後ろ姿を追い続ける

となると、一気に難易度が上がります。

特に、

「何を映すか」

と

「カメラをどう動かすか」

は別の問題として考えた方がよさそうです。

今回のMiniMax H3の実験では、人物や背景についてはかなり指示できましたが、カメラワークについては思い通りにならない部分がありました。

そこで次回は、Wan 2.2 5Bがこの部分をどこまで改善できるのかを試してみます。

同じような内容を生成して比較すれば、

MiniMax H3とWan 2.2 5Bでは、どちらが「人物」「背景」「人数」「カメラワーク」を得意としているのか

も見えてくるはずです。

ComfyUIでのローカル動画生成は、まだ始めたばかりです。

次回はWan 2.2 5Bの5秒動画から、実際の生成結果の詳細を検証してみたいと思います。


関連記事