2026年秋LLMはここまで来た。
ローカルLLMに手足をつける?! Claude Desktopのようなコード開発支援ツールに仕立ててみる。 Visual Studio Code + Clineで試してみて、重くてほぼ使い物にならなかったので半分かきらめていたが、自分で作ってみたほうが軽くできるのでは?ということで試してみた。
2026年秋、ローカルで動くLLMは「ただのチャット」から、かなり実用的な「作業者」に近づいてきた。
特にGoogleのGemma 4シリーズ(例: gemma4:26b、MoEでアクティブパラメータ約4B)は、ツール呼び出し(function calling)を標準でサポートし、長コンテキスト(大きいサイズで256K)、コーディング能力、マルチモーダル対応を備えている。Ollamaやllama.cpp、LM Studio経由で、比較的手軽に動かせるサイズ感だ。
ここに「手足」を付ける——つまり、ファイルの読み書きやPython実行などのツールを与えて、モデル自身にコードを書いて実行させるループを組むと、Claude DesktopやClaude Code、OpenCodeのようなコーディング支援エージェントに近い振る舞いが、ローカルでも再現できる。
実際に簡単な仕組みを組んで試してみたところ、想像以上にすんなり動いた。
簡単な実験:ランダムCSV生成とソート
使用モデルは gemma4:26b。ツールとして「ファイルを書く(write_file)」と「Pythonを実行する(run_python)」を用意しただけの、かなり素朴なエージェントループだ。
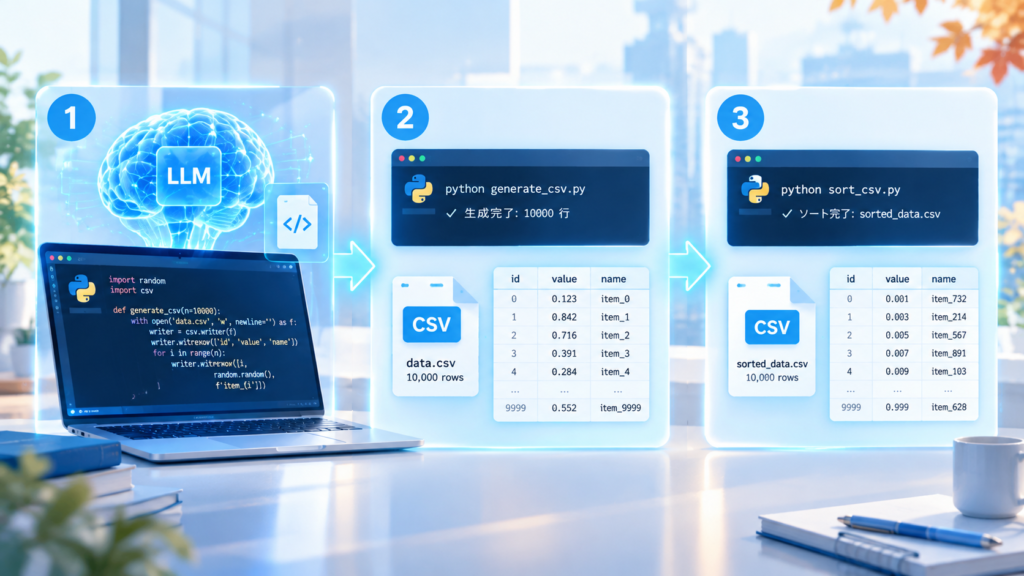
依頼1:ランダムな2列CSVを1万行作る
ユーザーの指示:
2項目の値の、csvファイルを作成するpythonコードを作成し実行してください。
コード名 randm.py、生成するファイル名 rand2026.csv。
10025,44557
10256,55455
…
というような、2元の整数の組のファイルです。
それぞれの数字は 1~99999999 の間の整数でランダム。これを1万行書き出す。
モデルはコードを書き、ファイル名を一度間違えたものの自分で修正し、実行した。結果:
Successfully created rand2026.csv with 10000 rows.中身を確認したところ、範囲内のランダムな整数ペアが1万行、妥当に生成されていた。
依頼2:1列目でソートして別ファイルに出力
続けて:
rand2026.csv の1項目目の数値で、行ソートするプログラム(sort_gemma4.py)を作成し rgema.csv にソート結果を出力してください。
モデルは csv モジュールを使い、1列目を整数として比較してソートするコードを書き、実行。
Successfully sorted rand2026.csv and saved to rgema.csvソート結果も正しい内容になっていた。一連の作業はおよそ10分程度で完了。
モデルが「コードを書いて→実行して→結果を確認して次へ進む」という流れを、ほぼ自律的にこなした。最初はファイル名を少し間違えたが、すぐに直している。これは「手足」がちゃんと機能している証拠だ。
なぜこれが「厳しい」のか
この程度の仕掛けは、ツール呼び出しをサポートしているモデル(Gemma 4、Qwen系、Llama系など)と、Ollamaなどのランタイムがあれば、比較的短時間で組める。
すでにオープンソースのコーディングエージェントは充実している:
- OpenCode:ターミナル中心、75以上のプロバイダ対応、ローカルモデルも可能。Claude Codeに近い体験をオープンに。
- Goose(Block発、Apache-2.0):MCPベースの拡張性が高く、完全オフライン運用も可能。
- Aider:Git統合が強く、軽量で小さなモデルでも動きやすい。
- Cline や各種MCPサーバー:Claude Desktopにファイルシステムやターミナル、デスクトップ操作を追加する仕組みが成熟している。
Ollamaには ollama launch claude --model gemma4:... のような起動支援もあり、Claude Code自体をローカルモデルで動かす道も広がっている。MCP(Model Context Protocol)経由でファイル操作やコマンド実行を安全に(あるいは許可制で)行える環境が整いつつある。
つまり、「それなりに能力がある人が作ったら、すぐにローカルLLMでも高度なことができる」状態に、すでになっている。コードを書いて実行し、結果を見て次の手を打つ——このループさえ回せれば、CSV生成のような単純作業だけでなく、より複雑なデータ処理やスクリプト作成、反復的な検証もこなせる。
現実的な限界と注意点
もちろん、クラウドの最上位モデル(ClaudeやGPT系の最新)と比べると差はある。
- ツール呼び出しの安定性や、長いコンテキストでの一貫性はまだモデル依存。
- 速度はハードウェア次第。GPU/Apple Siliconでそこそこ速くても、複雑な多段思考は時間がかかる。
- コード実行は強力な分、サンドボックスや許可確認が必須。不用意に広い権限を与えるとリスクがある。
- 大規模なコードベースの理解や、長期的なプロジェクト管理では、まだクラウド側に分があることが多い。
それでも、「自分のマシンだけで、データを外に出さずに、コストを気にせず作業できる」価値は大きい。特に機密データやオフライン環境では明確な優位性がある。
おわりに
2026年秋のローカルLLMは、単に「動く」だけでなく、「手足を付ければ実用的な作業者になれる」段階に来ている。
今回の実験はごく単純なものだが、それで十分な結果が出たことが重要だ。OpenCodeやGoose、MCP対応のツールを組み合わせ、Gemma 4やQwen系のモデルを載せるだけで、Claude Desktop的な体験のかなりの部分をローカルで再現できる。
これからの競争は、「モデル単体の賢さ」だけでなく、「いかに適切な手足(ツール)と安全な実行環境を組み合わせるか」に移っていくのだろう。ローカルでここまでできるなら、クラウドとの使い分けやハイブリッドな運用も、より現実的になってきた。
参考にした操作の記録は、ランダムCSVもソート結果も妥当な内容で、一連の作業が短時間で完了したことを示している。少し複雑な実装でも、同じ仕組みで試す価値は十分ありそうだ。
しかし、ここまでくると悪用も容易にできそうな状態になっていることがよく分かる。攻めと守りでは、攻めのほうが有利である。わずかでも穴を見つければよいからだ。守る側は穴がないように作り上げる必要があるが、それはなかなか難しい。
破られたことを早期に検知し、被害を抑え、いかに早く復旧するかという世界に変わっていくかもしれない。ただしそれは、一通りしっかり守る仕掛けを用意してからの話だろう。
似たような話は昨今の水害にも通じるかもしれない。少しでも穴があると堤防は崩壊する。いかに避けにくいか、早く復旧するかが重要だが、同じことが起こらないよう、最適なコストで復旧・強化していくことが求められる。